
データベーススペシャリスト 2013年 午後1 問03
SQLの設計及び性能に関する次の記述を読んで、設問1〜3に答えよ。
全国の法人及び個人に事務用品をインターネット販売しているE社は、RDBMSを用いた注文システムを運用している。 注文システムの運用は、情報システム部のFさんが担当している。
〔RDBMSのアクセス経路に関する主な仕様〕
1.SQL文の実行ごとに、アクセス経路が決められる。
2.各テーブルの定義情報、及び統計更新処理が収集する統計情報、例えば、各テーブルの行数及び列値の個数は、システムカタログに記録される。
3.各テーブルの列値の個数は、統計更新処理時点の各列に存在する異なる値の個数である。
4.アクセス経路は、各テーブルの統計情報及び索引定義情報に基づき、RDBMSのオプティマイザによって表探索又は索引探索のいずれかに決められる。
5.表探索は、索引を使わずに先頭のデータページから全行を探索する。索引探索は,WHERE 句中の述語に適した索引によって行を絞り込んでから、データページ中の行を探索する。 SQL文の実行によって取得される行を、結果行と呼ぶ。
6.索引探索に使われる索引は、1テーブル当たり1個である。 索引探索に使える列は索引キーを構成する先頭の列として定義され、かつ、述語の比較演算子は=、<、>、<=、>= のいずれかでなければならない。
7.オプティマイザは、アクセス経路を決めるとき、次のように仮定している。
(1) 統計情報は、テーブルの最新状態を反映したものである。
(2) 列値当たりの行数は均等である。
(3) 行数がゼロの場合、表探索が最適である。
〔販売商品の概要〕
販売する商品は、主にオフィス又は家庭で使用される事務用品である。 販売する商品は、2階層のカテゴリによって分類される。 カテゴリの例を次に示す。
(1) カテゴリ1は、筆記具、用紙などの大分類(100種類)を表す。
(2) カテゴリ1が筆記具の場合、カテゴリ2は鉛筆、ボールペンなどである。
〔テーブルの構造〕
注文処理に使用する主なテーブルの構造を図1に、主な列の意味を表1に示す。
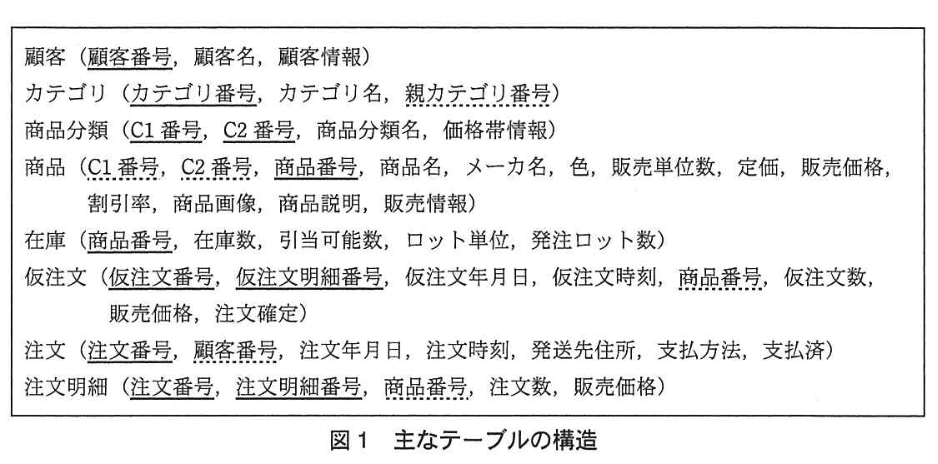
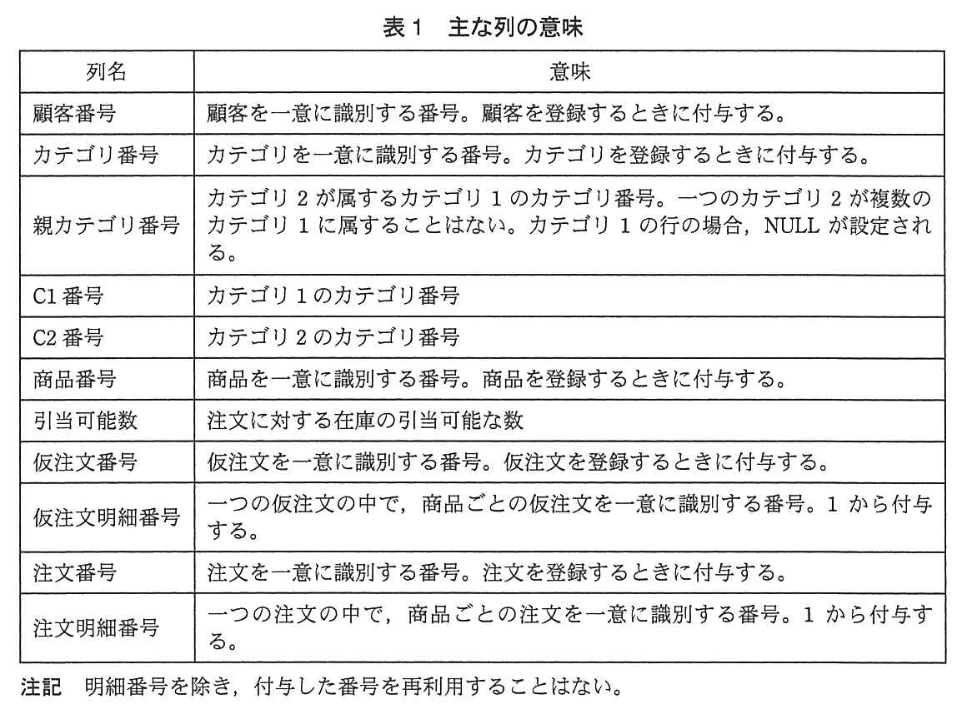
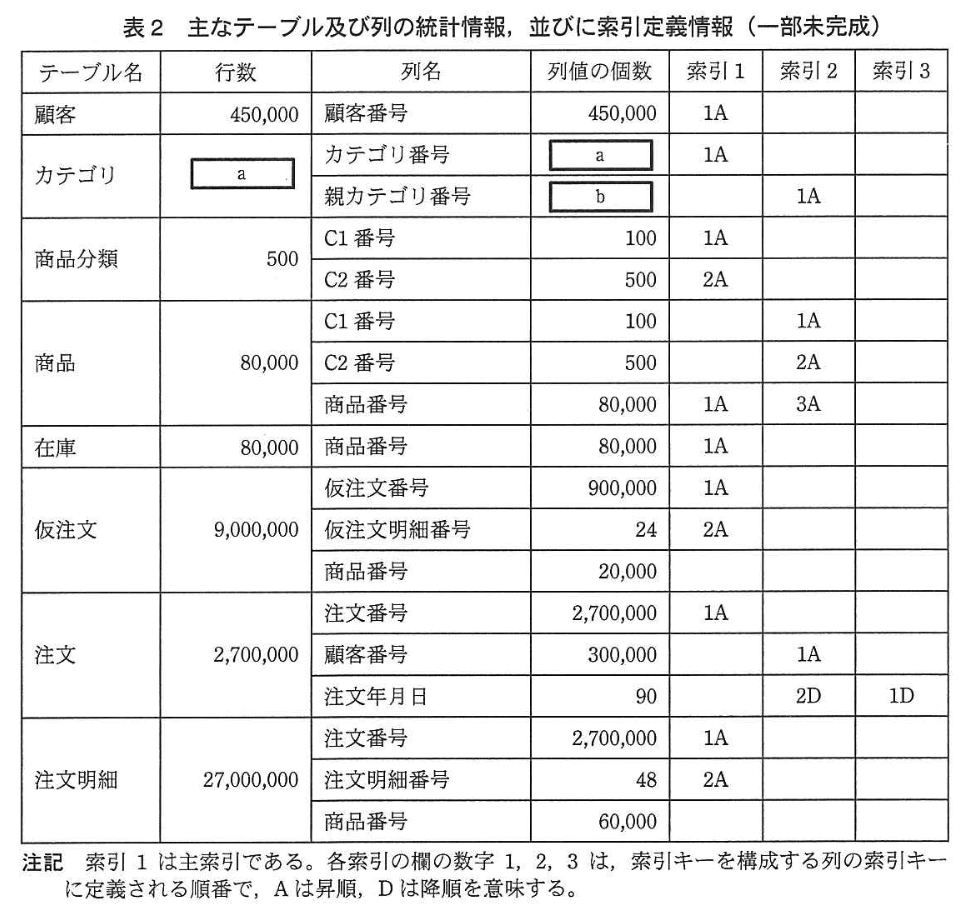
現在、“仮注文” テーブルのデータ保存期間を1か月間、また“注文” テーブル及び“注文明細”テーブルのデータ保存期間を3か月間として、毎月の末日に統計更新処理を行い、その後に不要な行を削除する削除処理を行っている。 2013年3月末日に統計更新処理を行ったときにシステムカタログに記録された主なテーブル及び列の統計情報、並びに索引定義情報を、表2に示す。
〔注文処理の概要〕
1.注文システムによる処理
注文システムは、24時間オンライン稼働している。 注文システムによる処理の概要は、次のとおりである。
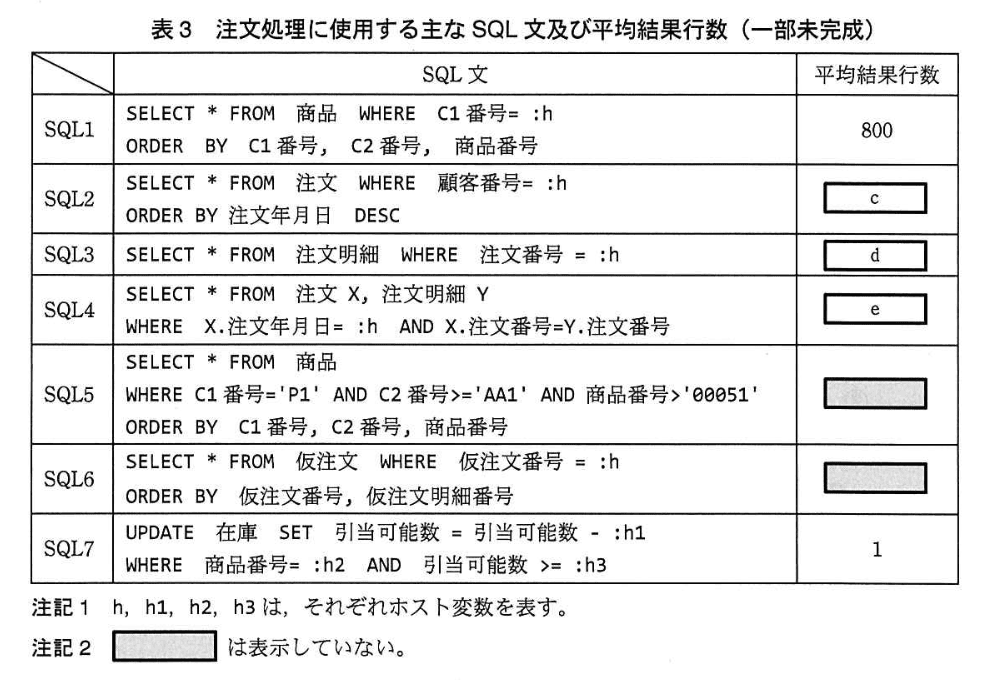
なお、文中の(SQL1)、(SQL6)、(SQL7)は、表3のSQL1, SQL6, SQL7がそれぞれ実行されることを示す。
(1) 商品照会
① 顧客は、インターネットから注文処理を呼び出し、メニューを表示させる。
② 顧客は、メニューから商品照会を選んで、商品のカテゴリ1のカテゴリ名の一覧を表示させ、そのうちの一つを検索条件として選択する。
③ 注文システムは、検索条件に合致する商品の情報 (商品名、定価、販売価格、割引率、商品画像など)を“商品” テーブルから取得し (SQL1)、商品一覧画面に最大10商品を表示する。
④ 顧客が次画面ボタンをクリックすると、次の10商品が表示される。
(2) 仮注文入力
① 顧客は、商品一覧画面の1個又は複数個の商品に注文数を入力する。
② 注文システムは、“在庫” テーブルを調べ、引当可能な商品ならば、“仮注文”テーブルに1行を追加する。 注文システムは、1 画面の処理ごとにCOMMIT文を発行する。
③ 顧客は、仮注文入力を終えると、発送・支払に必要な顧客名、発送先住所などの情報を入力し、注文内容を注文確認画面で確認してから注文確定ボタンをクリックする。
④ 仮注文入力が注文確定とならなかった場合、注文システムは注文処理を終了させて、“仮注文” テーブルから該当行を削除し、COMMIT文を発行する。
(3) 注文確定
① 仮注文入力が注文確定となったとき、注文システムは、“注文” テーブルに 1行を追加する。 “仮注文” テーブルから主キー順に1行ずつ取得しながら(SQL6)、注文確定の列に‘Y'を設定し、かつ、商品ごとに“在庫” テーブルの引当可能数の列を更新し (SQL7)、“注文明細” テーブルに1行を追加する。これを商品数だけ繰り返し、最後に COMMIT 文を発行する (在庫引当ができなかった場合の処理については、省略)。
②その後、注文の支払が完了したとき、該当する “注文” テーブルの行の支払済の列に‘Y'を設定する。
2.注文処理に使用する主なSQL文
注文処理に使用する主なSQL文を、表3に示す。 表3の平均結果行数は、表2の統計情報とオプティマイザの仮定に基づいて計算される推定行数である。また、表3のSQL1のホスト変数に ‘P1' を指定した場合のSQL1の結果行を、表4に示す。
 ↩設問1(1) ↩設問1(2) ↩設問1(3) ↩設問2(1) ↩設問3(1)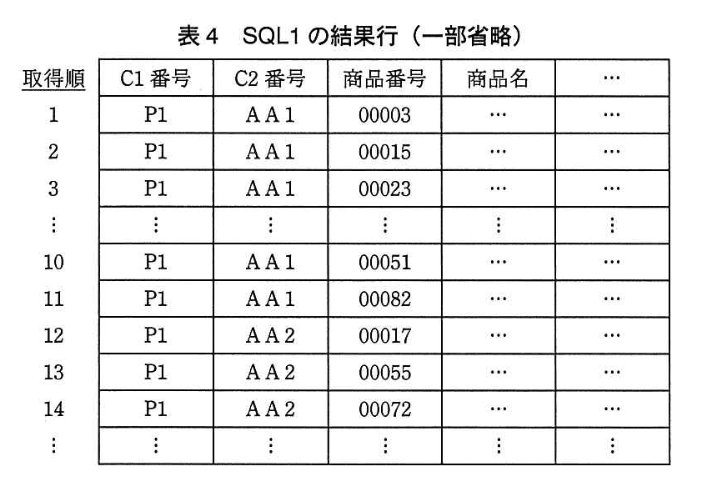
〔テーブルの保守の見直し〕
Fさんは、毎月の末日に行っていたテーブルの保守を、次のように日次処理として見直すことにした。
なお、行の削除には DELETE文を用いる 。
(1) 注文の少ない毎朝4時から4時30分までの間、仕掛り中の注文処理を終わらせ、仕掛り中の注文処理がないことを確認した後、注文処理を一時的に停止する。
(2) “仮注文”テーブルの不要な行(注文確定の列が ‘Y' の行) を削除する。
(3) “注文”テーブルの不要な行(保存期間を超過し、かつ、支払済の列が‘Y'の行)、及び“注文明細” テーブルの不要な行を削除する。
(4) (2) 、(3) の処理を行った後、テーブルを再編成し、次に統計更新処理を行う。
(5) 注文処理を再開する。
〔問題点の指摘〕
Fさんの上司であるG氏は、注文処理とテーブルの保守の見直しについて、次の問題点を指摘した。
① 商品一覧画面の表示では、SQL1を実行したときの平均結果行数が多い。 全結果行を取得してから表示するのではなく、1画面(10行) 分を取得して、表示した方がよい。 ただし、次の1画面分を取得するとき、最初から取得し直さないようにすべきである。
② Fさんによる〔テーブルの保守の見直し〕では、アクセス経路が索引探索から表探索に変わるSQLがある。 その結果、注文確定の際に、そのSQLを実行するたびに処理時間が長くなることが懸念される。
(1)
表2の“商品分類” テーブルの統計情報を基に、表2中の(a)、(b)に入れる適切な数値を答えよ。
模範解答
a:600
b:100
解説
解答の論理構成
- 表示された統計情報を確認
表2より
• “商品分類” の行数は 500
• “C1番号” の列値の個数は 100
• “C2番号” の列値の個数は 500 - カテゴリ数の読み替え
〔販売商品の概要〕には「カテゴリ1は … (100種類)」と明示され、表2の “C1番号100” と一致する。
よって
• カテゴリ1 = 100種類
• カテゴリ2 = 500種類 - “カテゴリ” テーブルの構造
問題文より “カテゴリ” テーブルにはカテゴリ1とカテゴリ2の両方が格納される(カテゴリ1行では親カテゴリ番号がNULL)。したがって
行数(=カテゴリ番号の列値の個数)=カテゴリ1+カテゴリ2
→ (a) = 600 - 親カテゴリ番号の列値個数
親カテゴリ番号が入るのはカテゴリ2行のみ。親はカテゴリ1の番号なのでdistinct値はカテゴリ1の種類数と同じ
→ (b) = 100
誤りやすいポイント
- “商品分類” の行数 500 をそのまま (a) と誤記する
- 親カテゴリ番号にNULLが含まれるかどうかを見落とし、(b) を 101 などにしてしまう
- “C2番号500” を (b) に入れてしまう(親と子を取り違え)
FAQ
Q: なぜ “商品分類” の行数がカテゴリ2の種類数と決めつけられるのですか?
A: 表2で “C2番号” の列値個数が行数と同じ 500 であり、1行に1つのカテゴリ2が対応していることが分かるためです。
A: 表2で “C2番号” の列値個数が行数と同じ 500 であり、1行に1つのカテゴリ2が対応していることが分かるためです。
Q: 親カテゴリ番号がNULLの行はdistinct個数にカウントされますか?
A: NULLは「値が不明」扱いでdistinct個数には含まれません。したがってカテゴリ1分の 100 だけがdistinctになります。
A: NULLは「値が不明」扱いでdistinct個数には含まれません。したがってカテゴリ1分の 100 だけがdistinctになります。
Q: 行数と列値個数が同じでも索引があるとは限らないのですか?
A: はい。表2では索引欄に “1A” がある場合のみ主キー索引が明示されており、行数=列値個数は一意性を示す統計情報です。
A: はい。表2では索引欄に “1A” がある場合のみ主キー索引が明示されており、行数=列値個数は一意性を示す統計情報です。
関連キーワード: 正規化、統計情報、オプティマイザ、親子関係

模範解答
c:9
d:10
e:300,000
解説
解答の論理構成
- オプティマイザの仮定
問題文に「(2)列値当たりの行数は均等である。」とあるため、平均値は
総行数 ÷ 列値個数 で求められる。 - (c) の算出
SQL2 は 「SELECT * FROM 注文 WHERE 顧客番号 = :h」。
注文テーブル行数は 2,700,000、顧客番号の列値個数は 300,000。
よって2,700,000 ÷ 300,000 = 9。 - (d) の算出
SQL3 は 「SELECT * FROM 注文明細 WHERE 注文番号 = :h」。
注文明細テーブル行数は 27,000,000、注文番号の列値個数は 2,700,000。
よって27,000,000 ÷ 2,700,000 = 10。 - (e) の算出
SQL4 は 「SELECT * FROM 注文 X, 注文明細 Y WHERE X.注文年月日 = :h AND X.注文番号 = Y.注文番号」。
① 注文テーブルにおける 注文年月日 列値個数は 90。
2,700,000 ÷ 90 = 30,000 … 指定日付の注文行数
② 1件の注文に対する注文明細は平均10行(上記 (d))。
③ 結合後の行数は30,000 × 10 = 300,000。
誤りやすいポイント
- 注文年月日の列値個数 90 の読み落としにより、(e) を30,000と誤答しがちです。
- (d) の分母を列値個数ではなくテーブル行数で割って0.1としてしまう計算ミス。
- オプティマイザの仮定「均等分布」を忘れ、実際の偏りを想像して平均でない数字を書くケース。
FAQ
Q: 実システムでは行分布が偏ることが多いですが、試験ではなぜ均等分布で計算するのですか?
A: 問題文に「列値当たりの行数は均等である」とオプティマイザの仮定が明示されており、それに基づいて平均結果行数を算出する設計になっているためです。
A: 問題文に「列値当たりの行数は均等である」とオプティマイザの仮定が明示されており、それに基づいて平均結果行数を算出する設計になっているためです。
Q: SQL4の結果行数は結合順序や索引有無で変わりますか?
A: アクセス経路が変わっても、平均結果行数は論理的に導かれる行数に依存します。計算はテーブル統計と均等分布の仮定だけで決まるため、索引の有無は影響しません。
A: アクセス経路が変わっても、平均結果行数は論理的に導かれる行数に依存します。計算はテーブル統計と均等分布の仮定だけで決まるため、索引の有無は影響しません。
Q: 他の列でフィルタする場合も同じ計算方法ですか?
A: はい。列の値個数が分かれば「対象列の値個数で割る → 行数を求める」を基本にして平均結果行数を算出できます。
A: はい。列の値個数が分かれば「対象列の値個数で割る → 行数を求める」を基本にして平均結果行数を算出できます。
関連キーワード: 統計情報、均等分布仮定、オプティマイザ、平均結果行数、結合行数
(3)
表2の統計情報を基に、“注文明細” テーブルについて、一つの注文で発生した最大明細行数を答えよ。
模範解答
最大48行
解説
解答の論理構成
- 表2から事実を抜き出す。
- “注文明細”–“注文明細番号” の「列値の個数」は “48” である。
- 表1で列の性質を確認する。
- “注文明細番号” は「一つの注文の中で、商品ごとの注文を一意に識別する番号。1から付与する。」
- 以上より “注文明細番号” は1注文につき1〜Nの連番を取り、「列値の個数」48はその連番の取り得る最大値=1注文当たりの最大行数を示す。
- 従って求める最大明細行数は 48行 となる。
誤りやすいポイント
- 「列値の個数」がテーブル全体のdistinct値だと早合点し、注文単位の上限と結び付けられない。
- 行数27,000,000と混同し、平均や最大を誤って算出する。
- “注文明細番号” ではなく “注文番号” の列値個数2,700,000を見てしまう。
FAQ
Q: 「列値の個数」は常にテーブル全体のdistinct値ですか?
A: 表2の定義は「統計更新処理時点の各列に存在する異なる値の個数」です。ただし業務ルールで列の取り得る値域が限定される場合、その値が意味的に上限を示すことがあります。本設問はその代表例です。
A: 表2の定義は「統計更新処理時点の各列に存在する異なる値の個数」です。ただし業務ルールで列の取り得る値域が限定される場合、その値が意味的に上限を示すことがあります。本設問はその代表例です。
Q: 実運用で48行を超える場合はないのですか?
A: 表1の説明どおり「1から付与する」連番であり、再利用しない制約は注文明細番号には記載されていませんが、列値の個数48が統計情報として得られているため、少なくとも統計更新時点では48が上限です。業務変更で列値が増えれば統計情報も更新されます。
A: 表1の説明どおり「1から付与する」連番であり、再利用しない制約は注文明細番号には記載されていませんが、列値の個数48が統計情報として得られているため、少なくとも統計更新時点では48が上限です。業務変更で列値が増えれば統計情報も更新されます。
Q: 行数27,000,000と最大48行はどのように関連しますか?
A: 27,000,000はテーブル全体の行数、48は1注文(“注文番号”)に属する最大行数です。総行数 ÷ 最大行数 ≒ 最大注文件数を粗く見積もる指標にもなります。
A: 27,000,000はテーブル全体の行数、48は1注文(“注文番号”)に属する最大行数です。総行数 ÷ 最大行数 ≒ 最大注文件数を粗く見積もる指標にもなります。
関連キーワード: 統計情報、列値個数、連番、主キー、データ設計
設問2:〔問題点の指摘〕 の ①への対応について(1)、(2)に答えよ。
問題文を見る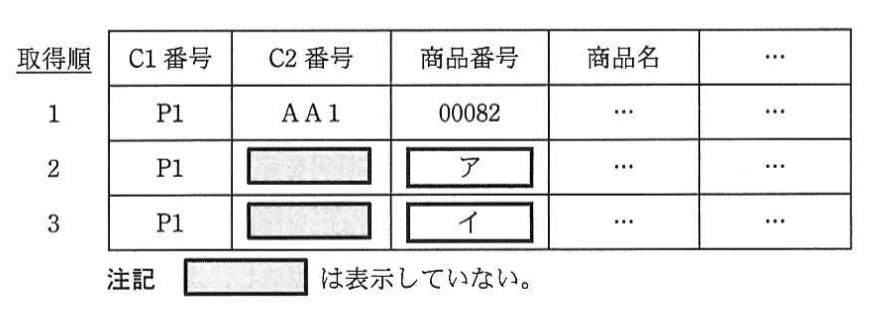
模範解答
ア:00055
イ:00072
解説
解答の導き方
-
表4の取得順を確認します。表4の10行目はC1番号 = P1、 C2番号 = AA1、 商品番号 = 00051です。したがって「次の1画面分」を取得する起点は(P1, AA1, 00051)であることが分かります。
-
表3のSQL5に注目します。表3のSQL5は「SELECT * FROM 商品 WHERE C1番号='P1' AND C2番号>='AA1' AND 商品番号>'00051' ORDER BY C1番号, C2番号, 商品番号」です。C1番号とC2番号の条件は11行目以降の行をすべて満たしますが、商品番号の条件「商品番号>'00051'」は列単独で比較されるため、C2番号が 'AA2' 以降の行でも商品番号が '00051' 以下の行は除外されてしまいます。
-
表4で11行目以降の順を並べると、11行目 = 商品番号00082(C2 = AA1)、12行目 = 商品番号00017(C2 = AA2)、13行目 = 商品番号00055(C2 = AA2)、14行目 = 商品番号00072(C2 = AA2)となっています。
-
ここでSQL5の「商品番号 > '00051'」を適用すると、00017 は除外されます。残る行は 00082、00055、00072 です。これを ORDER BY C1番号、C2番号、商品番号 の順で並べると、C1/C2 の順序(P1, AA1 → P1, AA2)に従って 00082、00055、00072 となります。
-
よって、図示の取得順の2行目、3行目に入る商品番号は次のとおりです。
(ア) 00055
(イ) 00072
誤りやすいポイント
- WHERE の複数列に対する単純な比較(例:C1番号='P1' AND C2番号>='AA1' AND 商品番号>'00051')を「(C1, C2, 商品番号) のタプル比較」と混同する。ページングで「前回の最後の行より後」を取るにはタプル比較または OR を用いた条件が必要になる場合が多いです。
- ページング処理で「次のページ」を取るとき、どの列でフィルタされているか(ここでは商品番号)をまず確認しないと、思わぬ行が除外されたり含まれたりすることがあります。
- ORDER BY と WHERE の組み合わせを意識しないと、フィルタ後の並べ替えで期待と異なる順序になることがあります。
FAQ
Q: なぜ00017が返ってこないのですか?
A: 表3のSQL5に「商品番号 > '00051'」という条件があるため、商品番号が '00051' 以下の00017は除外されます。
A: 表3のSQL5に「商品番号 > '00051'」という条件があるため、商品番号が '00051' 以下の00017は除外されます。
Q: 「次のページ」を正しく取得する WHERE 句はどう書けばよいですか?
A: 一般的にはタプルの大きさ比較を表現するか、等号と不等号を組み合わせた OR 条件で表します。例(SQLの記法が使える場合): WHERE (C1番号 > 'P1') OR (C1番号 = 'P1' AND C2番号 > 'AA1') OR (C1番号 = 'P1' AND C2番号 = 'AA1' AND 商品番号 > '00051') ORDER BY C1番号, C2番号, 商品番号 これにより (C1, C2, 商品番号) が ('P1','AA1','00051') より後のタプルを正しく取得できます。
A: 一般的にはタプルの大きさ比較を表現するか、等号と不等号を組み合わせた OR 条件で表します。例(SQLの記法が使える場合): WHERE (C1番号 > 'P1') OR (C1番号 = 'P1' AND C2番号 > 'AA1') OR (C1番号 = 'P1' AND C2番号 = 'AA1' AND 商品番号 > '00051') ORDER BY C1番号, C2番号, 商品番号 これにより (C1, C2, 商品番号) が ('P1','AA1','00051') より後のタプルを正しく取得できます。
Q: OFFSETを使う方法と比べてどちらが良いですか?
A: 小さいオフセットではOFFSETで簡単に実装できますが、大きなオフセットでは性能が悪くなることがあります。大量データでのページングは上記のキーセット(タプル)方式が一般に効率的です。
A: 小さいオフセットではOFFSETで簡単に実装できますが、大きなオフセットでは性能が悪くなることがあります。大量データでのページングは上記のキーセット(タプル)方式が一般に効率的です。
関連キーワード: ページング、ORDER BY、タプル比較、索引探索、複合条件検索
設問2:〔問題点の指摘〕 の ①への対応について(1)、(2)に答えよ。
問題文を見る(2)
(1)の結果はFさんの目的とは異なるので,SQL5を1画面目の情報を使って、次のように修正した。(ウ)~(オ)に入れる適切な字句を答えよ。
なお、(ウ)~(オ)に入れる述語はそれぞれ一つとする。(ウ、エは順不同)
SELECT * FROM 商品 WHERE C1番号='P1' AND
( ( (ウ) AND (エ) ) OR (オ) )
ORDER BY C1番号, C2番号, 商品番号
模範解答
ウ:C2番号 = 'AA1'
エ:商品番号 > '00051'
オ:C2番号 > 'AA1'
解説
解答の導き方
-
目的を確認する
本文には「1画面分を取得して、表示した方がよい。 ただし、 次の1画面分を取得するとき、最初から取得し直さないようにすべきである。」とあり、これは現在表示している最後の行の次から続けて取得する(ページネーションのためのカーソル条件を用いる)ことを求めています。 -
ソート順を確認する
表3のSQL1/SQL5に「ORDER BY C1番号、 C2番号、 商品番号」とあるため、行の並びはまずC1番号で昇順に、同一C1の中でC2番号、さらに同一C1・C2の中で商品番号の順に並びます(辞書式=レキシコグラフィック順)。 -
1ページ目の末尾の値を確認する
表4を見ると、SQL1(ホスト変数に 'P1')の取得順で10行目はC1番号 = 'P1'、C2番号 = 'AA1'、商品番号 = '00051' で終わっています。11行目はC1='P1'、C2='AA1'、商品番号='00082'、12行目はC1='P1'、C2='AA2'、商品番号='00017' となっています。これが次に取得すべき行の具体例です。 -
次ページ開始条件を論理的に組み立てる
ソート順がC1 → C2 → 商品番号 なので、「C1番号='P1' の範囲内で、(同一C2で商品番号が直前より大きい) または (C2が直前のC2より大きい)」という条件が、直前の行の次から取得するための正しい条件になります。直前の行が ( 'P1', 'AA1', '00051' ) なので、具体的には (C2番号 = 'AA1' AND 商品番号 > '00051') OR (C2番号 > 'AA1') となります。 -
問の穴埋め箇所への対応
問題のSQLは SELECT * FROM 商品 WHERE C1番号='P1' AND(((ウ)AND(エ))OR(オ)) ORDER BY C1番号, C2番号, 商品番号
ですから、(ウ),(エ),(オ) はそれぞれ次のようになります((ウ)と(エ)の順序は指定されていません)。 ウ:C2番号 = 'AA1'
エ:商品番号 > '00051'
オ:C2番号 > 'AA1' -
完成形SQL(参考)
SELECT * FROM 商品 WHERE C1番号='P1' AND ((C2番号 = 'AA1' AND 商品番号 > '00051') OR (C2番号 > 'AA1')) ORDER BY C1番号, C2番号, 商品番号
誤りやすいポイント
- C1番号='P1' を省略してしまう:ソートの先頭列であるC1番号を固定しないと、他のC1の行まで混ざってしまう可能性があります。
- 商品番号 > '00051' のみを使う:これでは同一C2以外の行で商品番号が大きい行だけを拾い、C2が増えたが商品番号が小さい行(例:AA2,00017)は抜け落ちます。
- 条件を (C2番号 >= 'AA1' AND 商品番号 > '00051') とする誤り:AA2のようにC2 > 'AA1' かつ 商品番号 ≤ '00051' の行を除外してしまい、結果として行を欠落させます。
- OR と AND の結合を誤って括弧付けをしない:論理結合の優先順位を誤ると、前ページの行まで再取得したり、欠落が生じます。必ず「同一C2かどうか」を先に判定してから商品番号を比較する形にすること。
- 「行値比較(タプル比較)」の可否を安易に期待する:環境によっては書けても、試験・運用上は分解した式の方が移植性とインデックス活用の観点で安全です。
FAQ
Q: 複合列をまとめて比較するように WHERE (C1番号, C2番号, 商品番号) > ('P1','AA1','00051') と書けますか?
A: 多くのRDBMSやSQL仕様は行値比較(タプル比較)をサポートしており、その書き方は短く直感的です。ただし、実装や最適化の違いでインデックス利用や挙動が異なる場合があるため、本問のような試験や移植性を重視する実装では分解した論理式(今回のような AND/OR の組合せ)を用いるのが確実です。
A: 多くのRDBMSやSQL仕様は行値比較(タプル比較)をサポートしており、その書き方は短く直感的です。ただし、実装や最適化の違いでインデックス利用や挙動が異なる場合があるため、本問のような試験や移植性を重視する実装では分解した論理式(今回のような AND/OR の組合せ)を用いるのが確実です。
Q: なぜ (C2番号 > 'AA1' AND 商品番号 > '00051') ではだめなのですか?
A: この条件は「C2がAA1より大きく、かつ商品番号も00051より大きい行」を要求します。したがって、C2='AA2' かつ 商品番号='00017' のようにC2が増えていても商品番号が小さい行を除外してしまい、本来取得すべき行を取りこぼします。
A: この条件は「C2がAA1より大きく、かつ商品番号も00051より大きい行」を要求します。したがって、C2='AA2' かつ 商品番号='00017' のようにC2が増えていても商品番号が小さい行を除外してしまい、本来取得すべき行を取りこぼします。
Q: この方式はインデックスを活かせますか?
A: インデックスが (C1番号, C2番号, 商品番号) のように先頭から順にキーを持っている場合、C1に対する等値、続くC2に対する等値または範囲、さらに商品番号に対する範囲という形でインデックス範囲スキャンが可能になり、効率的にページングできます。
A: インデックスが (C1番号, C2番号, 商品番号) のように先頭から順にキーを持っている場合、C1に対する等値、続くC2に対する等値または範囲、さらに商品番号に対する範囲という形でインデックス範囲スキャンが可能になり、効率的にページングできます。
関連キーワード: ページネーション、辞書式比較、行値比較、インデックス範囲スキャン、レンジ条件
設問3:〔問題点の指摘〕の②への対応について、(1)〜(3)に答えよ。
問題文を見る(1)
アクセス経路が索引探索から表探索に変わるSQLを、表3のSQL1〜SQL7の中から一つ答え、アクセス経路が変わる理由を、40字以内で述べよ。
模範解答
SQL:SQL6
理由:
・ “仮注文”テーブルの全行が削除された直後に統計更新処理を行ったから
・ “仮注文”テーブルの統計情報の行数がゼロになるから
解説
解答の論理構成
- 削除対象とタイミング
- 〔テーブルの保守の見直し〕(2)
「“仮注文”テーブルの不要な行(注文確定の列が ‘Y' の行) を削除する。」 - 同(1) で「仕掛り中の注文処理がないことを確認」してから実施しているため、仮注文の残存行は実質0行。
- 〔テーブルの保守の見直し〕(2)
- 統計情報の更新
- 同(4)
「…テーブルを再編成し、次に統計更新処理を行う。」 - 仕様1,2により統計更新処理の結果がシステムカタログへ登録される。
- 同(4)
- オプティマイザの判断基準
- 仕様7-(3)
「行数がゼロの場合、表探索が最適である。」
- 仕様7-(3)
- 対象SQLの特定
-
SQL6
sql SELECT * FROM 仮注文 WHERE 仮注文番号 = :h ORDER BY 仮注文番号, 仮注文明細番号 -
インデックスは表2で “仮注文” の「仮注文番号」に 1A が定義されているが、行数0となった時点で表探索に切り替わる。
-
- 以上より、「SQL6が索引探索から表探索へ変わり、理由は統計更新後に行数0となるため」と結論付けられる。
誤りやすいポイント
- インデックスが残っているから索引探索と早合点し、統計情報を無視してしまう。
- 仕様7-(3) の「行数がゼロの場合…」を見逃し、行数が極端に少ない場合の経路決定を誤解する。
- SQL1など他の検索系SQLに目を奪われ、更新系SQL6が対象であることに気付かない。
FAQ
Q: 「全行削除されない日もあるのでは?」
A: 仕掛り中の処理がないことを確認してから削除するため、日次バッチ開始時点では “仮注文” に残る行は基本的にありません。残る場合でも行数は極小であり、同じく表探索が選択されやすくなります。
A: 仕掛り中の処理がないことを確認してから削除するため、日次バッチ開始時点では “仮注文” に残る行は基本的にありません。残る場合でも行数は極小であり、同じく表探索が選択されやすくなります。
Q: 統計更新を行わずに削除だけ実施した場合は?
A: システムカタログに旧行数が残るため、オプティマイザは依然として索引探索を選択します。したがって「統計更新を行うこと」が経路変更の直接要因です。
A: システムカタログに旧行数が残るため、オプティマイザは依然として索引探索を選択します。したがって「統計更新を行うこと」が経路変更の直接要因です。
Q: 表探索に変わると何が問題ですか?
A: 注文確定処理は商品数分SQL6をループ実行します。表探索になると毎回全ページを読み、I/Oが急増してレスポンスが低下します。
A: 注文確定処理は商品数分SQL6をループ実行します。表探索になると毎回全ページを読み、I/Oが急増してレスポンスが低下します。
関連キーワード: オプティマイザ、統計情報、インデックス、表探索、行数推定
設問3:〔問題点の指摘〕の②への対応について、(1)〜(3)に答えよ。
問題文を見る(2)
(1)で答えたSQLのアクセス経路が表探索に変わった場合、そのSQLを実行するたびに処理時間が長くなる理由を、40字以内で述べよ。
模範解答
・SQL6を実行するたびに表探索によって読み込む行数が増えるから
・ “仮注文”テーブルは蓄積されるので表探索によって読み込む行数が増えるから
解説
解答の論理構成
- 表探索の動作
「表探索は、索引を使わずに先頭のデータページから全行を探索する。」
この仕様により、条件に合致しない行も含めテーブル全体を走査します。 - “仮注文”テーブルの規模
表2より「仮注文 行数 9,000,000」「仮注文番号 列値の個数 900,000」
1つの「仮注文番号」で平均10行しか該当しません。 - SQL6の検索条件
「SELECT * FROM 仮注文 WHERE 仮注文番号 = :h」
一致比較なので索引探索なら10行程度で済みますが、表探索では9,000,000行を読むことになります。 - 行数が増えるにつれ処理時間も増大
保守後も未確定データは追加され続けるためテーブルは再び肥大化し、表探索によるI/O量も比例して増加します。
誤りやすいポイント
- 「表探索でも行数が少なければ速い」と思い込み、行数増加によるI/O量を軽視する。
- 「索引探索は常に最速」と誤認し、オプティマイザが表探索を選択するケース(統計情報の変化など)を想定しない。
- SQL6の条件列と索引の先頭列が一致する点を見落とし、アクセス経路変更の影響を過小評価する。
FAQ
Q: なぜ統計更新後にオプティマイザが表探索を選ぶことがあるのですか?
A: 行数が統計上“少ない”と判断されると、索引アクセスより全件走査の方が安いと見積もられるためです。
A: 行数が統計上“少ない”と判断されると、索引アクセスより全件走査の方が安いと見積もられるためです。
Q: 索引探索に戻す方法はありますか?
A: 統計情報を正確に保ちつつ、列のカーディナリティやクラスタ化度合いを考慮した索引設計(例えば複合索引)を行い、ヒント句でオプティマイザに索引使用を促す方法もあります。
A: 統計情報を正確に保ちつつ、列のカーディナリティやクラスタ化度合いを考慮した索引設計(例えば複合索引)を行い、ヒント句でオプティマイザに索引使用を促す方法もあります。
Q: どの程度行数が増えると表探索がボトルネックになりますか?
A: ストレージ構成やバッファサイズによりますが、行数×行長分のフルスキャンI/Oが発生するため、数百万行規模では顕著な遅延が発生します。
A: ストレージ構成やバッファサイズによりますが、行数×行長分のフルスキャンI/Oが発生するため、数百万行規模では顕著な遅延が発生します。
関連キーワード: 表探索、索引探索、オプティマイザ、統計情報、I/Oコスト
設問3:〔問題点の指摘〕の②への対応について、(1)〜(3)に答えよ。
問題文を見る(3)
(1)で答えたSQLがアクセスするテーブルについて、②の問題点を改善するために表2に示した統計情報がシステムカタログに存在するという前提で、毎朝4時に行う次のA〜Cの処理を正しい順番に並べよ。なお、不要な処理は省いてよい。
A:不要な行の削除 B:再編成 C:統計更新処理
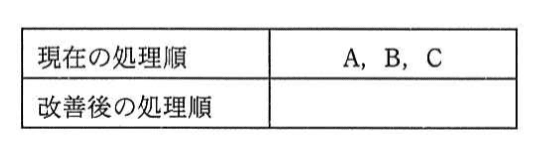
模範解答
C、A、B又はA、B
解説
解答の論理構成
- 性能低下の原因
- G氏の指摘②「アクセス経路が索引探索から表探索に変わるSQLがある」
- 表探索に変わるのは、統計情報に行数が「ゼロ又は極端に少ない」と記録されるため。仕様「7.(3) 行数がゼロの場合、表探索が最適である。」が適用される。
- 現行フローの問題
- 【問題文】〔テーブルの保守の見直し〕では「(4) …再編成し、次に統計更新処理を行う。」
- つまりA→B→Cの順。削除・再編成後にCを走らせるため行数が激減し、SQL6(仮注文番号検索)などが表探索化する。
- 改善方針
- 統計を「削除前」に採取するか、そもそも採取しない。
- 処理順の決定
- 方式① C→A→B
統計を先に取得(行数多い状態)→削除→再編成。統計は古いままだが行数推定は大きく、索引探索を維持。 - 方式② A→B
統計更新を行わず、前日の統計(行数多い状態)を維持。 - いずれも問題点②を解決するため、模範解答「C、A、B又はA、B」に一致します。
- 方式① C→A→B
誤りやすいポイント
- 再編成(B)を行えばアクセス経路が自動的に元へ戻ると誤解し、Cを最後に置く。
- 統計情報は常に最新であることが正しいと考え、性能への影響を軽視する。
- A→C→Bを選び、再編成後のページ構造変化で統計が不整合になる点に気付かない。
FAQ
Q: 統計が実際より多い行数を示しても問題になりませんか?
A: 問題文「7.(2) 列値当たりの行数は均等である。」という仮定の範囲であれば、多少の過大評価は索引探索選択に大きく影響しません。今回の目的は「表探索化を防ぐ」ことであり、多少の誤差より索引利用の方が重要です。
A: 問題文「7.(2) 列値当たりの行数は均等である。」という仮定の範囲であれば、多少の過大評価は索引探索選択に大きく影響しません。今回の目的は「表探索化を防ぐ」ことであり、多少の誤差より索引利用の方が重要です。
Q: 定期的に統計更新をまったく行わないとどうなりますか?
A: データ量や分布が大きく変化したときに誤ったアクセス経路が選択される恐れがあります。今回は日次削除直後だけ避け、月次や閑散時に別途統計更新を実施する運用が現実的です。
A: データ量や分布が大きく変化したときに誤ったアクセス経路が選択される恐れがあります。今回は日次削除直後だけ避け、月次や閑散時に別途統計更新を実施する運用が現実的です。
Q: 再編成(B)は必須ですか?
A: 再編成でページの空き領域を詰めるとI/Oを減らせますが、索引探索の可否には直接影響しません。性能要件に応じて省略する選択肢もあります。
A: 再編成でページの空き領域を詰めるとI/Oを減らせますが、索引探索の可否には直接影響しません。性能要件に応じて省略する選択肢もあります。
関連キーワード: 統計情報、オプティマイザ、アクセス経路、索引探索、表探索

