
データベーススペシャリスト 2017年 午後1 問03
テーブル及びSQLの設計に関する次の記述を読んで、設問1,2に答えよ。
A社は、全国の主要都市に家電販売チェーン店を展開している。 A社では,RDBMSの機能を用いて販売分析支援システム (以下、システムという)を運用しており,Fさんがテーブル及びSQLの設計を見直すことになった。
〔業務の概要〕
(1) 店舗は、営業本部の下で全国展開され、店舗コードで識別される。
(2) 店舗で販売を担当する社員は、いずれか一つの店舗に配属され、社員IDで識別される。各店舗には複数の社員が配属される。
(3) 商品は、商品コードで識別される。
〔システムの概要〕
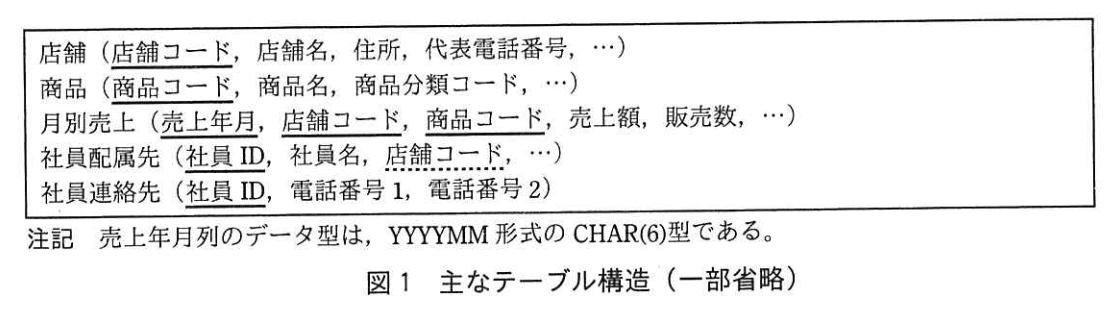
1.主なテーブル構造
主なテーブル構造を、図1に示す。 ここで、テーブルの行は追加された順に並び、同じページに異なるテーブルの行が格納されることはない。 また、索引のキー順に、ページ単位で順次又はランダムに磁気ディスク装置 (以下、ディスクという)からバッファに読み込まれる。
2.システムの運用の概要
(1) 各店舗は、閉店後の夜間に当日の売上明細ファイルを、システムに送信する。
(2) システムは、各店舗から送信された売上明細ファイルのデータを店舗コード別商品コード別に集計し、翌朝までに “月別売上” テーブルに反映させる。
(3) 営業本部の担当者は、システムを用いて販売分析を行う。 また、担当者は店舗の社員に電話をかけて販売状況を問い合わせることがある。
3.営業本部からの要望及び対応の方針
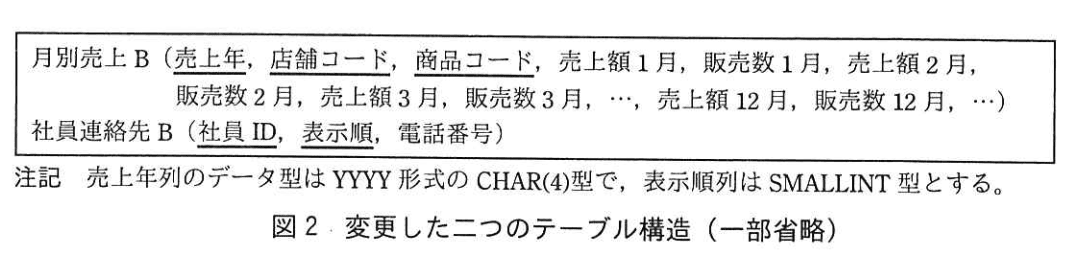
営業本部からの要望のうち、Fさんに対応を任せられた要望と、Fさんによる対応の方針は、次のとおりである。 Fさんがこれらの方針に従って変更した二つのテーブル構造を、図2に示す。
要望1 売上データの分析を行うための照会の応答時間を改善してほしい。
方針1 “月別売上” テーブルを、“月別売上B” テーブルのように変更する。
要望2 社員連絡先の電話番号を3個以上登録できるようにしてほしい。
方針2 “社員連絡先” テーブルに新たな列を追加するのではなく、“社員連絡先B” テーブルのように変更する。
〔“月別売上” テーブルの構造の変更〕
Fさんは、“月別売上” テーブルの構造の変更を、次のように検討した。
1.“月別売上” テーブルには、行が主索引のキー順にロードされている。 その全行をアンロードしたファイルを、“月別売上B” テーブルの構造に従って変換し、“月別売上B” テーブルに主索引のキー順にロードした。
2.RDBMSの機能を用いて、テーブルの統計情報を取得した。 “月別売上” テーブルと “月別売上B” テーブルの統計情報及び索引定義情報を、表1に示す。
3.次の二つの分析処理を選び、照会の応答時間を評価した。 その指標として、各分析処理に必要なディスクからの読込み行数及び読込みページ数を、表1の統計情報を基に比較した。
分析処理1 指定した1店舗について、任意の1年間の売上データを分析する。
分析処理2 指定した1商品について、任意の月の売上データを分析する。
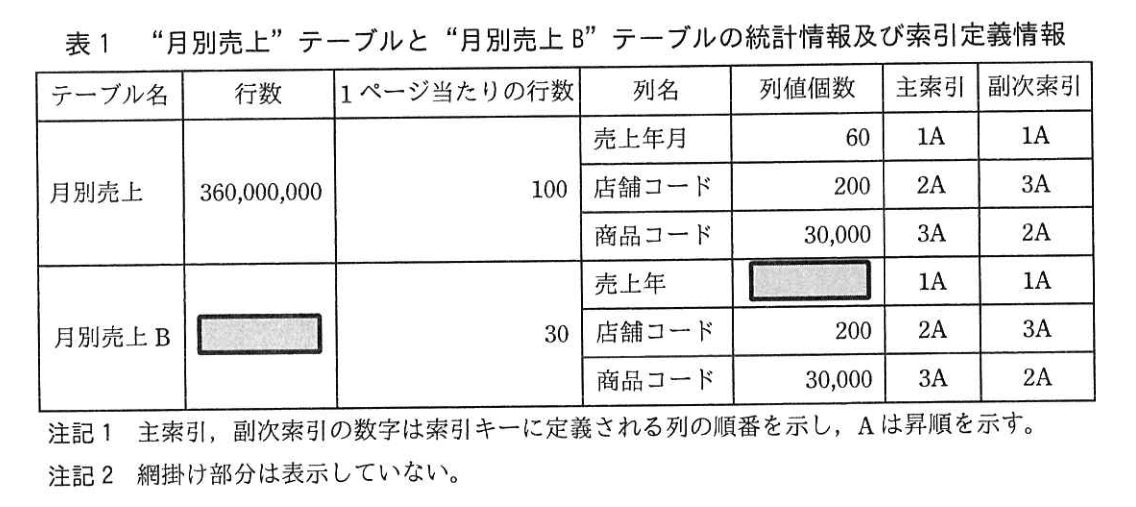
(1) 表1の二つのテーブルでは、複数行を索引のキー順に読み込む場合、アクセス経路が(ア)索引のとき、ページは順次に読み込まれるが、アクセス経路が(イ)索引のとき、1行当たり1ページがランダムに読み込まれる。
(2) 分析処理1では、分析に必要な“月別売上”テーブルの1店舗当たりの年間平均行数は、(ウ)行である。これらの行を、主索引を用いてディスクから読み込むとき、最小限(エ)ページ読み込む必要がある。
一方、“月別売上B” テーブルの1店舗当たりの年間平均行数は、指定した1年間が年をまたがらなければ、(オ)行である。これらの行を、主索引を用いてディスクから読み込むとき、最小限(カ)ページを読み込めばよい。
しかし、その1年間が年をまたがれば、読込みページ数は(キ)年間分の(ク)ページに増える。
(3) 分析処理2では、分析に必要な行数は、二つのテーブルとも1商品コード当たり最大(ケ)行である。 これらの行を、副次索引を用いてディスクから読み込むとき、最大(コ)ページ読み込む必要がある。
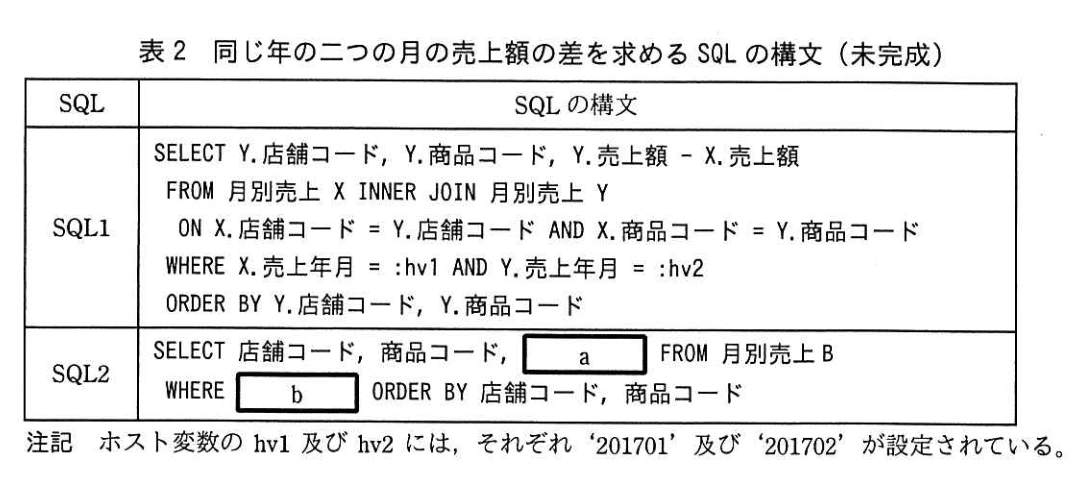
4.プログラム中のSQLへの影響を調べた。 調べたのは、同じ年の二つの月、例えば,2017年1月と2017年2月の売上額の差を求めるSQLで、その構文を表2中のSQL1に示す。 テーブル構造を変更した後で、SQL1と同じ結果行を得るために、実行の都度、比較する年月に対応したSQLの構文を組み立て、動的SQLで実行することにした。 その構文を表2中のSQL2に示す。
〔“社員連絡先” テーブルの構造の変更〕
Fさんは、“社員連絡先” テーブルの構造の変更を、次のように検討した。
1.“社員連絡先” テーブルの電話番号1列と電話番号2列の値を調べたところ、プログラムの不備による次のような問題の行があることが分かった。
問題1:電話番号1列と電話番号2列は、異なる電話番号であるべきところ、同じ電話番号が設定されている行があった。
問題2:電話番号1列だけに電話番号を設定すべきところ、電話番号1列にNULLが、電話番号2列に電話番号が設定されている行があった。
問題3:電話番号が設定されている場合だけ行を登録すべきところ、電話番号1列と電話番号2列の両方にNULLが設定されている行があった。
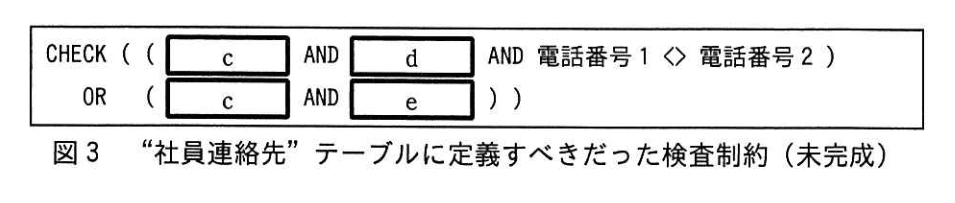
2.問題1〜3を防ぐには、“社員連絡先” テーブルに、図3に示す検査制約を定義すべきであった。 ここで、検査制約は、次の①〜④のいずれかの述語を組み合わせて指定する。
① 電話番号1 IS NOT NULL
② 電話番号1 IS NULL
③ 電話番号2 IS NOT NULL
④ 電話番号2 IS NULL
3.“社員連絡先B” テーブルの要件を、次のように整理した。
要件1:問題1〜3を解決すること
要件2:社員1人当たりの電話番号を3個以上登録できること
なお、同じ電話番号が複数の社員で使われることがある。
4.“社員連絡先B” テーブルの電話番号列に NOT NULL制約を定義し、テーブルに一意性制約を定義した。
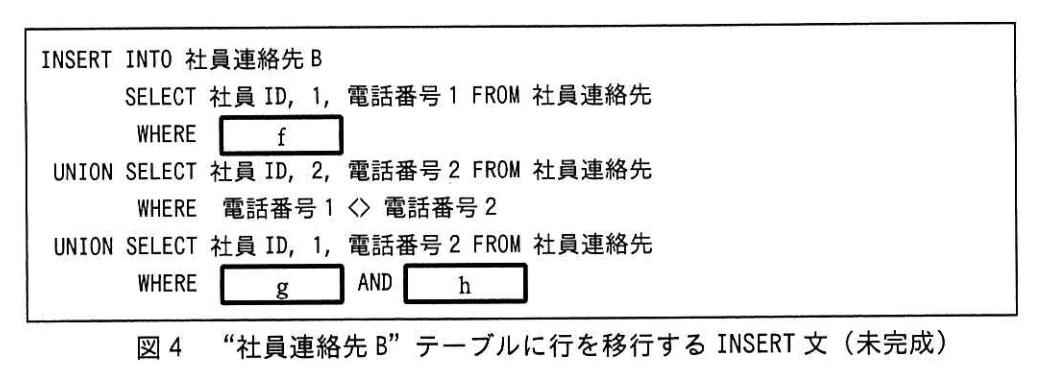
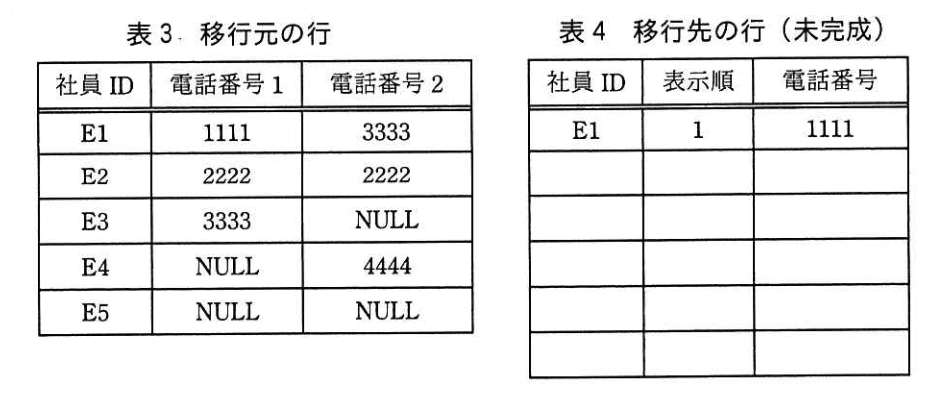
5.要件1、2を満たすために、図4に示す INSERT文を用いて、“社員連絡先” テーブルから“社員連絡先 B” テーブルに行を移行することにした。 その移行試験を行ったときの、移行元である “社員連絡先” テーブルの問題 1〜3 を含む行を表3,移行先である“社員連絡先 B” テーブルの行を表4に示す。 ここで、表3及び表 4の見出しは列名を表す。
設問1:〔“月別売上” テーブルの構造の変更〕 について、(1)〜(3)に答えよ。
問題文を見る(1)分析処理に関する記述中の(ア)〜(コ)に入れる適切な字句を答えよ。
なお、索引のバッファヒット率は100%であり、ページ中の行をアクセスするとき、次にアクセスするページはバッファにないものとする。
模範解答
ア:主
イ:副次
ウ:360,000
エ:3,600
オ:30,000
カ:1,000
キ:2
ク:2,000
ケ:200
コ:200
解説
解答の導き方
-
(ア)(イ):どの索引ならページが順次に読み込まれるか
本文には「テーブルの行は追加された順に並び」とあり、“月別売上” テーブルについては「行が主索引のキー順にロードされている」、“月別売上B” テーブルについても主索引のキー順にロードしたと書かれています。つまり、どちらのテーブルもディスク上の行の並びは主索引のキー順と同じです。そのため主索引のキー順に複数行を読むと、次の行は同じページかすぐ次のページにあり、ページは順次に読み込まれます。
一方、表1の副次索引のキーは売上年月(売上年)→商品コード→店舗コードの順で、行の格納順(売上年月(売上年)→店舗コード→商品コード)とは異なります。副次索引のキー順に読むと1行ごとに離れたページへ飛ぶことになり、設問の「次にアクセスするページはバッファにない」という前提から、1行当たり1ページをランダムに読むことになります。したがって(ア)は「主」、(イ)は「副次」です。 -
(ウ):分析処理1で “月別売上” から読む行数
表1から、“月別売上” は360,000,000行で、売上年月の列値個数は60、店舗コードの列値個数は200です。1か月・1店舗当たりの平均行数は360,000,000 ÷ 60 ÷ 200 = 30,000行です。分析処理1は「指定した1店舗について、任意の1年間」なので12か月分が必要になり、30,000 × 12 = 360,000行が(ウ)です。 -
(エ):主索引で読むときの最小ページ数
設問に「索引のバッファヒット率は100%」とあるので、数えるのはテーブルの行を格納したページだけです。主索引のキーは売上年月→店舗コード→商品コードの順なので、同じ売上年月・同じ店舗の30,000行はディスク上で連続して並んでいます。1ページ当たり100行なので、1か月分は30,000 ÷ 100 = 300ページです。
ただし、月が変わると間に他の店舗の行が入るため、12か月分はひと続きではなく、300ページの塊が12個に分かれて並びます。各塊の先頭がページの先頭にそろう最も有利な場合で300 × 12 = 3,600ページとなり、これが「最小限」の(エ)です。 -
(オ)(カ):“月別売上B” の場合
“月別売上B” は1行に売上額1月〜売上額12月・販売数1月〜販売数12月を持つので、“月別売上” の12か月分の12行が1行にまとまります。行数は360,000,000 ÷ 12 = 30,000,000行、売上年の列値個数は60 ÷ 12 = 5です。1年・1店舗当たりの平均行数は30,000,000 ÷ 5 ÷ 200 = 30,000行で、これが(オ)です。
主索引のキーは売上年→店舗コード→商品コードの順なので、この30,000行は連続して並んでいます。表1の1ページ当たりの行数30から、30,000 ÷ 30 = 1,000ページが(カ)です。 -
(キ)(ク):1年間が年をまたぐ場合
例えば2016年4月〜2017年3月を分析すると、売上年が2016の行からは4月〜12月の列を、2017の行からは1月〜3月の列を使います。“月別売上B” は1行に1年分が入っているので、使う月が一部だけでも、2年分の行をすべて読まなければなりません。したがって(キ)は2で、読込みページ数は1,000 × 2 = 2,000ページとなり、これが(ク)です。 -
(ケ):分析処理2で読む行数
分析処理2は「指定した1商品について、任意の月」を分析します。“月別売上” では、ある売上年月・ある商品コードの行は店舗ごとに1行です。“月別売上B” では月は列(売上額1月など)なので、ある売上年・ある商品コードの行もやはり店舗ごとに1行です。店舗コードの列値個数は200なので、どちらのテーブルでも最大200行となり、これが(ケ)です。「最大」なのは、すべての店舗にその商品の行があるとは限らないためです。 -
(コ):副次索引で読む最大ページ数
分析処理2の条件は売上年月(売上年)と商品コードで、副次索引のキーの先頭2列に一致するため、副次索引を使って読みます。1.で確かめたとおり副次索引では1行当たり1ページがランダムに読み込まれるので、200行なら最大200ページとなり、これが(コ)です。行の格納順では、同じ月・同じ商品でも店舗が違えば他の商品の行を挟んで離れているので、同じページにまとまることはありません。
誤りやすいポイント
- 1ページ当たりの行数を取り違える。“月別売上” は100行、“月別売上B” は30行です。(カ)を30,000 ÷ 100 = 300と計算しないよう注意します。
- (エ)を、12か月分がひと続きに並んでいると考えて求めてしまう。数値は同じ3,600になりますが、実際は月ごとに300ページの塊に分かれています。この並び方を押さえておかないと、「最小限」と書かれている意味や、年をまたぐ場合の考え方でつまずきます。
- 年をまたいでも12か月分なので読む量は変わらないと考え、(ク)を1,000のままにする。“月別売上B” は1行が1年分なので、2年分の行を読む必要があります。
- 副次索引でも主索引と同じように1ページに複数行をまとめて読めると考え、(コ)を200 ÷ 100 = 2ページなどと少なく見積もる。
FAQ
Q: 方針1で “月別売上B” に変えると、どちらの分析処理が速くなるのですか?
A: 分析処理1です。読込みページ数は3,600ページから1,000ページ(年をまたぐ場合は2,000ページ)に減ります。分析処理2は、どちらのテーブルでも副次索引で最大200ページを読むので変わりません。1行に12か月分を持たせる設計は、同じ店舗・商品の複数の月をまとめて読む処理に効果があります。
A: 分析処理1です。読込みページ数は3,600ページから1,000ページ(年をまたぐ場合は2,000ページ)に減ります。分析処理2は、どちらのテーブルでも副次索引で最大200ページを読むので変わりません。1行に12か月分を持たせる設計は、同じ店舗・商品の複数の月をまとめて読む処理に効果があります。
Q: “月別売上B” の1ページ当たりの行数が30行と少ないのはなぜですか?
A: 1行に売上額と販売数を12か月分ずつ持つため、1行が長くなるからです。行数は1/12になりますが、1ページに入る行数も100行から30行に減るので、ページ数は1/12にはなりません。本問でも分析処理1のページ数は3,600ページから1,000ページへの減少にとどまっています。
A: 1行に売上額と販売数を12か月分ずつ持つため、1行が長くなるからです。行数は1/12になりますが、1ページに入る行数も100行から30行に減るので、ページ数は1/12にはなりません。本問でも分析処理1のページ数は3,600ページから1,000ページへの減少にとどまっています。
Q: 副次索引で読む行が非常に多い場合も、索引を使うのがよいのですか?
A: 必ずしもそうではありません。副次索引では1行ごとにランダムな読込みが発生するため、対象の行がテーブルの大きな割合を占める場合は、テーブル全体を順次に読む方が読込みページ数が少なくなることがあります。多くのRDBMSでは、表1のような統計情報を基にオプティマイザがアクセス経路を選びます。
A: 必ずしもそうではありません。副次索引では1行ごとにランダムな読込みが発生するため、対象の行がテーブルの大きな割合を占める場合は、テーブル全体を順次に読む方が読込みページ数が少なくなることがあります。多くのRDBMSでは、表1のような統計情報を基にオプティマイザがアクセス経路を選びます。
関連キーワード: 主索引、副次索引、順次アクセス、ランダムアクセス、非正規化、統計情報

設問1:〔“月別売上” テーブルの構造の変更〕 について、(1)〜(3)に答えよ。
問題文を見る(2)表2中の(a)、(b)に入れる適切な字句を答えよ。
模範解答
a:売上額2月 - 売上額1月
b:売上年 = '2017' 又は 売上年 = ?
解説
解答の論理構成
-
問題設定の確認
- 【問題文】「同じ年の二つの月、例えば,2017年1月と2017年2月の売上額の差を求めるSQL」とある。
- さらに「ホスト変数の hv1 及び hv2 には、それぞれ ‘201701’ 及び ‘201702’ が設定」と記載。
-
比較対象の月を列で表現
-
“月別売上B” では「売上額1月」「売上額2月」… と1行に12か月分を保持する縦持ち→横持ち(ワイドテーブル)設計に変更済み。
-
双方の月を同一行内で参照できるため、SELECT 句は売上額2月 - 売上額1月で目的の差分が得られる。従来の自己結合は不要。
-
-
WHERE 句の絞り込み
-
列として「売上年」が存在し、比較月は列名で確定しているため、条件は年のみ。
-
hv1・hv2の先頭4桁が “2017” とわかるので売上年 = '2017'が適切。
-
-
以上より
- (a) = 「売上額2月 - 売上額1月」
- (b) = 「売上年 = '2017'」
誤りやすいポイント
- 縦持ちの “月別売上” と横持ちの “月別売上B” を混同し、自己結合を書いてしまう。
- WHERE 句で月も絞り込みたくなり 売上月 IN (1,2) などと余計な条件を付け、結果列に NULL が混在して誤差分が NULL になる。
- 年をハードコードせずSUBSTR(:hv1,1,4) と書きたくなるが、試験では具体例をそのまま記述させる設問である点を見落とす。
FAQ
Q: 列名に全角数字が含まれていますが、そのまま記述して良いですか?
A: はい。【問題文】中で列名として提示されている「売上額1月」「売上額2月」などはそのまま引用する必要があります。
A: はい。【問題文】中で列名として提示されている「売上額1月」「売上額2月」などはそのまま引用する必要があります。
Q: hv1とhv2が異なる年になる場合はどうしますか?
A: 設問は「同じ年の二つの月」を前提にしているので、今回の回答では年が一致しているケースだけを考えます。異年比較を行う場合は WHERE 句を 売上年 = SUBSTR(:hv1,1,4) など動的に組み替え、列名も年を跨いだロジックに変更する必要があります。
A: 設問は「同じ年の二つの月」を前提にしているので、今回の回答では年が一致しているケースだけを考えます。異年比較を行う場合は WHERE 句を 売上年 = SUBSTR(:hv1,1,4) など動的に組み替え、列名も年を跨いだロジックに変更する必要があります。
Q: 売上額列にNULLがあった場合、差分計算はどうなるのでしょう?
A: 通常のSQL演算ではNULLを含む計算結果はNULLになります。データをクリーニングするか COALESCE(売上額n月,0) でNULLを0に置換してから差分を取るなどの対処が必要です。
A: 通常のSQL演算ではNULLを含む計算結果はNULLになります。データをクリーニングするか COALESCE(売上額n月,0) でNULLを0に置換してから差分を取るなどの対処が必要です。
関連キーワード: 正規化、ワイドテーブル、動的SQL, 集約列、縦持ち横持ち
設問1:〔“月別売上” テーブルの構造の変更〕 について、(1)〜(3)に答えよ。
問題文を見る(3)Fさんは、なぜ表2中のSQL2を動的SQLで実行することにしたのか。 その理由を40字以内で述べよ。
模範解答
比較する売上年月ごとに選択リストの列名を変更しなければならないから
解説
解答の論理構成
- テーブル変更の影響
“月別売上B” は「売上年、店舗コード、商品コード」に続き「売上額1月」「売上額2月」…の列を持つワイドテーブル。 - 既存SQL1の構造
SQL1 では WHERE X.売上年月 = :hv1 AND Y.売上年月 = :hv2 によって行を選び、同じ列 売上額 を減算して月間差を算出していた。 - 列名が可変になる問題
ワイドテーブルでは比較する月ごとに引き当てる列が変わる。たとえば1月と2月なら 売上額1月 と 売上額2月、3月と5月なら 売上額3月 と 売上額5月 になる。 - 静的SQLでは対応不能
プレースホルダ(バインド変数)はリテラル値や演算対象に使えても、列名を置き換える機能はない。 - 動的SQLが唯一の解決策
したがって【問題文】にある通り「実行の都度、比較する年月に対応したSQLの構文を組み立て」る必要が生じ、動的SQLを選択した。
誤りやすいポイント
- バインド変数で列名まで可変にできると誤解する。
- 「WHERE 句だけが問題」と考え、SELECT 句の列名置換を見落とす。
- 年月を跨ぐ場合のページ読み込み増など別テーマの記述と混同し、本設問の焦点を外す。
FAQ
Q: 静的SQLで CASE 式を使えば列名の切替えを回避できますか?
A: CASE 式で列名自体は切替えられません。各列値を CASE の条件分岐で選択する方法はありますが、12か月分すべてを式に含むため可読性と保守性が低下し、本システムの方針に合いません。
A: CASE 式で列名自体は切替えられません。各列値を CASE の条件分岐で選択する方法はありますが、12か月分すべてを式に含むため可読性と保守性が低下し、本システムの方針に合いません。
Q: ビューを月ごとに作っておけば動的SQLを避けられますか?
A: ビューを月ペアごとに無数に作成する必要が生じ、管理コストが高騰します。柔軟性と実行時の自由度を確保するには動的SQLが合理的です。
A: ビューを月ペアごとに無数に作成する必要が生じ、管理コストが高騰します。柔軟性と実行時の自由度を確保するには動的SQLが合理的です。
Q: 動的SQLによるパフォーマンス低下は問題になりませんか?
A: 解析準備時間が再発生しますが、月間差分取得は分析処理の一部であり、I/O削減効果のほうが大きいと判断されています。必要に応じてプリペアドキャッシュや変数バインドで実行計画の再利用を図ります。
A: 解析準備時間が再発生しますが、月間差分取得は分析処理の一部であり、I/O削減効果のほうが大きいと判断されています。必要に応じてプリペアドキャッシュや変数バインドで実行計画の再利用を図ります。
関連キーワード: 動的SQL, ワイドテーブル設計、列名可変、バインド変数、可読性向上
設問2:〔“社員連絡先” テーブルの構造の変更〕 について、(1)〜(5)に答えよ。
問題文を見る(1)“社員連絡先B” テーブルの電話番号列に NOT NULL制約を定義した理由を、本文中の字句を用いて25字以内で述べよ。
模範解答
電話番号が設定されている行だけを登録したいから
解説
解答の論理構成
- 【問題文】には電話番号列の欠陥として
「問題3:電話番号が設定されている場合だけ行を登録すべきところ…NULLが設定されている行があった。」
と記述されている。 - そこでFさんは「“社員連絡先B” テーブルの電話番号列に NOT NULL制約を定義」したと述べている。
- NOT NULL制約を付ければNULL値(=電話番号未設定)を持つ行そのものが登録不可能になる。
- したがって「電話番号が設定されている行だけを登録したい」という意図と完全に一致する。
誤りやすいポイント
- 「一意性制約」も定義されているが、NOT NULLとは目的が異なる(重複防止ではなく空値防止)。
- 問題1・問題2の対策と混同し、NULL制約の役割をあいまいに答えてしまう。
- “行を更新するとき”ではなく“登録(INSERT)時”のチェックであることを忘れがち。
FAQ
Q: なぜ CHECK ではなく NOT NULL としたのですか?
A: 電話番号列を NULL 禁止にすれば「電話番号未設定の行」を物理的に登録できなくなるため、CHECK より簡潔で確実です。
A: 電話番号列を NULL 禁止にすれば「電話番号未設定の行」を物理的に登録できなくなるため、CHECK より簡潔で確実です。
Q: 電話番号が複数登録される場合はどう区別しますか?
A: 「表示順」列で1,2,3… を付与し、複数レコードで1人当たり3件以上を保持できます(同じ電話番号が他の社員と重複しても一意性制約の列組み合わせで許容)。
A: 「表示順」列で1,2,3… を付与し、複数レコードで1人当たり3件以上を保持できます(同じ電話番号が他の社員と重複しても一意性制約の列組み合わせで許容)。
関連キーワード: NOT NULL制約、NULL値、検査制約、一意性制約
設問2:〔“社員連絡先” テーブルの構造の変更〕 について、(1)〜(5)に答えよ。
問題文を見る(2)“社員連絡先B” テーブルの一意性制約に定義すべき列名又は列名の組合せを答えよ。 ここで、主キー制約を除くこと。
模範解答
社員ID、電話番号 又は 電話番号、社員ID
解説
解答の論理構成
- 【問題文】「要件1:問題1〜3を解決すること」より、
- 問題1:同一社員行内で電話番号が重複してはいけない
- 【問題文】「なお、同じ電話番号が複数の社員で使われることがある。」より、
- 電話番号は社員をまたいで重複してもよい
- 【問題文】「4.“社員連絡先B” テーブルの電話番号列に NOT NULL制約を定義し、テーブルに一意性制約を定義した。」より、
- NULLは排除済みなので一意性検証は値比較だけで済む
- 主キー (社員ID, 表示順) では “同じ社員が1と2の両行に1111” のような重複を防げない
- 電話番号のみでは異なる社員E1とE3が3333を共有できなくなる
- よって「社員IDと 電話番号」の組に一意性制約を設けることで
・同一社員内の重複を排除(問題1解決)
・異なる社員間の番号共有を許容(要件2を阻害しない) - 以上より答えは「社員ID、電話番号」です。列順に意味はないため「電話番号、社員ID」でも同義となります。
誤りやすいポイント
- 電話番号列だけに一意性を掛けてしまい、複数社員で同じ番号を持てなくなる
- 主キーと同じ「社員ID、表示順」を再度一意にしてしまい、問題1が未解決
- 「表示順、電話番号」とすると同一番号を異なる表示順で登録できる点を見落とす
FAQ
Q: 「社員ID、電話番号」を主キーにしてはいけないのですか?
A: 表示順で並び替える要求があるため主キーは「社員ID、表示順」が適切です。一意性は別途「社員ID、電話番号」で与えるのが自然です。
A: 表示順で並び替える要求があるため主キーは「社員ID、表示順」が適切です。一意性は別途「社員ID、電話番号」で与えるのが自然です。
Q: 電話番号列に NOT NULL制約があるのに一意性制約は必要ですか?
A: NOT NULLは欠損値を防ぐだけで重複を許します。重複禁止には一意性制約が必須です。
A: NOT NULLは欠損値を防ぐだけで重複を許します。重複禁止には一意性制約が必須です。
Q: 列順は制約に影響しますか?
A: 一意性制約では列の組合せ全体がキーになりますので、「社員ID、電話番号」と「電話番号、社員ID」は機能的に同一です。
A: 一意性制約では列の組合せ全体がキーになりますので、「社員ID、電話番号」と「電話番号、社員ID」は機能的に同一です。
関連キーワード: 一意性制約、複合キー、NULL制約、主キー設計、データ品質
設問2:〔“社員連絡先” テーブルの構造の変更〕 について、(1)〜(5)に答えよ。
問題文を見る(3)図3中の(c)〜(e)に入れる適切な述語を、①〜④の中からそれぞれ重複なく一つずつ選んで答えよ。
模範解答
c:①
d:③
e:④
解説
解答の論理構成
- 【問題文】では検査制約を
CHECK ( ((c) AND (d) AND 電話番号1 <> 電話番号2) OR ((c) AND (e)) )
と提示しています。 - 目的は【問題文】の “問題1〜3を防ぐ” こと。具体的には
- 問題1:同じ番号を重複登録
- 問題2:電話番号1がNULL、電話番号2のみ有値
- 問題3:両方 NULL
- まず両パターンとも (c) が 共通 で使われているため、(c) は必ず満たすべき条件です。問題2・3を防ぐには 電話番号1の非NULLを必須にする必要があるので (c)=① 電話番号1 IS NOT NULLと決定します。
- 第1グループは「両列に値があり、かつ異なる」条件です。ここで (d) は 電話番号2の非NULL、つまり ③ 電話番号2 IS NOT NULLが入ります。
- 第2グループは「電話番号2が無い」パターンを許可するため (e)=④ 電話番号2 IS NULL。
- 以上より
- c:① 電話番号1 IS NOT NULL
- d:③ 電話番号2 IS NOT NULL
- e:④ 電話番号2 IS NULL
が正答となります。
誤りやすいポイント
- (c) と (d) を “電話番号1・2それぞれNULL/NOT NULLを入れ替えても同じ” と早合点する。実際には (c) が両グループで共通なので入れ替え不可です。
- 問題1の「値が同じ」を <> 条件で排除できることを忘れ、(d) に 電話番号2 IS NULLを入れてしまう。
- 問題2を “電話番号2だけ有値も許可” と誤読し、(c) に ② 電話番号1 IS NULLを選んでしまう。
FAQ
Q: 電話番号2だけが登録されるケースも業務上ありそうですが、なぜ許さないのですか?
A: 【問題文】で “電話番号1列だけに電話番号を設定すべきところ” と規定されており、電話番号1が必須だからです。設計上「主番号は必ず電話番号1」と定めています。
A: 【問題文】で “電話番号1列だけに電話番号を設定すべきところ” と規定されており、電話番号1が必須だからです。設計上「主番号は必ず電話番号1」と定めています。
Q: 電話番号1 <> 電話番号2だけで重複を防げませんか?
A: NULLが混在すると比較結果が不定になるため、NULL制御を IS NULL/IS NOT NULLで明示的に行う必要があります。
A: NULLが混在すると比較結果が不定になるため、NULL制御を IS NULL/IS NOT NULLで明示的に行う必要があります。
Q: “社員連絡先B” へ移行した後も同じ制約は必要ですか?
A: “社員連絡先B” は 1 行 1 電話番号の構造で、一意性制約と NOT NULL ですべての問題を根本的に解消できるため、同じ複合 CHECK 制約は不要です。
A: “社員連絡先B” は 1 行 1 電話番号の構造で、一意性制約と NOT NULL ですべての問題を根本的に解消できるため、同じ複合 CHECK 制約は不要です。
関連キーワード: CHECK制約、NULL判定、論理演算、データ整合性、非正規形
設問2:〔“社員連絡先” テーブルの構造の変更〕 について、(1)〜(5)に答えよ。
問題文を見る(4)図4中の(f)〜(h)に入れる適切な述語を、(3)に倣って①〜④の中からそれぞれ重複なく一つずつ選んで答えよ。(g, hは順不同)
模範解答
f:①
g:②
h:③
解説
解答の論理構成
-
【問題文】図4(INSERT 文)の構造SELECT 社員ID, 1, 電話番号1 … WHERE □(f) UNION SELECT 社員ID, 2, 電話番号2 … WHERE 電話番号1 <> 電話番号2 UNION SELECT 社員ID, 1, 電話番号2 … WHERE □(g) AND □(h)
-
選択肢は 【問題文】「① 電話番号1 IS NOT NULL ② 電話番号1 IS NULL ③ 電話番号2 IS NOT NULL ④ 電話番号2 IS NULL」。
-
第1SELECT(表示順=1, 電話番号1)
- 目的:有効な “電話番号1” をそのままコピー。
- 必要条件:電話番号1がNULLでないこと → “①”。
- 重複なしの要件とも矛盾しない。
⇒ (f)=①。
-
第2SELECT(表示順=2, 電話番号2)
- WHERE 句に既に 電話番号1 <> 電話番号2 がある。
- “電話番号1 = 電話番号2” 行(【問題文】“問題1”)を除外して二件目として登録する意図。
- 追加の述語は不要なので (g)(h) ではない。
-
第3SELECT(表示順=1, 電話番号2)
- 目的:電話番号1が未入力で 電話番号2だけ登録されている行(【問題文】“問題2”)を救済。
- 条件① 電話番号1 IS NULL → “②”。
- 条件② 電話番号2 IS NOT NULL → “③”。
- 両条件は AND で連結、順序は問われていない。
⇒ (g)=②、(h)=③(順不同)。
誤りやすいポイント
- 第2SELECTに既に 電話番号1 <> 電話番号2があるため、「③」を重ねて書かないこと。
- 第3SELECTの表示順は “1” なので「2」にしてしまうミスに注意。
- NULL判定に = を使う誤記(電話番号1 = NULLなど)はSQL文法エラーとなる。
FAQ
Q: 第1SELECTに 電話番号1 <> 電話番号2を追加しても良いですか?
A: 不要です。電話番号1がNULLでなければ要件1(重複電話番号の排除)は第2SELECTでカバーでき、余計な述語は性能低下を招きます。
A: 不要です。電話番号1がNULLでなければ要件1(重複電話番号の排除)は第2SELECTでカバーでき、余計な述語は性能低下を招きます。
Q: 第3SELECTで 電話番号2 IS NOT NULLだけを書けば十分では?
A: 電話番号1がNULLである保証がなければ、電話番号1も値を持つ行を重複登録する恐れがあります。必ず “② 電話番号1 IS NULL” と組合せます。
A: 電話番号1がNULLである保証がなければ、電話番号1も値を持つ行を重複登録する恐れがあります。必ず “② 電話番号1 IS NULL” と組合せます。
Q: UNION ALL ではなく UNION を使っている理由は?
A: UNION は重複行を自動的に排除するため、一意性制約を意識した手間の少ない書き方になります。
A: UNION は重複行を自動的に排除するため、一意性制約を意識した手間の少ない書き方になります。
関連キーワード: NULL判定、一意性制約、検査制約、UNION, INSERT…SELECT
設問2:〔“社員連絡先” テーブルの構造の変更〕 について、(1)〜(5)に答えよ。
問題文を見る(5)表4に記入されている1行目の例に倣って、全ての結果行を埋めよ。 ここで、行の並び順は問わない。 また、表4の全ての行が埋まるとは限らない。
模範解答
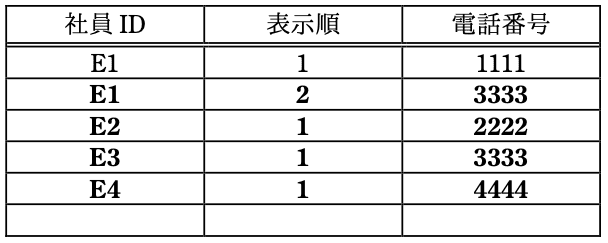
解説
解答の導き方
まず前提を確認します。問題文にあるとおり「電話番号列に NOT NULL制約を定義し、テーブルに一意性制約を定義した」とあります。ここでは一意性制約が「(社員ID, 電話番号) の組を重複させない」ことを想定します。これにより、同じ社員に同じ電話番号を複数行登録することは許されません。
次に、図4のINSERT文の構造を読みます。図4は3つのSELECTをUNIONで結んでおり、要旨は次のとおりです(簡潔化して示します)。
- 第1SELECT:社員ID、1、電話番号1 を挿入する(WHERE □(f))。
- 第2SELECT:社員ID、2、電話番号2 を挿入する(WHERE 電話番号1 <> 電話番号2)。
- 第3SELECT:社員ID、1、電話番号2 を挿入する(WHERE □(g) AND □(h))。
ここで、移行で満たすべき要件は「要件1:問題1〜3を解決すること」(重複、電話番号の入れ替わり、両方NULLの行を登録しない)および「要件2:社員1人当たりの電話番号を3個以上登録できること」でした。これらを満たすために、SELECTの条件は次のように決まると推定します。
- 第1SELECTの条件fは「電話番号1 IS NOT NULL」。電話番号1が存在する場合に表示順1として挿入する。
- 第2SELECTは図示どおり「電話番号1 <> 電話番号2」で、電話番号1と電話番号2が存在し、かつ異なる場合に表示順2として電話番号2を挿入する(注意:SQLではNULLと比較すると結果はUNKNOWNになりWHEREでは除外されるため、電話番号2がNULLの行は対象にならない)。
- 第3SELECTの条件gとhは「電話番号1 IS NULL AND 電話番号2 IS NOT NULL」。電話番号1がNULLで電話番号2が存在する場合に、電話番号2を表示順1として挿入する(電話番号1が空だったときに電話番号2を繰り上げるため)。
以上の条件設定は、問題1(同一番号が両列にあり重複する)を防ぐために第2SELECTで差分のみを挿入し、第2(電話番号1列だけに設定すべきところで逆になっている)を第3SELECTで補正し、第3(両方NULLのときは行を登録しない)を各WHEREで防ぐ、という要件を満たします。
では、表3の各行に対して上の3SELECTを当てはめます(SQLのNULL比較規則を使う点に注意してください)。
-
E1(電話番号1=1111、電話番号2=3333)
第1SELECT: 電話番号1 IS NOT NULL → (E1,1,1111) が得られる。
第2SELECT: 電話番号1 <> 電話番号2 → 1111 <> 3333は真 → (E1,2,3333) が得られる。
第3SELECT: 電話番号1 IS NULLではない → 対象外。
結果:(E1,1,1111) と (E1,2,3333) -
E2(電話番号1=2222、電話番号2=2222)
第1SELECT: 電話番号1 IS NOT NULL → (E2,1,2222) を挿入。
第2SELECT: 電話番号1 <> 電話番号2 → 2222 <> 2222は偽 → 対象外(電話番号2は挿入されない)。
第3SELECT: 電話番号1 IS NULLではない → 対象外。
結果:(E2,1,2222) のみ(同一番号が1行になる) -
E3(電話番号1=3333、電話番号2=NULL)
第1SELECT: 電話番号1 IS NOT NULL → (E3,1,3333)。
第2SELECT: 電話番号1 <> 電話番号2 → NULLとの比較でUNKNOWN → 対象外。
第3SELECT: 電話番号2 IS NOT NULLではない → 対象外。
結果:(E3,1,3333) -
E4(電話番号1=NULL、電話番号2=4444)
第1SELECT: 電話番号1 IS NOT NULLではない → 対象外。
第2SELECT: 電話番号1 <> 電話番号2 → NULLとの比較でUNKNOWN → 対象外。
第3SELECT: 電話番号1 IS NULL AND 電話番号2 IS NOT NULL → 真 → (E4,1,4444)。
結果:(E4,1,4444) -
E5(電話番号1=NULL、電話番号2=NULL)
いずれのSELECT条件も満たさない → 行は移行されない。
これらをまとめると、表4に入る行は次のとおりです(並び順は問わない):
(E5は移行されないため表4に行は作られません。)
誤りやすいポイント
- NULLの扱いを誤る:電話番号1 <> 電話番号2 はどちらかがNULLだとUNKNOWNになりWHEREで除外される。NULLを真偽の普通の値と同等に扱うと誤答する。
- UNION と UNIQUE の取り扱いを混同する:UNIONは全列が同一の行を統合するが、表示順が異なれば別行として残る。表示順で重複を避ける設計になっているかを確認する必要がある。
- 一意性制約のキーを混同する:本問では一意性制約を (社員ID, 電話番号) と想定した。もし (社員ID, 表示順) を一意キーと誤認すると、第1SELECTと第3SELECTが同じ表示順を出すケースを心配して誤答する可能性がある。
- 第2SELECTの条件だけで電話番号2のNULLを明示的に排除していないが、比較演算の結果で除外される点を見落とすと、不要なWHERE条件を探して迷う。
- 両方NULLの行を挿入しない意図を見落とし、NULL行が残ると誤答になる。
FAQ
Q: 電話番号1 <> 電話番号2 の条件だけで電話番号2がNULLの場合を排除できるのですか?
A: はい。SQLでは NULL を含む比較は UNKNOWN となり WHERE 句では選ばれません。したがって明示的に電話番号2 IS NOT NULL と書かなくても NULL の行は第2SELECTの結果には現れません(可読性のために明示する設計もあり得ます)。
A: はい。SQLでは NULL を含む比較は UNKNOWN となり WHERE 句では選ばれません。したがって明示的に電話番号2 IS NOT NULL と書かなくても NULL の行は第2SELECTの結果には現れません(可読性のために明示する設計もあり得ます)。
Q: なぜ第3SELECTの表示順は1になっているのですか?電話番号2をそのまま2にすべきではないですか?
A: 要件2と要件1(電話番号1列が空で2に値がある場合に1として扱う)を満たすために、電話番号1がNULLで電話番号2が存在する場合は表示順を1に繰り上げます。これにより「電話番号1が空のまま表示順2だけになる」ような不整合を防ぎます。
A: 要件2と要件1(電話番号1列が空で2に値がある場合に1として扱う)を満たすために、電話番号1がNULLで電話番号2が存在する場合は表示順を1に繰り上げます。これにより「電話番号1が空のまま表示順2だけになる」ような不整合を防ぎます。
Q: 一意性制約が (社員ID, 表示順) だとまずいですか?
A: 設問の想定(および本解説の前提)では一意性制約は (社員ID, 電話番号) です。もし一意性制約が (社員ID, 表示順) であれば、第1SELECTと第3SELECTが同一社員に対して同じ表示順1を出すケースが発生すると制約違反になります。したがってキー設計を問題仕様どおりに確認することが重要です。
A: 設問の想定(および本解説の前提)では一意性制約は (社員ID, 電話番号) です。もし一意性制約が (社員ID, 表示順) であれば、第1SELECTと第3SELECTが同一社員に対して同じ表示順1を出すケースが発生すると制約違反になります。したがってキー設計を問題仕様どおりに確認することが重要です。
関連キーワード: NULL、UNION、一意性制約、NOT NULL制約、CHECK制約

