
データベーススペシャリスト 2019年 午後1 問03
部品表の設計及び処理に関する次の記述を読んで、設問1〜4に答えよ。
E社は、機械メーカである。 E社では、RDBMSに構築した生産部品表(以下、部品表という)を用いて生産管理を行っている。 情報システム部門のFさんは、新たに配属されたDB管理者のために、部品表に関する研修を担当することになった。
〔RDBMSの主な仕様〕
(1) 索引は、ユニーク索引と非ユニーク索引に分けられる。
(2) DMLのアクセスパスは,RDBMSによって索引探索又は表探索に決められる。
(3) 索引探索に決められるためには、WHERE 句の AND だけで結ばれた一つ以上の等値比較の述語の対象列が、索引キーの全体又は先頭から連続した一つ以上の列に一致していなければならない。 ON 句の場合も同様である。
〔部品表の概要〕
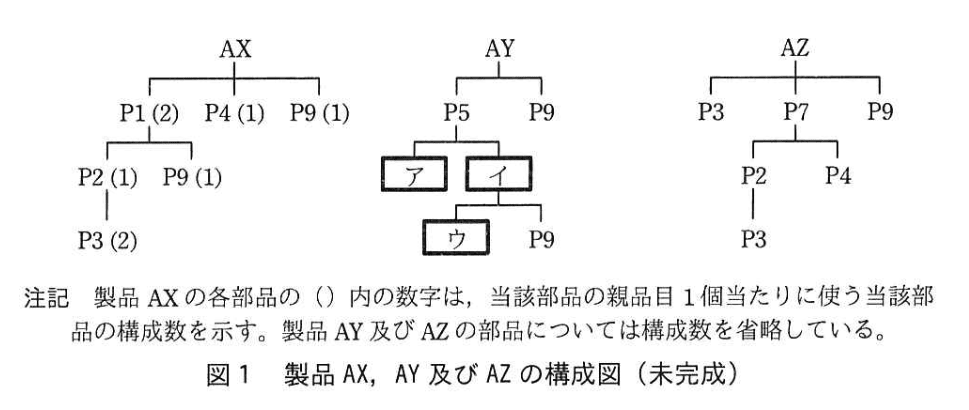
部品表は,E社が製造する製品と製品を構成する部品との関係を表すものである。 Fさんは、研修で使用するためにE社の製品を簡略化して表した製品AX、AY及びAZの構成図を図1に示し、次のように説明することにした。
1.品目
(1) 品目は、品番で識別し、品目ごとに在庫をもっている。
(2) 品目には、製品と、他の部品を使って組み立てられる中間部品、単独で使われる単体部品があり、品目区分で分類する。 例えば、図1中のAXは製品、P1及びP2は中間部品、P3, P4及びP9は単体部品である。
2.製品の構成
(1) 製品は、複数種類の部品で構成され、構成図は、階層で表現される。製品からの階層の深さをレベルという。 製品のレベルを0として、階層を一つ下るごとにレベルに1を加算する。 例えば、製品AXを構成する部品について、レベル1に部品P1, P4及びP9, レベル2に部品P2及びP9, レベル3に部品P3がある。
(2) 各部品について、当該部品を使う全ての製品の構成図の中で、当該部品が出現するレベルの最大値を、最も深い階層を示すことから、ローレベルコード(以下、LLCという)という。 例えば、図1では、部品P5のLLCは1, 部品P9のLLCは3である。
(3) ある品目が他の品目から構成される場合、当該品目を親品目といい、親品番で識別する。また、当該親品目の一つ下のレベルの品目を子品目といい、子品番で識別する。
(4) 親品目1個当たりに使う各子品目の個数を構成数という。 例えば、製品AXの製造に使う各部品の構成数は、次のとおりである。
① 製品AXは、1個当たり、部品P1を2個、部品P4, P9をそれぞれ1個ずつ使う。
② 部品P1は,1個当たり、部品P2, P9をそれぞれ1個ずつ使う。
③ 部品P2は、1個当たり、部品P3を2個使う。
3.主なテーブルのテーブル構造
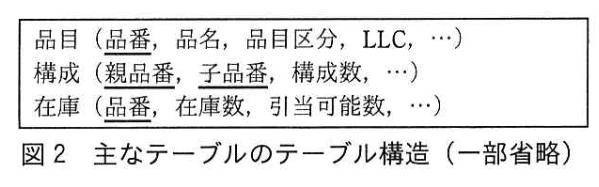
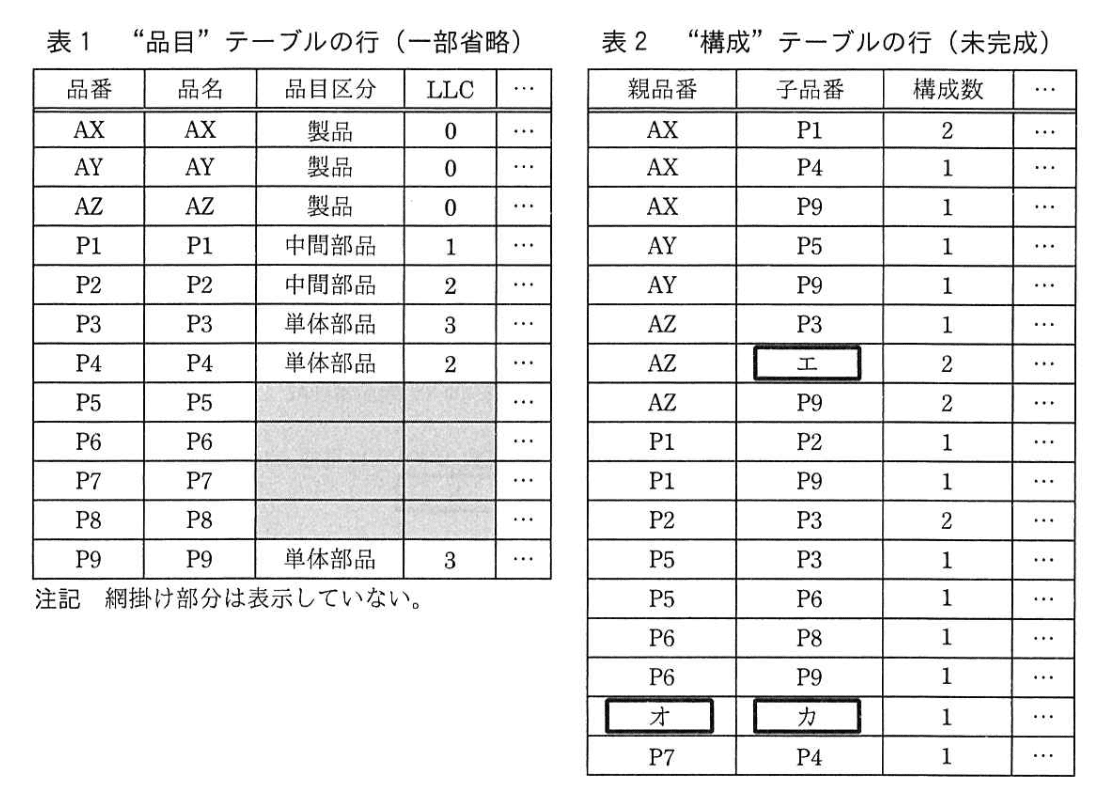
E社が生産管理に用いている主なテーブルのテーブル構造を図2に示す。図1に基づいて登録した“品目” テーブルの行を表1に、“構成” テーブルの行を表2に示す。
なお、各テーブルには主索引だけが定義されている。 索引キーが複合列の場合、テーブル構造に示した列の順番で定義される。
〔部品表に対する基本的な処理〕
1.正展開処理、逆展開処理及び所要量計算処理の概要
Fさんは、部品表に対する三つの基本的な処理として、正展開処理、逆展開処理及び所要量計算処理を挙げた。
(1) 正展開処理は、親品目がどの子品目を使っているかを、階層を上から下に1階層ずつたどることで調べる。
(2) 逆展開処理は、子品目がどの親品目に使われているかを、正展開処理とは逆に、階層を下から上に1階層ずつたどることで調べる。 逆展開処理は、ある部品が廃番になったとき、その部品がどの品目に影響するかを調べるときなどに行われる。
(3) 所要量計算処理は、製品の生産計画に基づいて、各製品の製造に必要な部品の所要量を計算し、計算した所要量を部品の引当可能数から差し引くことで、在庫を引き当てる。
2.正展開処理、逆展開処理及び所要量計算処理に用いる SQL
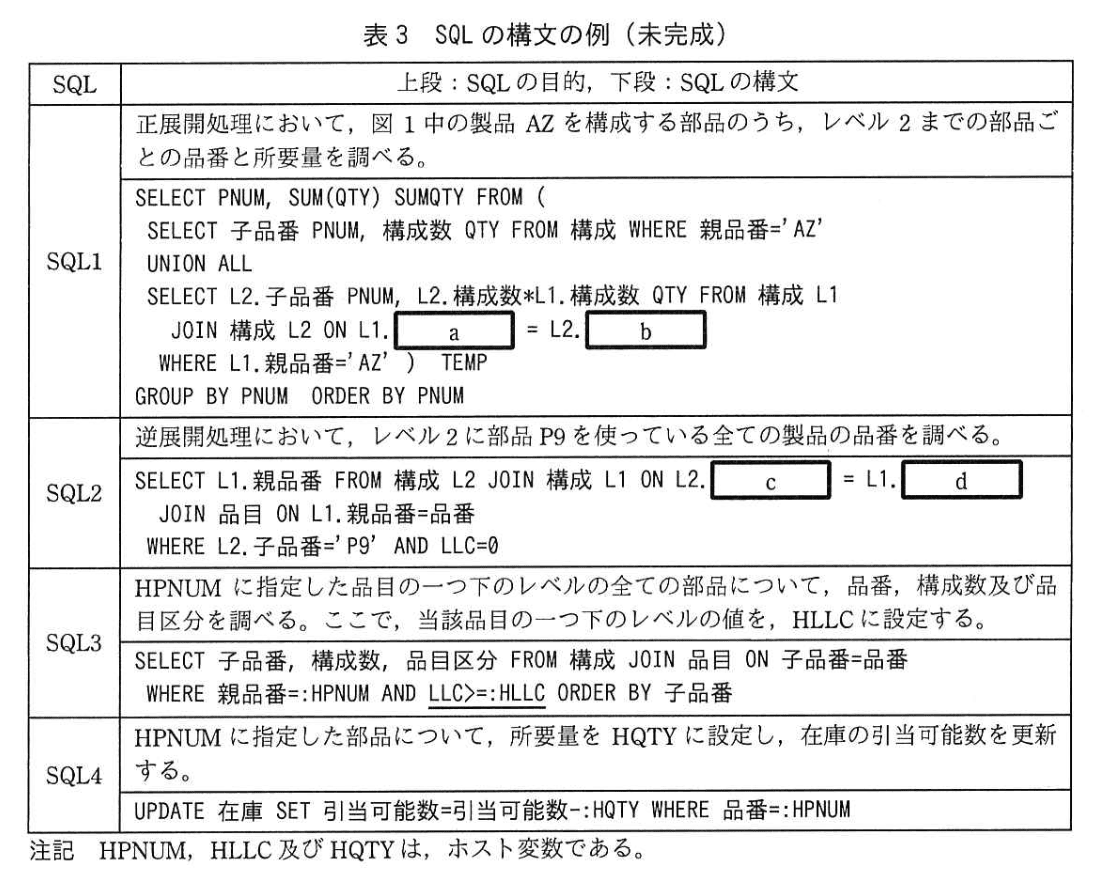
Fさんは、部品表に対する三つの基本的な処理に用いられるSQLの構文の例を、表3に示した。
〔所要量計算処理プログラムの概要〕
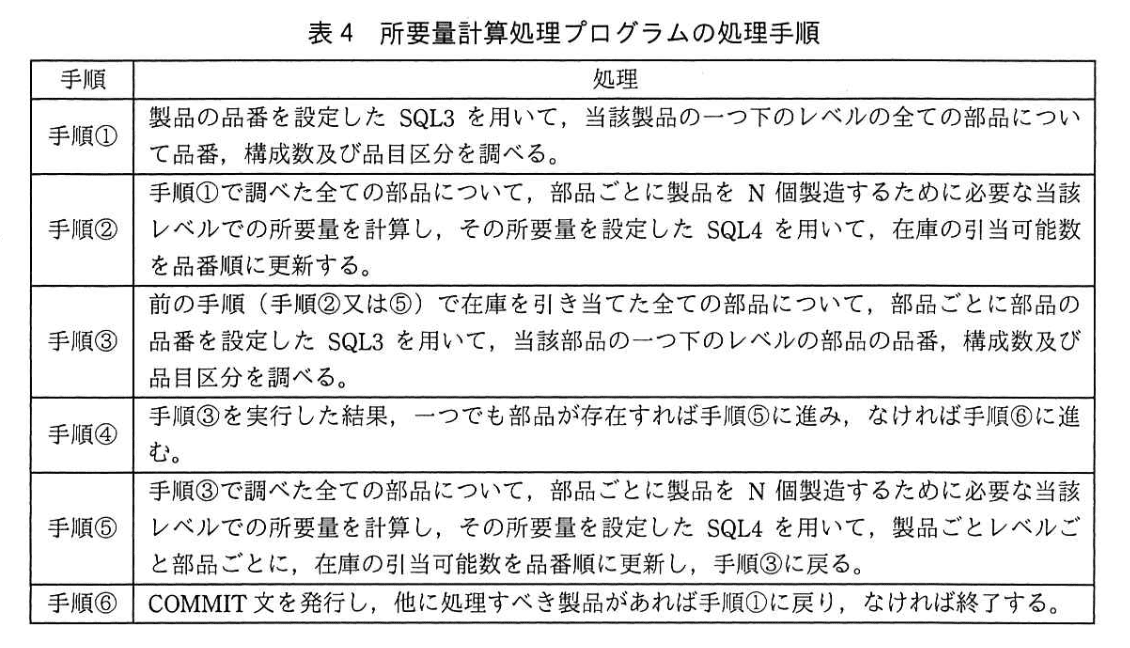
所要量計算処理プログラムは、表3中のSQL3及びSQL4を用いる。 Fさんは、製品をN個製造する場合の所要量計算処理プログラムの処理手順を、表4に示した。
なお、当該処理は、次の前提で行うものとする。
(1) 各部品の所要量の計算は、SQL3を用いて調べた構成数に基づいて、プログラムのロジックで行う。
(2) ISOLATIONレベルは、READ COMMITTEDとする。
(3) 製品が複数ある場合、製品の品番順に、製品ごとに手順 ①〜⑥を繰り返す。
(4) 在庫は、適切に管理されているので、引当可能数が負の数になることはない。
〔Fさんの研修内容に対するK部長の指示〕
表4について、K部長から次のような指示があった。
指示1:表4中の手順③のSQL3の発行回数を減らすために、手順①及び③のSQL3で部品の品目区分を調べている。 その理由を説明すること。
指示2:品目の設計変更において、例えば、製品AXの部品P3を新部品P11に置き換えるべきところ、誤って部品P1を “構成” テーブルに登録してしまった場合、SQL3の構文中に下線部分の述語が指定されていなければ、プログラムは不具合を起こすことを説明すること。
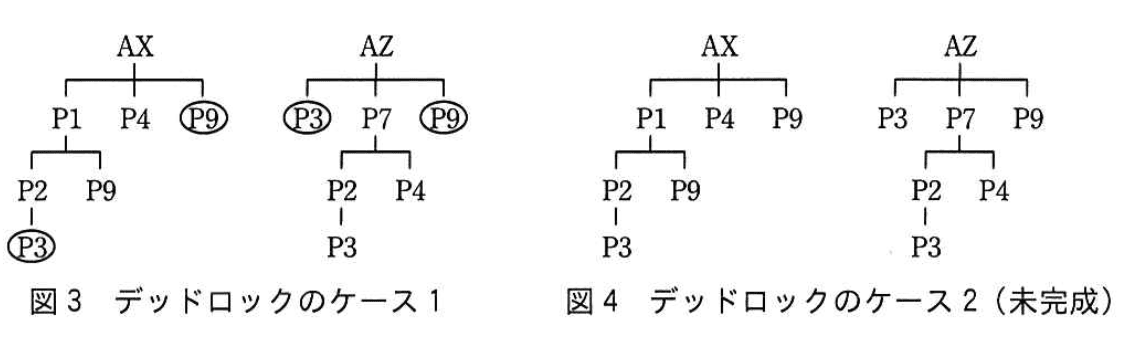
指示3:製品は多品種なので、スループット向上のために所要量計算を製品ごとに分割して並行処理している。 しかし、表4の処理手順のままではデッドロックが起きるので、プログラムを改良したことを説明すること。
(1)図1中の(ア)〜(ウ)に入れる適切な字句を答えよ。
模範解答
ア:P3
イ:P6
ウ:P8
解説
解答の論理構成
-
製品AYの一次子部品を確認
-
表2よりAY | P5 | 1 AY | P9 | 1
-
よってレベル1でAYが持つ部品はP5とP9。
-
-
部品P5の子部品を確認
-
表2よりP5 | P3 | 1 P5 | P6 | 1
-
したがってレベル2でP5が持つ部品はP3とP6。
-
ここで図1の(ア)・(イ)は “P5の子” に該当する。
⇒ (ア)= P3、(イ)= P6
-
-
部品P6の子部品を確認
-
表2よりP6 | P8 | 1 P6 | P9 | 1
-
したがってレベル3でP6が持つ部品はP8とP9。
-
図1の(ウ)は “(イ)=P6の子” のうち、まだ図に現れていない方。
⇒ (ウ)= P8
-
-
以上より(ア)P3, (イ)P6, (ウ)P8
誤りやすいポイント
- 図の矢印や枝数に惑わされ、「P9」ばかりに注目してしまう。子部品の網羅は表2で確認するのが安全です。
- “構成数”の列と“親子関係”の列を混同し、同じ親品番が複数行に現れることを見落としやすい。
- レベル概念(0,1,2…)と “親子テーブル” の関係を対応付けないまま図を補完しようとしてミスを誘発。
FAQ
Q: 図が未完成でも表2だけで正解できますか?
A: はい。【問題文】に「図1に基づいて登録した“構成”テーブルの行を表2に示す」とあるため、親子関係は表2が公式情報です。
A: はい。【問題文】に「図1に基づいて登録した“構成”テーブルの行を表2に示す」とあるため、親子関係は表2が公式情報です。
Q: 構成数(例えば1や2)は今回の空欄補充に影響しますか?
A: いいえ。空欄は“品番”を問うもので、数量は解答に影響しません。構成数は所要量計算など別処理で使用します。
A: いいえ。空欄は“品番”を問うもので、数量は解答に影響しません。構成数は所要量計算など別処理で使用します。
Q: P9が複数レベルに登場しますがレベル判定のコツは?
A: 親品番を起点に階層を一段ずつ下りながらカウントします。AY→P5→P6→P9の場合、P9はレベル3になります。
A: 親品番を起点に階層を一段ずつ下りながらカウントします。AY→P5→P6→P9の場合、P9はレベル3になります。
関連キーワード: 部品表、親子関係、階層レベル、所要量計算

(2)表2中の(エ)〜(カ)に入れる適切な字句を答えよ。
模範解答
エ:P7
オ:P7
カ:P2
解説
解答の論理構成
-
図1には製品AZがレベル1で三つの部品を持ちます。その一つが「P7」である。
よって、親「AZ」に対する欠損行は親品番 = 'AZ'、子品番 = 'P7'であり、(エ)は「P7」です。 -
同じく図1において、部品P7の一つ下のレベル(レベル2)に「P2」と「P4」が存在します。
表2を確認すると、P7 P4 1の行は既に登録済みですが、P7→P2の行が抜けています。
したがって不足行は親品番 = 'P7'、子品番 = 'P2'であり、(オ)は「P7」、(カ)は「P2」です。 -
構成数については図1に具体値が提示されていないため、既に表2に記載されている同列行と照合し、構成数「1」を引き継ぎます。
誤りやすいポイント
- 「P7」はAZとP7の二ヵ所で登場します。親側と子側の別を取り違えると (エ) と (オ) を混同しがちです。
- 図1と表2を並べて見ずに暗記頼みで判断すると、既に存在する行「P7 P4 1」を新設と誤認しやすいです。
- 図1でレベルが深くなると、同じ部品番号(例:P3)が複数箇所に現れるため、親品番を必ずセットで確認する必要があります。
FAQ
Q: 構成数が図に書かれていない場合、どうやって決めるのですか?
A: 問題文中に「構成数を省略している」と明記されている場合は、既存の表2を参照して一貫性を取ります。本問では同レベルの他行がすべて「1」なので、それに合わせて「1」と判断します。
A: 問題文中に「構成数を省略している」と明記されている場合は、既存の表2を参照して一貫性を取ります。本問では同レベルの他行がすべて「1」なので、それに合わせて「1」と判断します。
Q: 図1で同じ部品が複数階層に現れたとき、LLCはどう使いますか?
A: LLCは“最も深い階層”を示す値です。逆展開処理で影響範囲を調べるときに利用しますが、本問の空欄補充では親‐子関係の確認だけで足ります。
A: LLCは“最も深い階層”を示す値です。逆展開処理で影響範囲を調べるときに利用しますが、本問の空欄補充では親‐子関係の確認だけで足ります。
Q: エラーチェック用に親品番と子品番を逆にして登録したらどうなりますか?
A: 正展開・逆展開ともに誤結果を返し、特に所要量計算では不足部品を過小・過大計算する恐れがあります。登録時に外部キーまたは整合性チェックを設けるべきです。
A: 正展開・逆展開ともに誤結果を返し、特に所要量計算では不足部品を過小・過大計算する恐れがあります。登録時に外部キーまたは整合性チェックを設けるべきです。
関連キーワード: BOM, 階層構造、親子関係、構成数
設問2:〔部品表に対する基本的な処理〕 の正展開処理について、(1)、(2)に答えよ。
問題文を見る(1)表3中のSQL1の(a)、(b)に入れる適切な字句を答えよ。
模範解答
a:子品番
b:親品番
解説
解答の論理構成
- 【問題文】の説明
- 構成テーブルの列名は 「親品番」「子品番」「構成数」。
- 正展開処理は「親品目がどの子品目を使っているかを、階層を上から下に1階層ずつたどる」方法。
- SQL1の意図
- 第1SELECTで レベル1(親品番='AZ')を取得。
- UNION ALL 直後のSELECTで レベル2 を取得するために、別名 L1(レベル1行)と L2(レベル2行)を自己結合。
- 結合条件を決める
- レベル1行の 「子品番」 が、次階層行の 「親品番」 と一致したときにのみ階層がつながる。
- よってL1.(a) = L2.(b) には
- (a) → 子品番
- (b) → 親品番
を入れるのが唯一妥当。
- 結果
- (a) = 子品番
- (b) = 親品番
誤りやすいポイント
- 正展開なのにL1.親品番 = L2.子品番 と逆に書いてしまう。
- 品番 と 親品番/子品番 を混同する。品目テーブルの列は結合に関与しません。
- UNION と UNION ALL の違いを無視して重複排除を行い、所要量が過少になる。
FAQ
Q: なぜ自己結合が必要なのですか?
A: 構成テーブルは1行で1階層分しか保持していないため、レベル間をつなぐには同じテーブルを階層数分だけ重ねて結合する必要があります。
A: 構成テーブルは1行で1階層分しか保持していないため、レベル間をつなぐには同じテーブルを階層数分だけ重ねて結合する必要があります。
Q: UNION ALL ではなく UNION にすると何が起こりますか?
A: 同一部品が複数経路で現れた場合に重複行が除外され、SUM(QTY) が小さく計算されます。したがって正しい所要量になりません。
A: 同一部品が複数経路で現れた場合に重複行が除外され、SUM(QTY) が小さく計算されます。したがって正しい所要量になりません。
Q: レベル3以降も取得したい場合は?
A: 同じパターンで自己結合を追加し、ON L2.子品番 = L3.親品番 … と階層数分チェーンを延ばします。再帰SQLを使う方法もあります。
A: 同じパターンで自己結合を追加し、ON L2.子品番 = L3.親品番 … と階層数分チェーンを延ばします。再帰SQLを使う方法もあります。
関連キーワード: 正展開、階層問い合わせ、自己結合、隣接リスト、UNION ALL
設問2:〔部品表に対する基本的な処理〕 の正展開処理について、(1)、(2)に答えよ。
問題文を見る(2)製品AZを1個製造するのに必要な、部品P2, P3及びP4の所要量をそれぞれ答えよ。
模範解答
P2:2
P3:5
P4:2
解説
解答の論理構成
-
階層の把握
【問題文】には「製品のレベルを0として、階層を一つ下るごとにレベルに1を加算する」とある。図1を正展開するとレベル0 : AZ
レベル1 : P3(1)、P7(2)、P9(2)
レベル2 : P2(1×2)、P4(1×2) ※P7の下
レベル3 : P3(2×2) ※P2の下 -
経路ごとの掛け算
- AZ→P7→P2 … 2 × 1 = 2(P2)
- AZ→P7→P4 … 2 × 1 = 2(P4)
- AZ→P3 … 1 (P3)
- AZ→P7→P2→P3 … 2 × 1 × 2 = 4(P3)
-
品番別に集計
- P2:2
- P4:2
- P3:1+4=5
-
よって答案は 「P2:2」「P3:5」「P4:2」 となる。
誤りやすいポイント
- レベル1の 「P3」(直接子)とレベル3の 「P3」(P2の下)を合計し忘れる。
- 「AZ→P7」の構成数 2 を掛け忘れ、P2とP4をそれぞれ1個と誤算する。
- 正展開では“下へたどるたびに掛け算”であり、加算から入ってしまうとミスが出やすい。
FAQ
Q: 「構成数」はどこで確認できますか?
A: 【問題文】表2“構成”テーブルの「構成数」列、及び図1の枝に付く数字が該当します。
A: 【問題文】表2“構成”テーブルの「構成数」列、及び図1の枝に付く数字が該当します。
Q: 直接子と間接子が同じ品番の場合、LLCを使ってフィルタすべきですか?
A: 今回の正展開では全レベルを対象に合算するため、LLCで除外せず品番単位で集計します。
A: 今回の正展開では全レベルを対象に合算するため、LLCで除外せず品番単位で集計します。
Q: 正展開処理と所要量計算処理の違いは?
A: 正展開は品番と数量を階層展開で取得するだけ、所要量計算は取得結果を用いて在庫を更新する点が異なります。
A: 正展開は品番と数量を階層展開で取得するだけ、所要量計算は取得結果を用いて在庫を更新する点が異なります。
関連キーワード: 正展開、構成数、階層構造、所要量、集計
設問3:〔部品表に対する基本的な処理〕 の逆展開処理について、(1)、(2)に答えよ。
問題文を見る模範解答
c:親品番
d:子品番
品番:AX
解説
解答の論理構成
- SQL2の目的確認
【問題文】「逆展開処理において、レベル2に部品P9を使っている全ての製品の品番を調べる。」
⇒ 子品目 “P9” がレベル2で使用される位置を起点に、1階層上(親)→さらに1階層上(製品)へさかのぼる。 - 自己結合で階層を上がる列
-
“構成” テーブルの列は【問題文】「親品番」「子品番」「構成数」。
-
子から親へ上がるにはL2.親品番 = L1.子品番しかない。
⇒ (c)=“親品番”、(d)=“子品番”。
-
- LLC=0の意味
- 【問題文】「製品のレベルを0」と定義。
- “品目” テーブル行をLLC=0でフィルタすれば“製品”だけ残る。
- これにより自己結合で2階層上がった先が製品かどうかを保証。
- 結果判定
- 図1の構成より、レベル2で “P9” が現れるのは “AX” → “P1” → “P9”。
- 他の製品 (“AY”、“AZ”) では “P9” はレベル1または3で使用。
⇒ 出力は “AX”。
誤りやすいポイント
- “L2.子品番 = 'P9'” を「レベル1の使用」と早合点し、自己結合条件を逆に書いてしまう。
- “LLC = 0” があるので “品目” テーブルを必ず結合しなければならない点を忘れ、製品以外も結果に含めてしまう。
- “構成” テーブルに複合主索引が定義されていると想定し、索引列順を (親品番、子品番) と勘違いして列名を入れ替える。
FAQ
Q: “構成” テーブルを2回結合せずにレベル2を取得できますか?
A: 再帰SQLを使えば1つの WITH 句で任意レベルまで展開できます。ただし本試験の想定はSQL標準の自己結合で1階層ずつ上がる方法です。
A: 再帰SQLを使えば1つの WITH 句で任意レベルまで展開できます。ただし本試験の想定はSQL標準の自己結合で1階層ずつ上がる方法です。
Q: “LLC” を使わずに製品行かどうかを判定する方法は?
A: 例えば “品目区分 = '製品'” で絞る設計も可能ですが、【問題文】には “LLC” が用意されているため、設問では “LLC = 0” を使う前提になっています。
A: 例えば “品目区分 = '製品'” で絞る設計も可能ですが、【問題文】には “LLC” が用意されているため、設問では “LLC = 0” を使う前提になっています。
Q: レベル3以上を調べたい場合の書き換えポイントは?
A: 自己結合の回数を増やすか、WITH 句の再帰結合を利用して階層数をパラメータ化します。
A: 自己結合の回数を増やすか、WITH 句の再帰結合を利用して階層数をパラメータ化します。
関連キーワード: 自己結合、階層問い合わせ、ローレベルコード、逆展開処理
設問3:〔部品表に対する基本的な処理〕 の逆展開処理について、(1)、(2)に答えよ。
問題文を見る(2)SQL2が参照する全てのテーブルのアクセスパスは、索引探索に決められるようにしたい。 “構成” テーブルにユニーク索引を追加する場合、その索引を構成する全ての列名を定義順に答えよ。
模範解答
子品番、親品番
解説
解答の導き方
-
根拠となるルールを押さえる。問題文のRDBMS仕様に「索引探索に決められるためには、 WHERE 句の AND だけで結ばれた一つ以上の等値比較の述語の対象列が、 索引キーの全体又は先頭から連続した一つ以上の列に一致していなければならない。 ON 句の場合も同様である。」とある。つまり、索引が利用されるためには、等値比較がインデックスキーの先頭からの連続した列に一致している必要がある(ON句の等値も条件に含まれるが、後述するように実行順序の影響を受ける)。
-
SQL2 の等値条件を確認する。SQL2 の目的は「逆展開処理において、レベル2に部品 P9 を使っている全ての製品の品番を調べる。」であり、SQL 文の該当部には「WHERE L2.子品番 = 'P9' AND LLC = 0」と「JOIN 構成 L1 ON L2.(c) = L1.(d)」がある。ここで SQL の構造と目的から、L2 は子品番が 'P9' である行(P9 を子にもつ行)を表し、その L2.親品番 がレベル1 の品目になる。レベル1 の品目を親に持つ行は L1 で表されるはずなので、結合条件は L2.親品番 = L1.子品番 に対応すると推定できる。したがって SQL2 における (c) は 親品番、(d) は 子品番 を指す。
-
構成テーブルで索引を効かせるために必要な列を決める。上の確認より、SQL2 において構成テーブルに関係する等値比較の列は 子品番(L2.子品番 = 'P9')と 親品番(L2.親品番 = L1.子品番)である。RDBMS 仕様の条件に照らすと、WHERE にある等値比較である L2.子品番 = 'P9' を確実に先頭列と一致させられるように、索引の先頭を 子品番 にする必要がある。こうすると
- L2 の取得は WHERE L2.子品番 = 'P9' で先頭列が定数に一致するため確実に索引探索になる。
- L2の取得結果(L2.親品番)を使ってL1を参照する場合も、L1側で 子品番 に対する等値検索(L1.子品番 = L2.親品番)として同じインデックス(先頭が 子品番)を利用した索引探索が可能になる(ON句の等値が索引利用のトリガーとなるため)。
-
実行計画(結合順序)を踏まえた理由づけ。ON句の等値は索引利用に寄与するものの、結合の実行順序(どちらを外側にするか)によって「どの列が定数化されるか」が変わるため、ON句だけに頼ると索引用を保証できない場合がある。SQL2 のように WHERE に定数等値(L2.子品番 = 'P9')があると、子品番を先頭に置く索引(子品番、親品番)にしておけば、どのような実行順序でも L2 は必ず索引探索で絞り込め、そこから L1 や 品目 を索引で結合する計画を取りやすくなる。以上から、構成する列の定義順は子品番、親品番
が最適であると導ける。
誤りやすいポイント
- ON句の等値だから必ず索引が効くと考える点。ON句の等値も索引条件になり得るが、実行計画(結合順序)によっては先頭列の一致が得られず索引が使えないことがあるため、確実に使いたい列を先頭にする必要がある。
- テーブル定義の列順(親品番→子品番)に合わせて索引を作ると、WHERE の等値(子品番 = 'P9')が先頭列と一致しなくなり、L2 のアクセスが表探索(インデックス未使用)になる。
- ユニーク索引を子品番だけにしてしまう誤り。子品番は複数の親に現れる可能性があるため、ユニーク性を満たさない(意図した一意性が保証されない)。
FAQ
Q: ON句の等値はまったく無視してよいですか?
A: いいえ。問題文にもあるように「ON 句の場合も同様である」ため、ON句の等値も索引利用の条件になり得ます。ただし、結合順序によってはその等値が先頭列の一致につながらないことがあるので、必ず使いたい列(ここでは WHERE に定数等値がある子品番)を索引の先頭に置いておくのが安全です。
A: いいえ。問題文にもあるように「ON 句の場合も同様である」ため、ON句の等値も索引利用の条件になり得ます。ただし、結合順序によってはその等値が先頭列の一致につながらないことがあるので、必ず使いたい列(ここでは WHERE に定数等値がある子品番)を索引の先頭に置いておくのが安全です。
Q: ユニーク索引の列順は一意性に影響しますか?
A: 一意性そのものは列の集合で決まるため、列順は一意性の有無を変えません。ただし、索引の列順は検索条件への適合(先頭からの一致)に大きく影響するため、検索に使う列を先頭に置く必要があります。
A: 一意性そのものは列の集合で決まるため、列順は一意性の有無を変えません。ただし、索引の列順は検索条件への適合(先頭からの一致)に大きく影響するため、検索に使う列を先頭に置く必要があります。
Q: なぜ親品番、子品番の順にしてはいけないのですか?
A: その順にすると WHERE の等値(L2.子品番 = 'P9')が索引の先頭列と一致せず、構成テーブルの L2 側で索引が利用されない可能性が高まります。SQL2 では子品番に定数等値があるため、子品番を先頭にする設計が必要です。
A: その順にすると WHERE の等値(L2.子品番 = 'P9')が索引の先頭列と一致せず、構成テーブルの L2 側で索引が利用されない可能性が高まります。SQL2 では子品番に定数等値があるため、子品番を先頭にする設計が必要です。
関連キーワード: 部品表、複合索引、等値比較、結合順序、索引探索
設問4:〔Fさんの研修内容に対するK部長の指示〕 について、(1)〜(4)に答えよ。
問題文を見る(1)指示1に対して、なぜ部品の品目区分を調べれば、SQL3の発行回数を減らすことができるのか、その理由を30字以内で述べよ。
模範解答
単体部品は子部品がないのでSQL3の発行は不要だから
解説
解答の論理構成
- 前提整理
- SQL3は「子品番、構成数、品目区分」を取得し、次階層の部品探索に用いる。
- 品目区分が与える意味
- 「単体部品」は【問題文】にあるとおり「単独で使われる」=子品番を持たない。
- 発行回数削減の仕組み
- 手順①または③で取得した部品の品目区分が「単体部品」であれば、その部品については以後SQL3を発行しても結果集合が空であることが確定。
- よって単体部品を見つけた時点で探索を打ち切れば、SQL3の呼び出し総数を「単体部品の個数」だけ減らせる。
- まとめ
- 以上から「単体部品は子部品がないのでSQL3の発行は不要」となる。
誤りやすいポイント
- 「単体部品でも誤って複数レベルを持つ可能性がある」と思い込み、SQL3を発行し続ける。
- 品目区分がNULLの場合を考慮せずに判定ロジックを組み、例外で落ちる。
- 中間部品と単体部品を品目コードだけで判別し、区分カラムを参照しない実装にしてしまう。
FAQ
Q: 中間部品でも実際には子部品が無い場合、SQL3をスキップして良いですか?
A: 区分が「中間部品」でも登録ミスで子部品が無いケースを否定できません。区分だけでなく件数チェックも併用すると安全です。
A: 区分が「中間部品」でも登録ミスで子部品が無いケースを否定できません。区分だけでなく件数チェックも併用すると安全です。
Q: 品目追加時に区分を誤登録するとどうなりますか?
A: 「単体部品」を「中間部品」として登録すると、空結果を得るためだけにSQL3を発行する無駄が発生し、性能低下の原因になります。
A: 「単体部品」を「中間部品」として登録すると、空結果を得るためだけにSQL3を発行する無駄が発生し、性能低下の原因になります。
関連キーワード: 階層構造、再帰問合せ、インデックス、トランザクション
設問4:〔Fさんの研修内容に対するK部長の指示〕 について、(1)〜(4)に答えよ。
問題文を見る(2)指示2に対して、プログラムが起こす不具合とは、処理がどのようになることか、20字以内で述べよ。
模範解答
処理が無限ループして終わらない。
解説
解答の導き方
まず押さえるべき要点は次の二つです。SQL3 の WHERE 句は「親品番 = :HPNUM AND LLC >= :HLLC」となっており、SQL3 の説明に「当該品目の一つ下のレベルの値を、HLLCに設定する」とある点です。さらに表1から P1 の LLC は 1、P2 の LLC は 2、P3 の LLC は 3 であることを使います。
この前提で、表4の手順に従って具体的に辿ると、述語あり/なしで挙動がどう変わるかが明確になります。
-
正常(述語「AND LLC >= :HLLC」がある)場合の追跡
- 製品AXを処理する最初の呼び出し:HPNUM = AX。説明どおりAXの一つ下のレベルをHLLCに設定するのでHLLC = 1。
- SQL3 は WHERE 親品番 = 'AX' AND LLC >= 1 を実行し、AX の一つ下の部品 P1(LLC=1)、P4(LLC=2)、P9(LLC=3) を返します。
- 次にHPNUM = P1の呼び出し:P1の一つ下のレベルをHLLCに設定するのでHLLC = 2。
- SQL3 は WHERE 親品番 = 'P1' AND LLC >= 2 を実行し、P2(LLC=2)、P9(LLC=3) を返します。
- 次にHPNUM = P2の呼び出し:HLLC = 3。
- SQL3 は WHERE 親品番 = 'P2' AND LLC >= 3 を実行し、P3(LLC=3) を返します。
- 次にHPNUM = P3の呼び出し:HLLC = 4。
- SQL3 は WHERE 親品番 = 'P3' AND LLC >= 4 を実行します。P1 は LLC=1 なので 1 >= 4 は偽であり返されません。したがってここで子が存在せず処理は深さ方向に進まず終了(手順⑥で COMMIT)します。
- まとめ:述語により「常に一段以上深い(LLCが増える方向)」の要素だけを取得するため、循環リンクがあっても祖先を逆にたどることが抑止されます。
- 製品AXを処理する最初の呼び出し:HPNUM = AX。説明どおりAXの一つ下のレベルをHLLCに設定するのでHLLC = 1。
-
異常(誤登録があり、かつ述語がない)場合の追跡
- ここで問題の誤登録は、設計変更ミスとしてP3の子としてP1を誤って登録する(構成に 親品番='P3' 子品番='P1' の行を追加する)ケースを想定します。これにより構成表にサイクルP1 → P2 → P3 → P1が生じます。
- 述語がないと、P3 のときの SQL3 は単に WHERE 親品番 = 'P3' を実行するだけで、P1(LLC=1) も返します。すると処理は再び P1 を処理し、P2 → P3 → P1 の循環を無限にたどり続けます。
- 表4 の流れでは、手順④で「一つでも部品が存在すれば手順⑤に進む」ため、この循環が続く限り手順⑥(COMMIT)に到達せず、処理は終わりません。
以上から、SQL3の下線部(述語)が抜けているとプログラムは循環を切れずに終了しなくなります。よって不具合は次のとおりです。
処理が無限ループして終わらない。
誤りやすいポイント
- LLCとその「値」が示す意味を混同する
LLCは「品目が出現するレベルの最大値」であり、製品内での現在の深さと混同すると誤った比較をする原因になります。 - HLLCの設定値を誤解する
SQL3 説明の「一つ下のレベルの値を HLLC に設定する」を、曖昧に扱うと WHERE 比較の方向(>=)を取り違えます。実運用では HLLC は当該 HPNUM の一つ下のレベル(今回のデータでは事実上 HPNUM.LLC + 1)です。 - 「述語がない=ただの効率低下」と誤認する
述語欠如は単なる性能問題にとどまらず、構成の誤登録(サイクル)と組み合わさると論理的な無限ループを招く点を見落としやすいです。 - 無限ループとデッドロックを取り違える
この設問は論理的な循環による無限ループであり、複数トランザクション間の待ち合い(デッドロック)とは異なります。
FAQ
Q: HLLCは具体的にどう決めるのですか?
A: 問題文の説明どおり「当該品目の一つ下のレベルの値をHLLCに設定」します。実例ではHPNUMのLLCに1を足した値が次の検索下限になります(例:P1のLLC=1 → HLLC=2)。
A: 問題文の説明どおり「当該品目の一つ下のレベルの値をHLLCに設定」します。実例ではHPNUMのLLCに1を足した値が次の検索下限になります(例:P1のLLC=1 → HLLC=2)。
Q: なぜ「LLC >= :HLLC」で循環が防げるのですか?
A: 正しい構成(木構造)では、子のLLCは常に親の一つ下のレベル以上を持つため、下限を指定することで「浅い(祖先側の)品目」を誤って取得することを防げます。誤登録で祖先を子として持つ行があっても、その祖先はLLCが小さいため除外されます。
A: 正しい構成(木構造)では、子のLLCは常に親の一つ下のレベル以上を持つため、下限を指定することで「浅い(祖先側の)品目」を誤って取得することを防げます。誤登録で祖先を子として持つ行があっても、その祖先はLLCが小さいため除外されます。
Q: 他に循環を防ぐ手段はありますか?
A: データ登録時にサイクル検出を行う、もしくは構成表に制約・チェックを設けて祖先を子にできないようにするなどの対策が考えられます。
A: データ登録時にサイクル検出を行う、もしくは構成表に制約・チェックを設けて祖先を子にできないようにするなどの対策が考えられます。
関連キーワード: 再帰処理、循環参照(サイクル)、トランザクション分離レベル、フィルタ条件、デッドロック
設問4:〔Fさんの研修内容に対するK部長の指示〕 について、(1)〜(4)に答えよ。
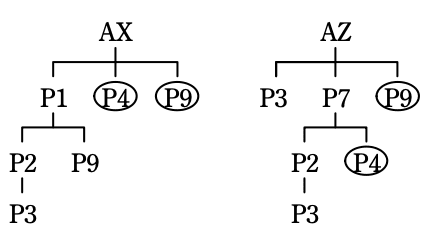
問題文を見る(3)指示3で述べられたデッドロックについて、Fさんは、図1の製品AXとAZの間で起きるデッドロックの一つのケースを、ケース1として図3に示し、デッドロックに関わる2種類の部品の組合せを丸印で囲んだ。 図3に倣って、他にデッドロックが起きるケースをケース2として、図4を完成させよ。
模範解答
解説
解答の論理構成
-
更新の順序を整理
- 表4の手順②および⑤には「在庫の引当可能数を品番順に更新する。」とあります。
- トランザクションは UPDATE 在庫 … WHERE 品番 = :HPNUM(SQL4)を実行すると、その行に排他ロックを取り COMMIT まで保持 します(ISOLATION レベルは"READ COMMITTED"でも更新行ロックは解放されません)。
-
並行処理される2本のトランザクション
- 製品 "AX" を処理するトランザクションをT₁、製品 "AZ" を処理するトランザクションをT₂とします。
- 各トランザクションが レベル1→レベル2… と深く潜りながらSQL4を品番昇順で発行する手順を追います。
-
レベル1で取得するロック
- T₁(AX)のレベル1部品昇順 → P1 → P4 → P9
- T₂(AZ)のレベル1部品昇順 → P3 → P7 → P9
- T₂が先にレベル1の P9 まで更新すると、T₁は P1・P4 を更新して保持したまま、レベル1の P9 の更新でT₂のロック解放を待つ状態になります。
-
レベル2で取得するロック
- T₂はレベル1を終えてレベル2に進み、昇順で P2 → P4 を更新しようとします。既にT₁が P4 を保持しているため待ち状態になります。
-
デッドロックの成立
- T₁:P4を保持し、レベル1のP9を要求
- T₂:P9を保持し、レベル2のP4を要求
- 双方が互いのロック解除を待つ 待ち‐待ち関係 となりデッドロック発生。
-
図4完成のポイント
- デッドロックに関与する2行を丸印で示す必要があるため、
• AX側:保持している P4 と待っている P9
• AZ側:保持している P9 と待っている P4 - これが模範解答図の「P4」「P9」に丸印を付ける理由です。
- デッドロックに関与する2行を丸印で示す必要があるため、
誤りやすいポイント
- 「品番順で更新しているから安全」と思い込み、レベルが変わると順序が逆転する事実を見落としがちです。
- READ COMMITTED なのでロックは短時間と誤認し、更新行ロックは COMMIT まで保持される点を忘れがちです。
- SQL4が単純な1行更新のためロック競合を軽視し、複数階層で同一部品が再出現する可能性を考慮しないことが多いです。
FAQ
Q: 順序を統一してもデッドロックが起きるのはなぜですか?
A: 品番順は各レベル内での順序です。別レベルに降りると取ろうとする行集合が変わり、結果として他トランザクションと逆順になるためです。
A: 品番順は各レベル内での順序です。別レベルに降りると取ろうとする行集合が変わり、結果として他トランザクションと逆順になるためです。
Q: READ COMMITTEDならロックが短くなるのでは?
A: 読み取りロックは解除されますが、更新系(UPDATE)の排他ロックはトランザクション終了まで保持されます。そのため待ち‐待ちが容易に成立します。
A: 読み取りロックは解除されますが、更新系(UPDATE)の排他ロックはトランザクション終了まで保持されます。そのため待ち‐待ちが容易に成立します。
Q: 対策は何ですか?
A: 代表的には①全トランザクションで 階層を横断した絶対順序(品番だけでなくレベルも含めたキー) で更新する、②子部品の所要量を一括計算しバッチで更新する、③行ロックではなく楽観的ロック+リトライ方式を採る、などがあります。
A: 代表的には①全トランザクションで 階層を横断した絶対順序(品番だけでなくレベルも含めたキー) で更新する、②子部品の所要量を一括計算しバッチで更新する、③行ロックではなく楽観的ロック+リトライ方式を採る、などがあります。
関連キーワード: デッドロック, 排他ロック, トランザクション分割, 行ロック保証, 並行更新
設問4:〔Fさんの研修内容に対するK部長の指示〕 について、(1)〜(4)に答えよ。
問題文を見る(4)指示3に対して,Fさんは、プログラムの改良について、次のように説明した。“SQL4を、製品ごとレベルごと部品ごとに実行するのではなく、製品ごと部品ごとに集計した所要量をホスト変数HQTYに設定してから表4の手順⑥の前に実行するように、手順②〜⑤を改良しました。”
この説明に加えて、複数回のSQL4をどのように実行するべきか20字以内で述べよ。
模範解答
SQL4を部品の品番順に実行する。
解説
解答の論理構成
- 問題文の該当箇所
- 「手順②…在庫の引当可能数を品番順に更新する。」
- 「手順⑤…在庫の引当可能数を品番順に更新し…」
これらは当初からロック取得順を統一する設計意図を示しています。
- デッドロックが発生した理由
- 旧処理では「製品ごとレベルごと部品ごと」にSQL4を発行し、製品AXはP1→P4→P9、製品AZはP3→P7→P9のように別順序でロックを取得します。
- 二つのトランザクションが交差すると相互待ちが発生し、【図3】のようなデッドロックに至ります。
- 改良内容
- 「製品ごと部品ごとに集計した所要量」を求め、SQL4をまとめて発行する。
- そして「品番順」に統一すれば、全トランザクションが必ず同じロック順序で在庫行を更新するためデッドロックが解消します。
- 20字以内の求められた記述
- 列名と実行方法を明示する必要がある → 「SQL4を部品の品番順に実行する。」(全角19字)
誤りやすいポイント
- 「部品ごとに実行」だけでは順序が曖昧で減点対象です。
- ロックの粒度(行ロック)だから順序は無関係と誤解しないこと。行ロックでも取得順序はデッドロック要因になります。
- ORDER BY 句を UPDATE 文に直接書けない RDBMS もあるため、アプリ側で並び替えて連続実行する実装が必要です。
FAQ
Q: なぜ「品番」以外の列順では駄目なのですか?
A: 手順②・⑤が更新順として採用している列が「品番」であり、全トランザクションが一致させる基準を問題文が指定しているためです。他の列では一意順序を保証できず問題の前提を満たしません。
A: 手順②・⑤が更新順として採用している列が「品番」であり、全トランザクションが一致させる基準を問題文が指定しているためです。他の列では一意順序を保証できず問題の前提を満たしません。
Q: LOCK TABLE でテーブル全体をロックすれば簡単では?
A: 可能ですがスループットが大幅に低下し、問題文の「多品種なので…並行処理している」という要件と矛盾します。行ロック+順序統一が現実的です。
A: 可能ですがスループットが大幅に低下し、問題文の「多品種なので…並行処理している」という要件と矛盾します。行ロック+順序統一が現実的です。
関連キーワード: デッドロック、ロック順序、排他制御、行ロック、更新順序

