
データベーススペシャリスト 2024年 午後1 問03
情報システム会社のプロジェクト稼働管理システムのデータベース物理設計・SQL設計・性能に関する次の記述を読んで、設問に答えよ。
情報システム会社のE社は、自社のプロジェクト稼働管理システム (以下、PJシステムという)を、RDBMSを用いて更改することになり、Fさんが実装を任された。
〔RDBMSの主な仕様〕
1.DMLのアクセス経路は、RDBMSによって索引探索又は表探索が選択される。
2.索引は、クラスタ性という性質によって、高クラスタな索引と低クラスタな索引に分けられる。
・高クラスタな索引は、キー値の順番と、キーが指す行の物理的な並び順が一致しているか、完全に一致していなくても、隣接するキーが指す行が同じページに格納されている割合が高い。
・低クラスタな索引は、キー値の順番と、キーが指す行の物理的な並び順が一致している割合が低く、行へのアクセスがランダムになる。
〔業務の概要〕
1.組織、従業員、役職、ランク、時間単価
(1) E社には、複数の組織がある。 組織は階層構造であり、最上位の組織以外はいずれか一つの上位組織に属する。
(2) 従業員は、従業員コードで識別し、いずれか一つの組織に属する。
(3) 役職には、SE, シニアSE, マネージャなどがある。 役職は役職コードで識別する。 従業員はいずれか一つの役職をもつ。
(4) ランクは、労務費の時間単価を区別するもので、ランクコードで識別する。役職はいずれか一つのランクに対応する。
(5) 時間単価は、ランク別組織別年月日別に決めている。 組織の変更、従業員の異動などによって、月初に時間単価を見直すことがある。
2.プロジェクト、稼働計画、稼働実績
(1) プロジェクト (以下、PJという)は、従業員の稼働状況を管理する単位である。 従業員は複数のPJに参加することがあり、PJに参加していない従業員も一部いる。
(2) PJに必要な人員を要員という。
(3) PJ開始前に稼働計画を立案するとき、要員ごと参加年月ごとに計画時間を見積もる。 参加する従業員が確定したとき、稼働計画の要員に対して従業員を割り当てる。 PJ開始後、必要に応じて計画を修正する。
(4) PJに参加している各従業員は、稼働実績として月内の日別PJ別の稼働時間を入力する。 従業員は同じ日に複数PJの稼働時間を入力できる。
〔PJシステムのテーブル〕
1.テーブル構造、列の意味・制約、統計情報・索引定義
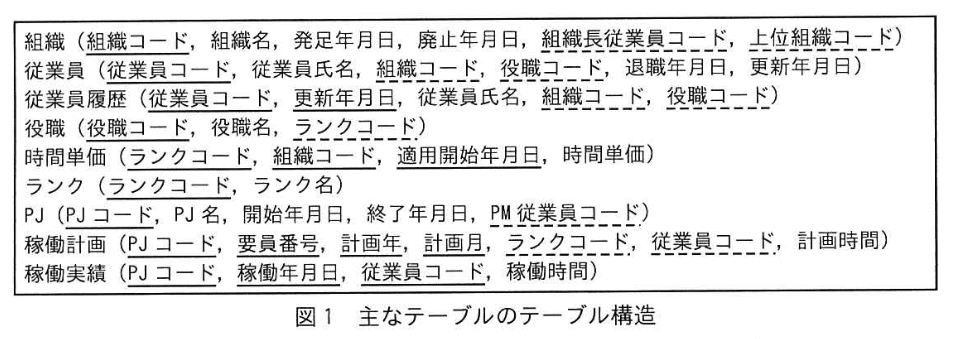
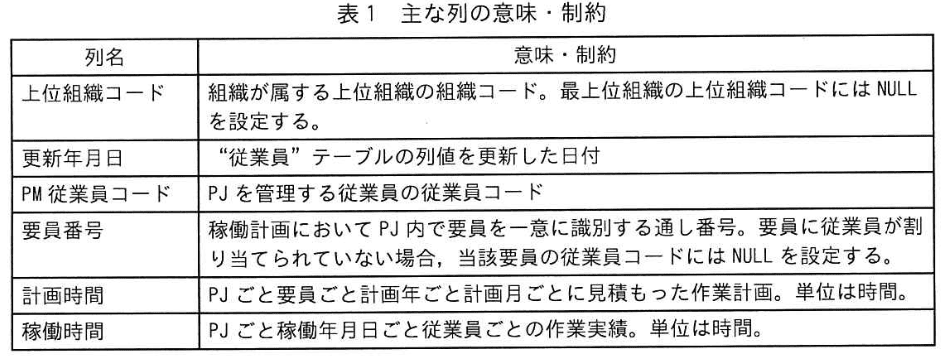
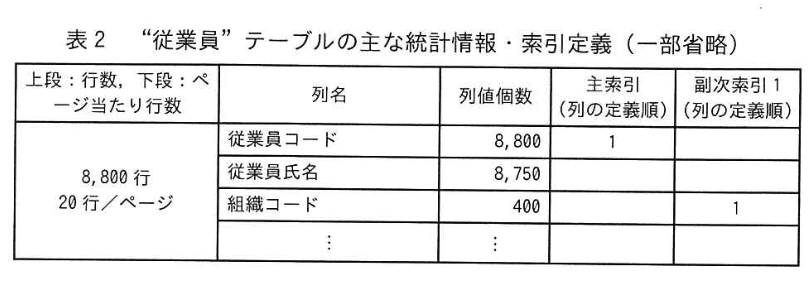
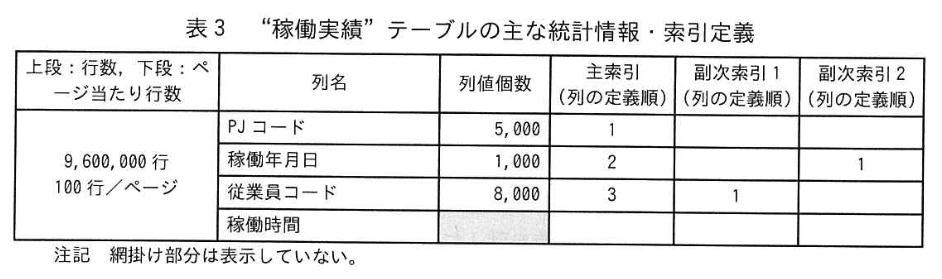
主なテーブルのテーブル構造を図1に、主な列の意味・制約を表1に示す。 また、“従業員” テーブルの主な統計情報・索引定義を表2に、“稼働実績” テーブルの主な統計情報・索引定義を表3に示す。
2.“従業員” テーブルの行更新における更新履歴処理
“従業員”テーブルの組織コード、役職コードを更新するとき、当該従業員の更新前の行を更新の履歴として “従業員履歴” テーブルに挿入する。
3.“組織” テーブルの行削除処理
E社では、組織の改廃がある。 PJ管理に不要になった組織コードを削除する場合、次のような手順で行う。
① 廃止済みの組織であり、かつ、PJ が終了済みなど PJ 管理に不要と判断できる組織コードを、SELECT文を用いて調べる。
② ①で調べた組織コードの行を、“組織” テーブルから DELETE文を用いて削除する。
〔テーブルの定義と実装〕
1.テーブルの定義
(1) Fさんは、図1中の各テーブルを定義する CREATE TABLE 文を設計した。 ここで、各 CREATE TABLE 文には外部キー制約を実装することとした。 そのうち、“組織” テーブルを定義する CREATE TABLE 文を、図2に示す。
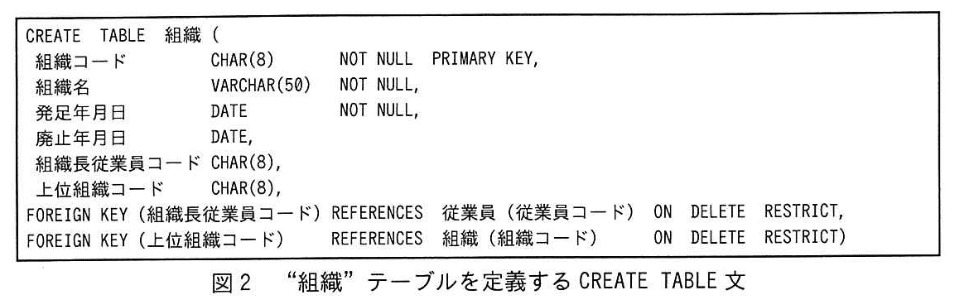
(2) Fさんは、他の表が未定義の状態で “組織” テーブルを定義する図2の CREATE TABLE 文を実行したところ失敗した。 そこで、Fさんは、図2の CREATE TABLE 文を見直し、次の①〜③の順番で定義を実行したところ、全ての実行が成功した。
① “組織”テーブルを定義する図2中から、(a)を外部キーとする指定を削除した CREATE TABLE 文を実行する。
② “従業員”、“役職”、“時間単価”、“ランク” の各テーブルを定義する CREATE TABLE 文を“(b)”、“(c)”、“役職”、“d”の順番で実行する。
③ “組織” テーブルに対する(e)文を用いて、(a)を外部キーとする指定の定義を追加する。
2.テーブルへの行登録
次に,Fさんは、“組織”テーブルに INSERT 文を用いて行を挿入した。次いで“従業員”、“役職”、“時間単価”、“ランク” の各テーブルに対しても INSERT 文を用いて行を挿入した。 その後、UPDATE 文で適宜列値を更新した。
〔稼働計画の立案・ 稼働実績の確認〕
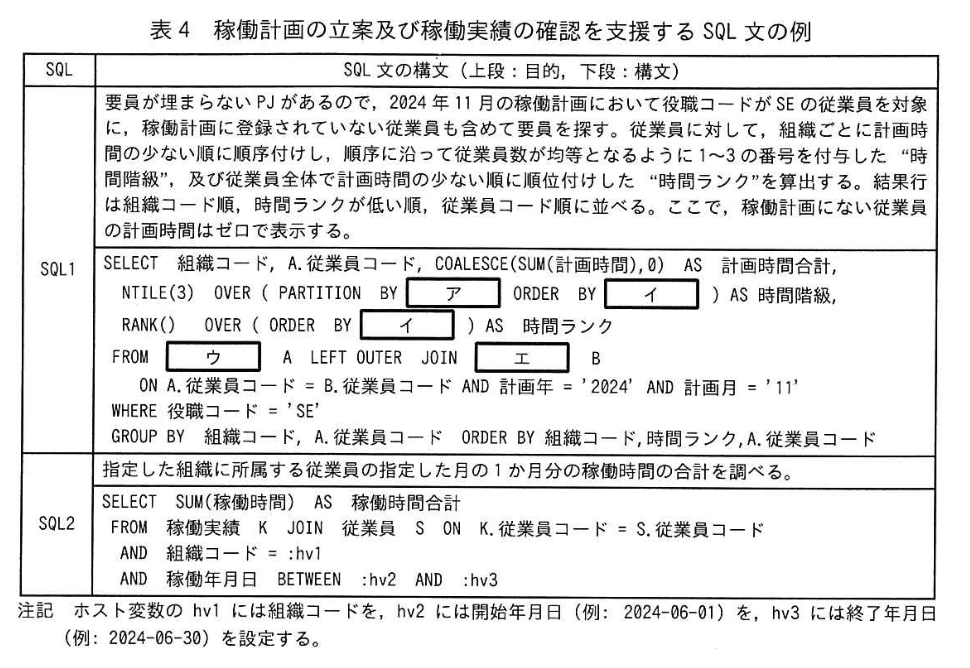
Fさんは、稼働計画の立案及び稼働実績の確認を支援するためのSQL文を設計した。設計したSQL文の例を、表4に示す。
〔問合せの性能改善〕
Fさんは、“稼働実績” テーブルへの問合せに利用される表4中のSQL2について、性能の改善を依頼された。 Fさんが調べたところ、稼働実績を一括入力する従業員が多く、1か月単位で見たとき、行の登録順が従業員、稼働年月日、PJコード順であり、従業員当たり1か月分の行が高々2ページに格納されることが分かった。 そこで、索引のクラスタ性と次の三つの前提を踏まえて、(1) 〜(5) の手順で性能改善を試みた。
・それぞれの列値は均等に分布していると仮定する。
・PJに参加しない従業員だけで構成される組織はないと仮定する。
・全従業員が同じ曜日で働いていると仮定し、1か月は20日として計算する。
(1) SQL2のアクセス経路として、"従業員” テーブルを外表、“稼働実績” テーブルを内表とする入れ子ループ結合を想定する。
(2) このアクセス経路では、まず外表から指定した組織コードに対して、外表の副次索引を用いて平均22行を読み込む。 外表の副次索引は低クラスタな索引なので、最大で(f)ページを読み込む。
(3) 外表から読み込んだ従業員コード1件ごとに、内表の副次索引1を用いて①従業員1人当たりの稼働実績である1,200行を読み込み、行データの稼働年月日に対して BETWEEN 述語を評価する。 表3の稼働年月日列の列値個数は1,000 (50か月分)なので、 内表の集計対象は(g)行である。 稼働実績を計上している従業員は組織当たり(h)人なので、集計対象の行は組織当たり(i)行となる。 内表の副次索引1は高クラスタなので、読込みページ数は組織当たり最大(j)ページである。
(4) 次に、読込みページ数を削減するために、{従業員コード、稼働年月日 }をキーとする副次索引3を追加した場合の性能を検討した。この索引を使用した場合、副次索引と比較すると、1か月分を索引で絞り込めるので、表からの読込み行数及び読込みページ数は(k)分の1に削減される。
(5) 副次索引3の利用によって、表からの読込み行数及び読込みページ数を削減できるので、副次索引3を実装することにした。
設問1:〔テーブルの定義と実装〕について答えよ。
問題文を見る(1)“1. テーブルの定義” について、本文中の(a)〜(e)に入れる適切な字句を答えよ。
模範解答
a:組織長従業員コード
b:ランク
c:時間単価
d:従業員
e:ALTER TABLE
解説
解答の論理構成
-
(a) を決定
- 図2の定義に「FOREIGN KEY (組織長従業員コード) REFERENCES 従業員 (従業員コード)」と明示されている。
- 未定義の「従業員」表を参照するため CREATE TABLE が失敗したという流れより、外部キー列は「組織長従業員コード」と判断できる。
-
(b)〜(d) を決定
- 手順②に「“従業員”、“役職”、“時間単価”、“ランク” の各テーブルを…“(b)”、“(c)”、“役職”、“d”の順番で実行」とある。
- 依存関係
・「役職」は「ランク」を参照。
・「時間単価」は「ランク」と「組織」を参照。
・「従業員」は「組織」と「役職」を参照。 - 参照されない最初のテーブルは「ランク」→(b)。
- 次に「ランク」が存在すれば作成可能で、まだ「役職」を参照しない「時間単価」→(c)。
- 「役職」は既に「ランク」があるので続けて作成、指定どおり名前をそのまま記載。
- 最後に「従業員」→(d)。
-
(e) を決定
- 手順③では「“組織” テーブルに対する(e)文を用いて…外部キー…を追加」とある。
- 既存表に制約を付け足す標準 SQL 文は ALTER TABLE であり、他の候補 (UPDATE, INSERT など) では制約定義は行えない。
誤りやすいポイント
- 図中の列名と同じ語をそのまま解答するルールを見落として文字種や全角・半角を変えてしまう。
- 「時間単価」と「従業員」の順序を逆にして依存関係を崩す。
- 外部キー追加に CREATE INDEX などを選んでしまう。
FAQ
Q: 外部キー制約を後から追加する理由は何ですか?
A: 参照先テーブルがまだ存在しない段階では CREATE TABLE が失敗します。まず最小限の制約で表を作り、依存先がそろった後に ALTER TABLE で追加することで整合性を確保できます。
A: 参照先テーブルがまだ存在しない段階では CREATE TABLE が失敗します。まず最小限の制約で表を作り、依存先がそろった後に ALTER TABLE で追加することで整合性を確保できます。
Q: 「時間単価」が「役職」を参照していないのに順番を先にするのはなぜ?
A: 「時間単価」は参照先が「ランク」と「組織」だけなので、「ランク」が作成済みであれば「役職」より先に定義できます。問題文が指定している順序に合わせることがポイントです。
A: 「時間単価」は参照先が「ランク」と「組織」だけなので、「ランク」が作成済みであれば「役職」より先に定義できます。問題文が指定している順序に合わせることがポイントです。
関連キーワード: 外部キー制約、テーブル作成順序、ALTER TABLE, 参照整合性、依存関係

設問1:〔テーブルの定義と実装〕について答えよ。
問題文を見る(2)“2. テーブルへの行登録” において、“組織” テーブルへ行を挿入する場合、外部キーである組織長従業員コード及び上位組織コードのそれぞれについて、考慮すべき事項を一つずつ、25字以内で答えよ。
模範解答
組織長従業員コード:挿入時にNULLを設定しておくこと
上位組織コード:最上位組織から上位順に組織を登録すること
解説
解答の論理構成
- 外部キー制約の確認
- 図2で「FOREIGN KEY (組織長従業員コード) REFERENCES 従業員 (従業員コード)」と定義。
- 同図で「FOREIGN KEY (上位組織コード) REFERENCES 組織 (組織コード)」と自己参照。
- 挿入時の制約回避策
- 組織長従業員コード
- 先に組織を登録する時点では組織長となる従業員が「従業員」テーブルにまだ存在しないケースが多い。
- したがって制約に抵触しないよう NULL を設定しておき、後で UPDATE する。
- 上位組織コード
- 自己参照のため同一テーブル内に親行が必要。
- 表1に「最上位組織の上位組織コードにはNULLを設定する。」とあるので、 ①最上位をNULLで登録 → ②下位を親→子の順で登録、で整合性を保つ。
- 組織長従業員コード
誤りやすいポイント
- 両方の外部キーをまとめて「NULLにすればよい」と思い込む
→ 上位組織コードは最上位以外NULLにできない。 - 自己参照外部キーの存在を忘れ、下位組織から挿入してエラーになる。
- 組織長従業員コードに仮のコードを入れて後で削除しようとし、参照整合性違反を起こす。
FAQ
Q: 組織長従業員が未定のまま更新を忘れても問題ないですか?
A: 将来的に参照整合性を満たす必要があるため、NULL のままでも違反ではありませんが、業務的に必ず UPDATE で設定する運用ルールを作るべきです。
A: 将来的に参照整合性を満たす必要があるため、NULL のままでも違反ではありませんが、業務的に必ず UPDATE で設定する運用ルールを作るべきです。
Q: 上位組織コードを後で UPDATE してもよいですか?
A: 可能ですが、自己参照外部キーなので UPDATE 時にも親行が存在していなければ失敗します。登録順を整える方が安全です。
A: 可能ですが、自己参照外部キーなので UPDATE 時にも親行が存在していなければ失敗します。登録順を整える方が安全です。
Q: 一括登録ツールを作る場合の注意点は?
A: 組織データは親子関係をトップダウンでソートし、従業員データを事前に入れるか、組織長従業員コードを NULL で入れた後にまとめて UPDATE する2フェーズ方式にするとエラーを防げます。
A: 組織データは親子関係をトップダウンでソートし、従業員データを事前に入れるか、組織長従業員コードを NULL で入れた後にまとめて UPDATE する2フェーズ方式にするとエラーを防げます。
関連キーワード: 外部キー制約、自己参照、NULL 値、参照整合性、INSERT 順序
設問1:〔テーブルの定義と実装〕について答えよ。
問題文を見る(3)F さんは、図1中のテーブルのうち、“時間単価” テーブルの定義では、外部キーである “組織コード” のDELETE オプションを CASCADE に指定した。 SET NULL 又は RESTRICT を指定した場合、“時間単価” テーブルの定義時又は“組織” テーブルの行削除時に制約違反で失敗するおそれがあると考えたからである。 なぜ制約に違反するのか、理由をそれぞれ45字以内で具体的に答えよ。
模範解答
SET NULLの場合:“時間単価” テーブルの組織コードは主キーの一部でありNULLに変更できないから
RESTRICTの場合:“時間単価” テーブルに同じ組織コードの行が存在する場合があるから
解説
解答の導き方
設問は、時間単価テーブルの外部キーである組織コードに対して ON DELETE オプションを SET NULL または RESTRICT にすると「制約違反で失敗するおそれがある」理由を問うものです。問題文の該当箇所を順にたどって結論に至る考え方を示します。
-
子側の列が主キー相当であることを確認する
本文には「時間単価は、ランク別組織別年月日別に決めている」とあり、図1に「時間単価(ランクコード、組織コード、適用開始年月日、時間単価)」と列が並んでいます。業務上ランク・組織・年月日で時間単価を一意に管理することが明示されているため、ランクコード・組織コード・適用開始年月日が主キーに相当する設計と判断できます(主キーの列はNULLを許容しません)。 -
親表の組織コードの定義を確認する
図2 の CREATE TABLE 文に「組織コード CHAR(8) NOT NULL PRIMARY KEY」とあります。親表側の組織コードは主キー列であることが明確です。 -
ON DELETE SET NULL の影響と失敗の理由
ON DELETE SET NULL は「親行削除時に子表の外部キー列を NULL に書き換える」動作です。しかし、上で判定したとおり時間単価の組織コードは主キーの一部であり NULL を許容しない列です。したがって、子側の組織コードを NULL にできないため、外部キー制約の定義時(子表の定義で NULL 非許容が矛盾する)あるいは親行削除時に制約違反で失敗します。 -
ON DELETE RESTRICT の影響と失敗の理由
ON DELETE RESTRICT は「子表に参照行が存在する場合、親行の削除を禁止する」動作です。問題文で F さんは「次いで…時間単価…の各テーブルに対しても INSERT 文を用いて行を挿入した」とあるため、時間単価に当該組織コードを参照する行が存在する可能性があります。よって親表から組織行を削除しようとすると参照が残っていて RESTRICT により削除が拒否され、失敗します。
最終的な具体的理由(要旨)
- SET NULLの場合:時間単価テーブルの組織コードは主キーの一部でありNULLに変更できないから
- RESTRICTの場合:時間単価テーブルに同じ組織コードの行が存在する場合があるから
誤りやすいポイント
- ON DELETE SET NULL は「親表の値を変える」と誤解する(正しくは子表の外部キー列を NULL にする動作です)。
- 図1の業務記述「ランク別組織別年月日別…」を見落とし、組織コードが主キーの一部であることを判断できない。
- 主キー列は自動的に NOT NULLである点を忘れて SET NULLが許されると思い込む。
- RESTRICTがいつエラーを出すか(定義時か削除時か)を混同する。RESTRICTは削除時の参照有無で拒否される。
FAQ
Q: 子側の組織コード列がNULL許容なら SET NULLは問題ないですか?
A: はい。子側列が NULL を許容するなら CREATE TABLE 時に ON DELETE SET NULL を定義できますし、親削除時に子側の外部キーが NULL に書き換わります。ただし業務上その列が主キー相当である設計なら NULL 許容は矛盾になります。
A: はい。子側列が NULL を許容するなら CREATE TABLE 時に ON DELETE SET NULL を定義できますし、親削除時に子側の外部キーが NULL に書き換わります。ただし業務上その列が主キー相当である設計なら NULL 許容は矛盾になります。
Q: RESTRICTとCASCADEの使い分けはどう考えればよいですか?
A: RESTRICTは子が存在すれば親削除を禁止します。CASCADEは親削除時に自動で子も削除します。削除された親に紐づく子を残す必要があるか、あるいは子をまとめて消してよいかで選びます(業務要件と履歴要件を優先して決めます)。
A: RESTRICTは子が存在すれば親削除を禁止します。CASCADEは親削除時に自動で子も削除します。削除された親に紐づく子を残す必要があるか、あるいは子をまとめて消してよいかで選びます(業務要件と履歴要件を優先して決めます)。
Q: CREATE TABLE 時に外部キーオプションでエラーになるのはどんな場合ですか?
A: 外部キーで ON DELETE SET NULL を指定しても、子側の参照列が NOT NULL(たとえば主キー列)だと定義時に矛盾となりエラーになります。実装によっては削除時にのみエラーになる挙動もあるため、DBMS の仕様を確認してください。
A: 外部キーで ON DELETE SET NULL を指定しても、子側の参照列が NOT NULL(たとえば主キー列)だと定義時に矛盾となりエラーになります。実装によっては削除時にのみエラーになる挙動もあるため、DBMS の仕様を確認してください。
関連キーワード: 外部キー、主キー、参照整合性、NOT NULL 制約、ON DELETE SET NULL、ON DELETE RESTRICT
設問2:
問題文を見る(1)〔稼働計画の立案・稼働実績の確認〕について、表4中のSQL1の(ア)〜(エ)に入れる適切な字句を答えよ。
模範解答
ア:組織コード
イ:COALESCE(SUM(計画時間),0)
ウ:従業員
エ:稼働計画
解説
解答の論理構成
-
PARTITION BY の検討
SQL1の目的文に「組織ごとに計画時間の少ない順に順位付けし、順位に沿って従業員数が等分となるように1〜3の番号を付与」とある。等分処理は NTILE(3)。よって PARTITION 単位=「組織コード」。 -
ORDER BY の検討
目的文に「計画時間の少ない順に順位付け」とある。また稼働計画が無い従業員は 0 として扱う旨も明記されている。「COALESCE(SUM(計画時間),0)」は SELECT 句と同一で、NULL→0 の変換を含む唯一の候補。 -
FROM 句のテーブル選定
“役職コード = 'SE' の従業員”という条件は「従業員」テーブルにしか存在しないため、A別名を付ける基表は「従業員」。 -
LEFT OUTER JOIN 先
目的文に「稼働計画に登録されていない従業員を含めて」とある。欠落行を補完するため従業員側を残す LEFT OUTER JOIN が必要。残りのテーブル候補「稼働計画」を B として結合する。 -
ウインドウ関数の二重使用
同一の計画時間合計で NTILE と RANK を取るので ORDER BY 句は両方とも同一式「COALESCE(SUM(計画時間),0)」を再記述する。集計列の別名はウインドウ関数の中では参照できないため式を直接書く必要がある。
誤りやすいポイント
- 集計列別名をウインドウ関数内で直接使ってエラーになる。
- LEFT OUTER JOIN の向きを逆にして未登録従業員が欠落する。
- ORDER BY に単純な「SUM(計画時間)」を書き、NULL が 0 として扱われず意図しない順位になる。
- NTILE の PARTITION BY を指定し忘れ、全組織をまとめて3階級にしてしまう。
FAQ
Q: 「COALESCE」を使わずにNULLを0にできませんか?
A: MIN/MAX 集計であればNULL無視で済む場合もありますが、SUM はNULLを返す可能性があるため問題文の「ゼロで表示」要件を満たすには「COALESCE(SUM(計画時間),0)」が必要です。
A: MIN/MAX 集計であればNULL無視で済む場合もありますが、SUM はNULLを返す可能性があるため問題文の「ゼロで表示」要件を満たすには「COALESCE(SUM(計画時間),0)」が必要です。
Q: ウインドウ関数内で SELECT 句の別名が使えないのはなぜ?
A: SQL 標準ではウインドウ関数の評価順序が SELECT 句より後段階であり、同一 SELECT 項目の別名はまだ解決されていないためです。式をそのまま再掲するか、サブクエリで一度別名を確定させる必要があります。
A: SQL 標準ではウインドウ関数の評価順序が SELECT 句より後段階であり、同一 SELECT 項目の別名はまだ解決されていないためです。式をそのまま再掲するか、サブクエリで一度別名を確定させる必要があります。
Q: “稼働計画” が無い従業員を抽出したい場合、LEFT OUTER JOIN だけで十分ですか?
A: 可能ですが、NULL だった行を判定する IS NULL 条件を WHERE 句に追加することで“未登録従業員のみ”に限定できます。本問は“含めて計算”なので追加条件は不要です。
A: 可能ですが、NULL だった行を判定する IS NULL 条件を WHERE 句に追加することで“未登録従業員のみ”に限定できます。本問は“含めて計算”なので追加条件は不要です。
関連キーワード: ウインドウ関数、NTILE, LEFT OUTER JOIN, COALESCE, 集約関数
設問3:〔問合せの性能改善〕について答えよ。
問題文を見る模範解答
PJに参加していない従業員も一部いるから
解説
解答の導き方
- 表の数値から事実を読み取ります。表2の“従業員”テーブルの従業員コードの列値個数は「8,800」、表3の“稼働実績”テーブルの従業員コードの列値個数は「8,000」と示されています。これは稼働実績側に登場する異なる従業員の数が従業員テーブルの登録数より少ないことを意味します。
- 用語の意味を整理します。問題文中の「列値個数」はその列に現れる異なる値の個数(=DISTINCTな値の個数)を示します。一方で稼働実績テーブルの行数は「1人の従業員が複数日の実績や複数PJで複数行を持つ」ため多くなり得ます。
- 業務の記述を確認します。業務の概要に「従業員は複数のPJに参加することがあり、 PJに参加していない従業員も一部いる」とあります。これは、すべての従業員が稼働実績に記録されるわけではないことを示します。
- 以上より結論を導きます。稼働実績テーブルの「従業員コードの列値個数」が従業員テーブルより小さいのは、稼働実績に記録されない(=PJに参加していない)従業員が存在するからです。
解答:PJに参加していない従業員も一部いるから
誤りやすいポイント
- 「列値個数」を「行数」と混同する:行数は重複を含むが列値個数は異なる値の個数である点を見落とす。
- 稼働実績の行数が多いから必ず多くの従業員が参加していると誤解する:実際は同一従業員の複数行である場合が多い。
- 「重複は存在しない」と考える誤り:稼働実績では同一従業員コードが複数行で現れる(複数日・複数PJ)点を忘れる。
- 集計対象(列値個数の差)を別の要因(削除やデータ不整合)と早合点する。
FAQ
Q: 列値個数と行数の違いは何ですか?
A: 列値個数はその列に出現する異なる値の個数(DISTINCT値の数)を指します。行数は重複を含む総行数です。稼働実績は同一従業員が複数行を持つため行数≫列値個数となることがあります。
A: 列値個数はその列に出現する異なる値の個数(DISTINCT値の数)を指します。行数は重複を含む総行数です。稼働実績は同一従業員が複数行を持つため行数≫列値個数となることがあります。
Q: 稼働実績に従業員が出ないケースは他にありますか?
A: 業務記述にあるように「PJに参加していない従業員」が最も直接的な理由です。加えて退職や異動で期間内に実績がない場合もありますが、本問の根拠は前者です。
A: 業務記述にあるように「PJに参加していない従業員」が最も直接的な理由です。加えて退職や異動で期間内に実績がない場合もありますが、本問の根拠は前者です。
Q: 表の数値を見て集計ミスを疑ったらまず何を確認すべきですか?
A: 「列値個数が DISTINCT を意味するか」「行の重複(同一従業員の複数行)があるか」「対象期間や条件が一致しているか」を確認してください。
A: 「列値個数が DISTINCT を意味するか」「行の重複(同一従業員の複数行)があるか」「対象期間や条件が一致しているか」を確認してください。
関連キーワード: 列値個数、DISTINCT、重複、外部結合、集計
設問3:〔問合せの性能改善〕について答えよ。
問題文を見る(2)本文中の(f)に入れる適切な数値を答えよ。
模範解答
f:22
解説
解答の論理構成
- 外表(“従業員”)の対象行数を把握
【問題文】には
「まず外表から指定した組織コードに対して、…平均22行を読み込む。」
と明記されている。したがって対象行は22行。 - 索引のクラスタ性を確認
【問題文】
「外表の副次索引は低クラスタな索引」
低クラスタ索引は【RDBMSの主な仕様】で説明されるとおり、- 「キーが指す行の物理的な並び順が一致している割合が低く、行へのアクセスがランダムになる。」
つまり1行取得するたびに別ページに飛ぶ可能性が高い。
- 「キーが指す行の物理的な並び順が一致している割合が低く、行へのアクセスがランダムになる。」
- ページ数の上限を決定
行が22行、各行が別ページに散らばっている最悪ケースでは
読み込むページ数 = 行数 = 22
したがって (f) = 22となる。
誤りやすいポイント
- 低クラスタでも「20行/ページだから ⌈22÷20⌉=2ページ」と勘違いする。高クラスタなら近い値になるが、低クラスタは行ごとにページ散在と考える。
- 行数22を計算せず、400組織という列値個数だけを見てしまう。
- 「平均22行だから平均22/20ページ」と“平均”をそのままページ数に適用してしまう。設問は“最大”ページ数を求めている。
FAQ
Q: クラスタ性が高い場合はページ数はいくつになりますか?
A: 高クラスタなら行が連続配置されるため、 ページが上限に近い値となります。
A: 高クラスタなら行が連続配置されるため、 ページが上限に近い値となります。
Q: なぜ「最悪の場合」で計算するのですか?
A: 索引アクセス時にキャッシュに載っていないページが連続して要求されるとI/Oがボトルネックになります。性能評価では保守的に“最大ページ数”を見積もるのが一般的です。
A: 索引アクセス時にキャッシュに載っていないページが連続して要求されるとI/Oがボトルネックになります。性能評価では保守的に“最大ページ数”を見積もるのが一般的です。
関連キーワード: クラスタ性、副次索引、ページアクセス、入れ子ループ結合、均等分布
設問3:〔問合せの性能改善〕について答えよ。
問題文を見る(3)下線①について、稼働年月日列の列値個数が1,000であるにもかかわらず、従業員1人当たりの稼働実績の行数が1,000よりも多いのはなぜか。 本文中の用語を用いて、30字以内で答えよ。
模範解答
従業員は同日に複数PJの稼働時間を入力できるから
解説
解答の論理構成
- 列値個数1,000は日付の種類数を示すだけ
- 行の粒度は表1の説明より「PJごと稼働年月日ごと従業員ごと作業実績」
- 問題文には「従業員は同じ日に複数PJの稼働時間を入力できる。」と明記
- よって同じ日付が複数行に現れ、従業員1人当たりの行数が1,000より多くなる
誤りやすいポイント
- 列値個数=最大行数と短絡し、複合キーで重複行が生じることを忘れる
- 「複数月分のデータだから増える」と月数だけに注目し、同日複数PJの条件を見落とす
- 行数計算で「PJコード」の存在を無視し、日付×従業員だけで考えてしまう
FAQ
Q: 列値個数と行数はどう違うのですか?
A: 列値個数は個々の列に現れる異なる値の種類数、行数はテーブル全体のレコード数です。複合キーに他列が加われば同じ列値でも別行になります。
A: 列値個数は個々の列に現れる異なる値の種類数、行数はテーブル全体のレコード数です。複合キーに他列が加われば同じ列値でも別行になります。
Q: 複数PJ入力がなければ行数はいくつになりますか?
A: 各従業員が50か月×20日=1,000行となり、列値個数と一致します。複数PJがあるため1,200行程度に増えています。
A: 各従業員が50か月×20日=1,000行となり、列値個数と一致します。複数PJがあるため1,200行程度に増えています。
Q: 行数見積もりは何に使われますか?
A: 読み込みページ数や索引選択などのアクセスプラン評価に用います。正確な行数見積もりは性能改善の前提です。
A: 読み込みページ数や索引選択などのアクセスプラン評価に用います。正確な行数見積もりは性能改善の前提です。
関連キーワード: 複合キー、行数見積もり、クラスタ索引、入れ子ループ結合、BETWEEN述語
設問3:〔問合せの性能改善〕について答えよ。
問題文を見る(4)本文中の(g)〜(k)に入れる適切な数値を答えよ。
模範解答
g:24
h:20
i:480
j:2,000
k:50
解説
解答の導き方
以下は問題文中の数値・記述をそのまま根拠として用い、途中の考えを省かず順を追って説明します。最終解答は文末にまとめます。
-
g(内表の集計対象:従業員1人当たりの該当行数)
- 問題文の統計情報から「稼働実績」の総行数が「9,600,000行」であり、列値個数として「従業員コード」が「8,000」であることが分かります。したがって従業員1人当たりの平均行数は 行です(この1,200行は全月分の累計)。
- また「稼働年月日列の列値個数は1,000(50か月分)」とあるので、50か月で均等分布すると1か月分は 行になります。
- よってg = 24。
-
h(組織当たり稼働実績を計上している従業員数)
- 「従業員」テーブルの行数が「8,800行」で、組織コードの列値個数が「400」なので、従業員の組織当たり平均は 人です。
- ただし稼働実績に登場する従業員は8,000人(表3の従業員コード列値個数)です。問題文の前提で「PJに参加しない従業員だけで構成される組織はない」としてよいので、組織当たりの「稼働実績を計上している従業員数」は平均を8,000/8,800の比で補正できます: 人。
- よってh = 20。
-
i(組織当たりの集計対象行数)
- 1人当たりの該当行数gと組織当たりの人数hを掛けます: 行。
- よってi = 480。
-
j(内表の副次索引1が高クラスタであるときの、組織当たりの最大読込みページ数)
- ここは「最大」で評価する点に注意します。問題文に「従業員当たり1か月分の行が高々2ページに格納されることが分かった」とあり、また稼働年月日は「1,000(50か月分)」とされています。副次索引1は従業員コードだけをキーにした索引であり、日付で絞り込まずに索引経由で行を読み込むと、各従業員について50か月分(全期間)を読み込む必要があります(本文は「従業員1人当たりの稼働実績である1,200行を読み込み、... BETWEEN 述語を評価する」と明示しています)。
- 「高々2ページ/月」という上限を最悪ケース(最大)で積み上げると、従業員1人あたりの全期間の最大ページ数は となります。
- 組織当たりh = 20人なので、組織当たりの最大読込みページ数は ページとなります。
- (補足:平均的・連続的に格納されている前提なら ページ/人、組織で ページと算出できますが、設問は「最大(j)ページ」を問うため「高々2ページ/月」を最悪に積み上げた を採ります。)
- よってj = 2,000。
-
k(副次索引3の導入による行数・ページ数の削減倍率)
- 副次索引3を {従業員コード, 稼働年月日} の複合キーで作ると、索引上で「1か月分」に直接絞り込めます。稼働年月日の列値個数が50か月分であるため、従来読み込んでいた全期間分が50分の1に縮小されます。
- 数値で見ると、従来は従業員1人当たり 行を読み、導入後はその の 行だけを読みます。従って削減倍率は です。
- よってk = 50。
最終まとめ(設問の値)
- g:24
- h:20
- i:480
- j:2,000
- k:50
誤りやすいポイント
-
hを単に「従業員テーブルの平均(22)」とだけして終わらせる誤り。稼働実績に登場する従業員数(8,000)と従業員テーブルの総数(8,800)が異なるため、稼働実績を計上している実働者数で補正する必要があります。問題文の前提「PJに参加しない従業員だけで構成される組織はない」を使って補正する点を忘れないでください。
-
jの扱いでの混同。平均ページ数( ページ/人 → 組織で240ページ)を使うか、問題文の「最大」「高々2ページ/月」という表現を最大化して2,000を得るかで結果が大きく変わります。問題文は「最大(j)ページ」と表現しているため、与えられた「高々2ページ/月」を最悪の形で積み上げて評価するのが設問意図に合致します。
-
稼働年月日の「1,000(50か月分)」の読み替えミス。1,000(日)=50か月(20日/月)という前提があるので、月数は50として計算します。
-
副次索引のキーを間違えるとgとkの解釈が変わります。副次索引1は従業員コードに関する索引である点を確認してください。
FAQ
Q: h = 20の導出が直感に合わないのですが、どの数値を使ったのですか?
A: 「従業員」テーブルの総行数は「8,800行」で組織数は「400」なので平均22人/組織です()。一方「稼働実績」側に登場する従業員コードの列値個数は「8,000」なので、稼働実績に参加する従業員の割合は です。これを掛けると 人になります。前提の「PJに参加しない従業員だけで構成される組織はない」を使ってこの比例配分が妥当であるとしています。
A: 「従業員」テーブルの総行数は「8,800行」で組織数は「400」なので平均22人/組織です()。一方「稼働実績」側に登場する従業員コードの列値個数は「8,000」なので、稼働実績に参加する従業員の割合は です。これを掛けると 人になります。前提の「PJに参加しない従業員だけで構成される組織はない」を使ってこの比例配分が妥当であるとしています。
Q: jを240とする見積りもありますが、なぜ2,000を採るのですか?
A: 240は「従業員1人あたり全期間の平均的なページ数( ページ/人)を使った場合」であり、これは平均値です。しかし設問は「読込みページ数は組織当たり最大(j)ページである」と表現しており、かつ「従業員当たり1か月分の行が高々2ページに格納される」とあるため、最大評価では「各月が別ページに散らばる最悪ケース」を想定します。最悪ケースで従業員1人あたりは ページになり、組織当たり ページとなります。
A: 240は「従業員1人あたり全期間の平均的なページ数( ページ/人)を使った場合」であり、これは平均値です。しかし設問は「読込みページ数は組織当たり最大(j)ページである」と表現しており、かつ「従業員当たり1か月分の行が高々2ページに格納される」とあるため、最大評価では「各月が別ページに散らばる最悪ケース」を想定します。最悪ケースで従業員1人あたりは ページになり、組織当たり ページとなります。
Q: 副次索引3の効果(k=50)はどの記述から直ちに導けますか?
A: 「稼働年月日列の列値個数は1,000(50か月分)」とあり、索引に稼働年月日を含めればインデックスで「1か月分」に絞れるので、全期間読み込みに対して50分の1に削減されます。従ってk = 50です。
A: 「稼働年月日列の列値個数は1,000(50か月分)」とあり、索引に稼働年月日を含めればインデックスで「1か月分」に絞れるので、全期間読み込みに対して50分の1に削減されます。従ってk = 50です。
関連キーワード: クラスタ性、副次索引、入れ子ループ結合、選択率、ページ読み込み

