
基本情報技術者 2009年 春期 午後 問12
次のアセンブラプログラムの説明及びプログラムを読んで、設問1,2に答えよ。
〔プログラムの説明〕
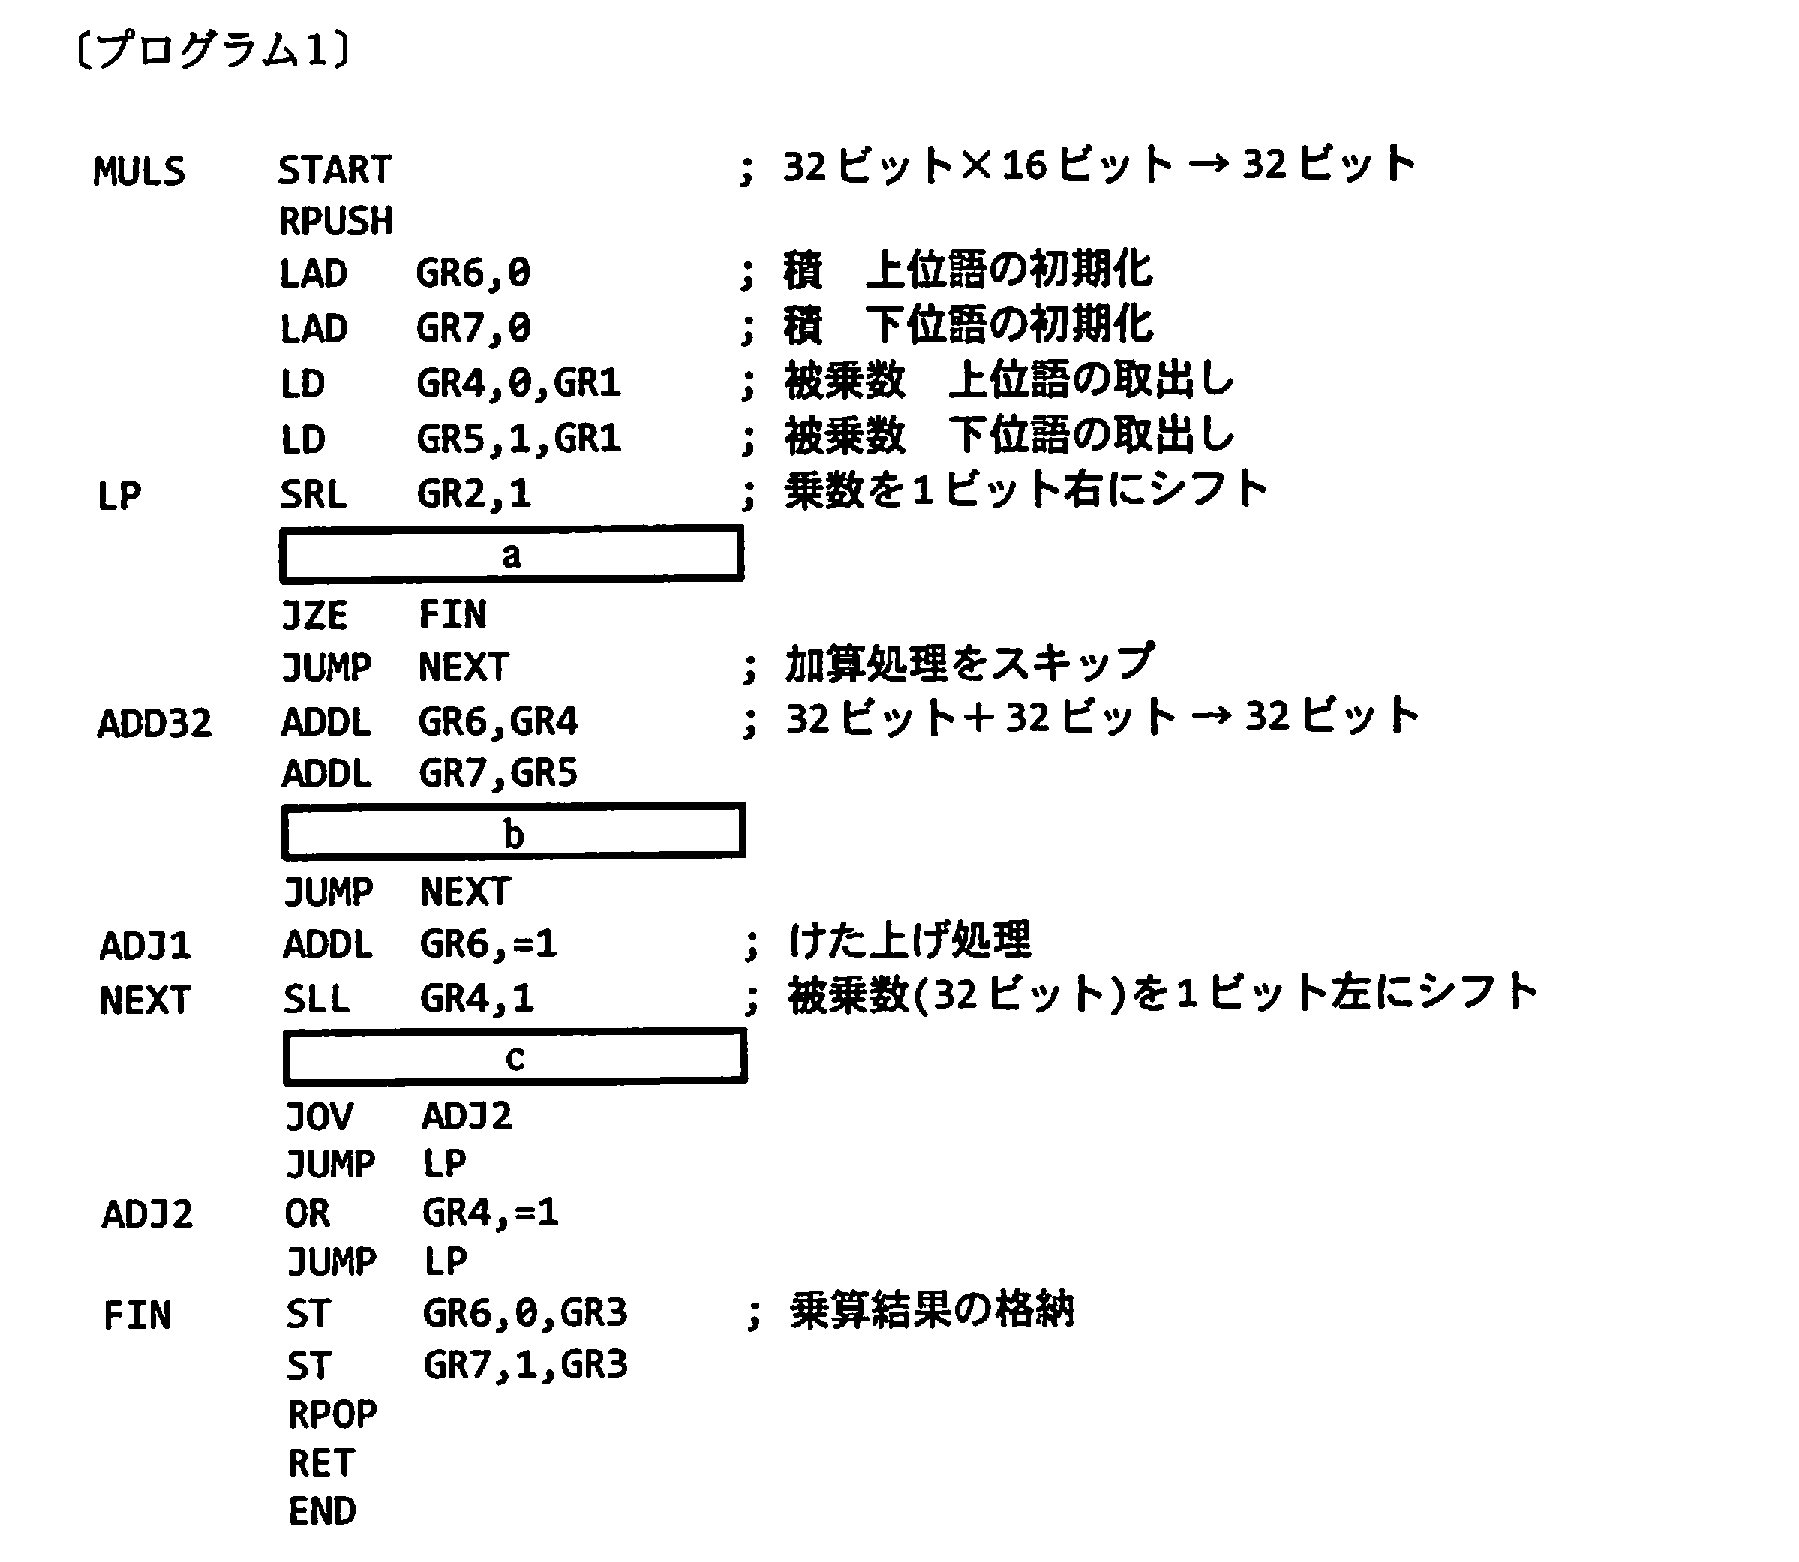
32ビットの乗算を行う副プログラムMULSである。
(1) MULSは、32ビットの被乗数と16ビットの乗数を受け取り、32ビットの積を返す。数値はすべて符号なし整数とし、積のオーバフローは考慮しない。
被乗数と積は、それぞれ連続する2語に上位16ビット、下位16ビットの順に格納される。それぞれの上位語のアドレスは、GR1とGR3に設定して渡される。
乗数はGR2に直接設定して渡される。
(2) 副プログラムMULSから戻るとき、汎用レジスタGR1〜GR7の内容は元に戻す。
設問1:
問題文を見る プログラム1中のに入れる正しい答えを、解答群の中から選べ。
aに関する解答群
ア:JMI ADD32
イ:JMI LP
ウ:JOV ADD32
エ:JOV LP
オ:JPL ADD32
カ:JPL LP
bに関する解答群
ア:JMI ADJ1
イ:JMI ADJ2
ウ:JOV ADJ1
エ:JOV ADJ2
オ:JPL ADJ1
カ:JPL ADJ2
cに関する解答群
ア:JNZ LP
イ:JPL LP
ウ:JZE LP
エ:SLL GR5,1
オ:SRA GR5,1
カ:SRL GR5,1
模範解答
a:ウ、b:ウ、c:エ
解説
解答の導き方
このプログラムは、被乗数を少しずつ左にずらしながら、乗数の各ビットが「1」のときに加算して積を求めます。積の上位16ビットと下位16ビットは、それぞれ別のレジスタで扱います。
GR4とGR5が被乗数の上位語・下位語、GR6とGR7が積の上位語・下位語です。レジスタは、計算中の値を一時的に置いておく場所です。
a:乗数のビットが「1」なら加算する
「SRL GR2,1」は、GR2を1ビット右にずらす命令です。SRL(Shift Right Logical:論理右シフト)では、右端から押し出されたビットがオーバフローフラグに記録されます。オーバフローフラグは、計算やシフトで桁から押し出されたビットなどを記録する印です。
シフト前のGR2の最下位ビットが「1」なら、そのビットはオーバフローフラグに記録されます。JOV(Jump on Overflow:オーバフローフラグが立っているときに分岐する命令)でADD32へ進めば、現在の被乗数を積に加算できます。
したがって、aには「JOV ADD32」が入ります。解答群ではウです。
最下位ビットが「0」の場合は加算せず、残ったGR2がゼロかどうかをJZE FINで調べます。JZE(Jump on Zero:直前の結果がゼロのときに分岐する命令)によって、処理すべき乗数のビットがなくなった時点で終了できます。
b:下位語の加算で生じた桁上げを上位語に加える
ADD32では、まず上位語同士を加え、次に下位語同士を加えています。
下位語の加算で16ビットに収まらない分が出た場合、その分を上位語に足す必要があります。下位語の加算直後にオーバフローフラグを調べ、桁上げがあればADJ1へ進みます。ADJ1では「ADDL GR6,=1」によって、積の上位語GR6を1増やしています。
よって、bには「JOV ADJ1」が入ります。解答群ではウです。ADJ2ではなくADJ1へ分岐するのは、桁上げ分を上位語に加える処理がADJ1だからです。
c:被乗数を32ビットの値として左にずらす
被乗数は、上位語GR4と下位語GR5を合わせた32ビットの値です。左に1ビットずらすときは、GR4だけでなくGR5もずらす必要があります。
GR5を左にずらすと、GR5の最上位ビットが押し出されることがあります。そのビットは、ずらした後のGR4の最下位ビットに入れる必要があります。そこで、GR5を左にずらした結果、オーバフローフラグが立っていればADJ2へ進み、「OR GR4,=1」でGR4の最下位ビットを1にします。
したがって、cには「SLL GR5,1」が入ります。SLL(Shift Left Logical:論理左シフト)は、指定したレジスタを左にずらす命令です。解答群ではエです。
誤りやすいポイント
- aでは、シフト後のGR2の値だけでなく、右端から押し出されたビットも確認します。押し出されたビットが、今回加算するかどうかを決めます。
- bでは、下位語の加算で生じた桁上げを、上位語に加えます。上位語を1増やす処理はADJ1です。
- cでは、GR4とGR5を別々に左シフトするだけでは、32ビットの値としての処理は完成しません。GR5から押し出されたビットをGR4に渡す必要があります。
FAQ
Q: なぜ乗数を右にずらし、被乗数を左にずらすのですか?
A: 乗数のビットを1つずつ確認し、そのビットが「1」のときに対応する大きさの被乗数を加えるためです。確認するビットを右へ進めるのと同時に、被乗数を左へずらして加える値を変えています。
A: 乗数のビットを1つずつ確認し、そのビットが「1」のときに対応する大きさの被乗数を加えるためです。確認するビットを右へ進めるのと同時に、被乗数を左へずらして加える値を変えています。
Q: GR5を左にずらしたときのオーバフローフラグは、何を示しますか?
A: シフト前のGR5の最上位ビットです。そのビットをGR4の最下位ビットに移すことで、GR4とGR5を合わせた値を左にずらした形になります。
A: シフト前のGR5の最上位ビットです。そのビットをGR4の最下位ビットに移すことで、GR4とGR5を合わせた値を左にずらした形になります。
Q: 積の上位語の加算でオーバフローが起きた場合も、別に調整しますか?
A: 問題文では積のオーバフローを考慮しないため、32ビットの範囲を超えた分は扱いません。ここで調整するのは、下位語の加算から上位語へ渡す桁上げです。
A: 問題文では積のオーバフローを考慮しないため、32ビットの範囲を超えた分は扱いません。ここで調整するのは、下位語の加算から上位語へ渡す桁上げです。
関連キーワード: 2進数、論理シフト、オーバフローフラグ、桁上げ、乗算アルゴリズム

設問2:
問題文を見る MULSを利用して、32ビット同士の乗算を行う副プログラムMULを作成した。プログラム2中のに入れる正しい答えを、解答群の中から選べ。
(1) MULは、被乗数と乗数を受け取り、積を返す。数値はすべて32ビットの符号なし整数とし、積のオーバフローは考慮しない。
被乗数、乗数、積は、それぞれ連続する2語に上位16ビット、下位16ビットの順に格納される。それぞれの上位語のアドレスは、GR1、GR2、GR3に設定して渡される。
(2) 副プログラムMULから戻るとき、汎用レジスタGR1〜GR7の内容は元に戻す。
dに関する解答群
ア:LD GR1,0,GR1
イ:LD GR1,0,GR2
ウ:LD GR1,1,GR1
エ:LD GR2,0,GR1
オ:LD GR2,0,GR2
カ:LD GR2,1,GR1
eに関する解答群
ア:LD GR6,0,GR1
イ:LD GR6,0,GR2
ウ:LD GR6,0,GR3
エ:LD GR6,1,GR1
オ:LD GR6,1,GR2
カ:LD GR6,1,GR3
模範解答
d:オ、e:カ
解説
解答の導き方
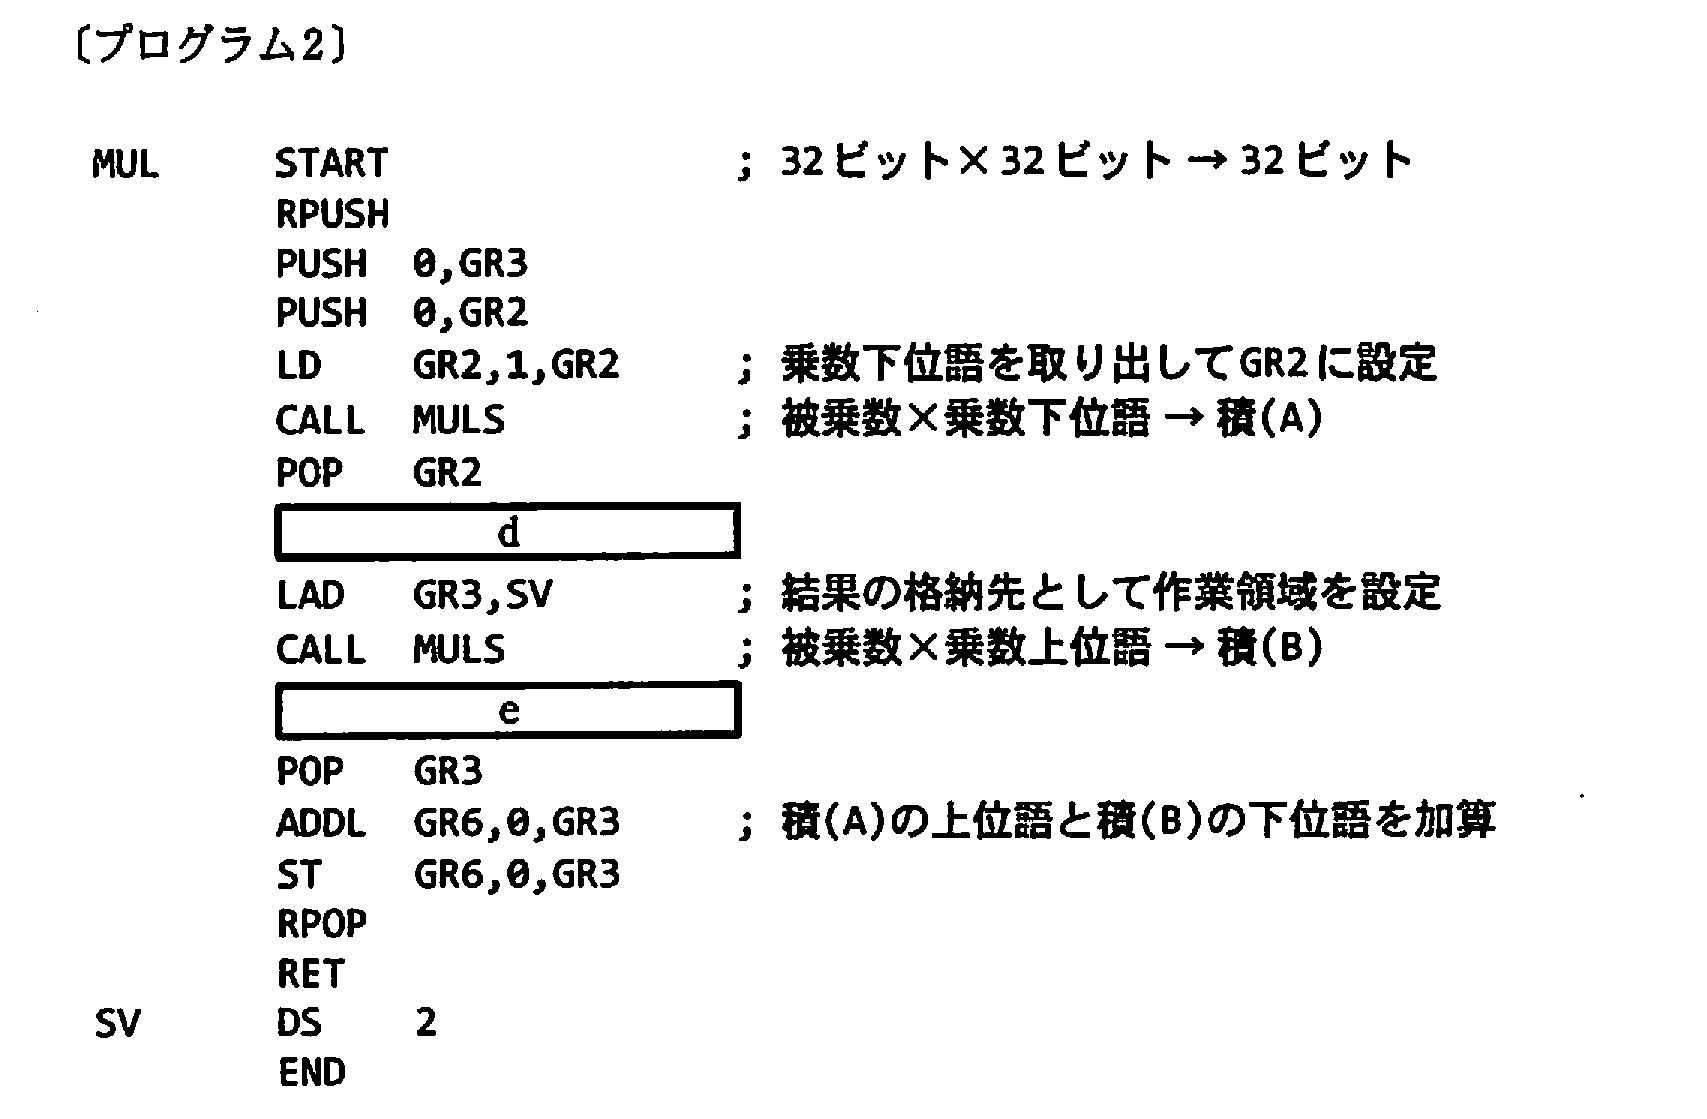
このプログラムでは、32ビットの乗数を上位16ビットと下位16ビットに分け、それぞれを使った乗算を行います。MULSは「32ビット×16ビット」の計算ができるため、2回の計算結果を組み合わせれば「32ビット×32ビット」を求められます。
1. 乗算結果を2つの部分積に分けます
被乗数を 、乗数を とし、それぞれの上位語を 、、下位語を 、 とします。上位語は上位16ビット、下位語は下位16ビットです。
乗数は次のように表せます。
そのため、積は次の2つの部分積に分けられます。
プログラムでは、最初のMULS呼出しで を計算し、次のMULS呼出しで を計算します。部分積とは、このように分けて計算した積のことです。
2. 最初のMULS呼出しでは、乗数の下位語を使います
プログラムには「乗数下位語を取り出してGR2に設定」とあり、その直後にMULSを呼び出しています。この時点では、GR2に乗数の下位語が入っています。また、GR3は積の格納先を指しています。
最初のMULS呼出しによって、部分積 が積の格納先に保存されます。その後、PUSHした値をPOPで取り出し、GR2には乗数のアドレスが戻ります。
3. dでは、乗数の上位語をGR2に設定します
乗数の上位語のアドレスは、乗数のアドレスそのものです。問題文では、上位語を先に、下位語を次に格納すると説明されています。したがって、アドレスのオフセットが0の位置に上位語、オフセットが1の位置に下位語があります。
乗数のアドレスがGR2に戻った後、オフセット0の語を読み込めば、GR2に乗数の上位語が入ります。よって、dに入るのは「LD GR2,0,GR2」です。
4. 2回目のMULS呼出しでは、部分積 を作業領域に保存します
2回目のMULS呼出しの前に、GR3はSVを指すように設定されます。SVは2語分の作業領域なので、部分積 はSVのオフセット0に上位語、オフセット1に下位語の順で保存されます。
MULSは呼出しから戻るときにGR1〜GR7を元に戻します。そのため、2回目の呼出し後もGR3はSVを指しています。
5. eでは、部分積 の下位語を読み込みます
部分積 は、乗数の上位語を使った計算結果です。元の積に加えるときは、 を16ビット左にずらした位置に置きます。
このずらし方では、 の下位語が積の上位語に加わり、 の上位語は32ビットの範囲より上に出るため結果には使いません。そこで、GR3が指すSVのオフセット1、つまり下位語をGR6に読み込みます。eに入るのは「LD GR6,1,GR3」です。
最後にGR3を元の積の格納先に戻し、GR6に読み込んだ部分積 の下位語を、部分積 の上位語に加算します。積の下位語は部分積 の下位語をそのまま使えます。
誤りやすいポイント
- dで下位語を読み込んでしまうことがあります。直前の処理では、GR2に乗数のアドレスが戻っています。2回目のMULSで必要なのは上位語なので、オフセット0を読み込みます。
- eでSVのオフセット0を読み込んでしまうことがあります。部分積 の上位語は、16ビット左にずらすと32ビットの範囲外になります。使うのはオフセット1にある下位語です。
- 2回のMULS呼出しの結果を、同じ場所に保存すると考えてしまうことがあります。最初の部分積 は元の積の格納先に保存され、2回目の部分積 はSVに保存されます。
- と をそのまま足すのではありません。 は16ビット左にずらして加えるため、 の上位語と の下位語を加算します。
FAQ
Q: なぜ部分積 の上位語は使わないのですか?
A: 部分積 は乗数の上位語を使っているため、積に加えるときは16ビット左にずらします。すると、 の上位語は32ビットの結果より上の位置に移るので、結果には含めません。
A: 部分積 は乗数の上位語を使っているため、積に加えるときは16ビット左にずらします。すると、 の上位語は32ビットの結果より上の位置に移るので、結果には含めません。
Q: なぜ積の下位語には部分積 の下位語を使えるのですか?
A: 部分積 は16ビット左にずらして加えるため、積の下位16ビットには影響しません。したがって、積の下位語は部分積 の下位語のままでよいです。
A: 部分積 は16ビット左にずらして加えるため、積の下位16ビットには影響しません。したがって、積の下位語は部分積 の下位語のままでよいです。
Q: PUSHとPOPは何のために使っていますか?
A: PUSHは値を一時的な保存場所であるスタックに置き、POPはそこから値を取り出します。このプログラムでは、あとで使うアドレスを保存し、計算の途中でGR2やGR3を別の用途に使えるようにしています。
A: PUSHは値を一時的な保存場所であるスタックに置き、POPはそこから値を取り出します。このプログラムでは、あとで使うアドレスを保存し、計算の途中でGR2やGR3を別の用途に使えるようにしています。
関連キーワード: 32ビット整数、上位語・下位語、部分積、スタック、桁上げ

