
基本情報技術者 2010年 秋期 午後 問02
コールセンターの対応記録管理に関する次の記述を読んで、設問1~4に答えよ。
F社では、新しいソフトウェア製品の発売と同時に、そのソフトウェア製品に関する質問を受けるコールセンターを開設することにした。コールセンターでの対応内容は、すべてデータベースに記録する。
〔コールセンターの業務〕
(1) 製品を購入した利用者には、一意な利用者IDが発行されている。質問を受ける際は、この利用者IDを通知してもらう。
(2) 対応内容をデータベースに記録する際、その質問の原因を特定する種別を設定する。種別とは、“マニュアル不備”、“使用法誤解”などの情報である。それぞれの種別に対して一意に種別IDを割り当てる。
(3) データベースを検索し、過去に同じ種別IDをもつ類似の質問があった場合は、その受付番号を類似受付番号として記録しておく。
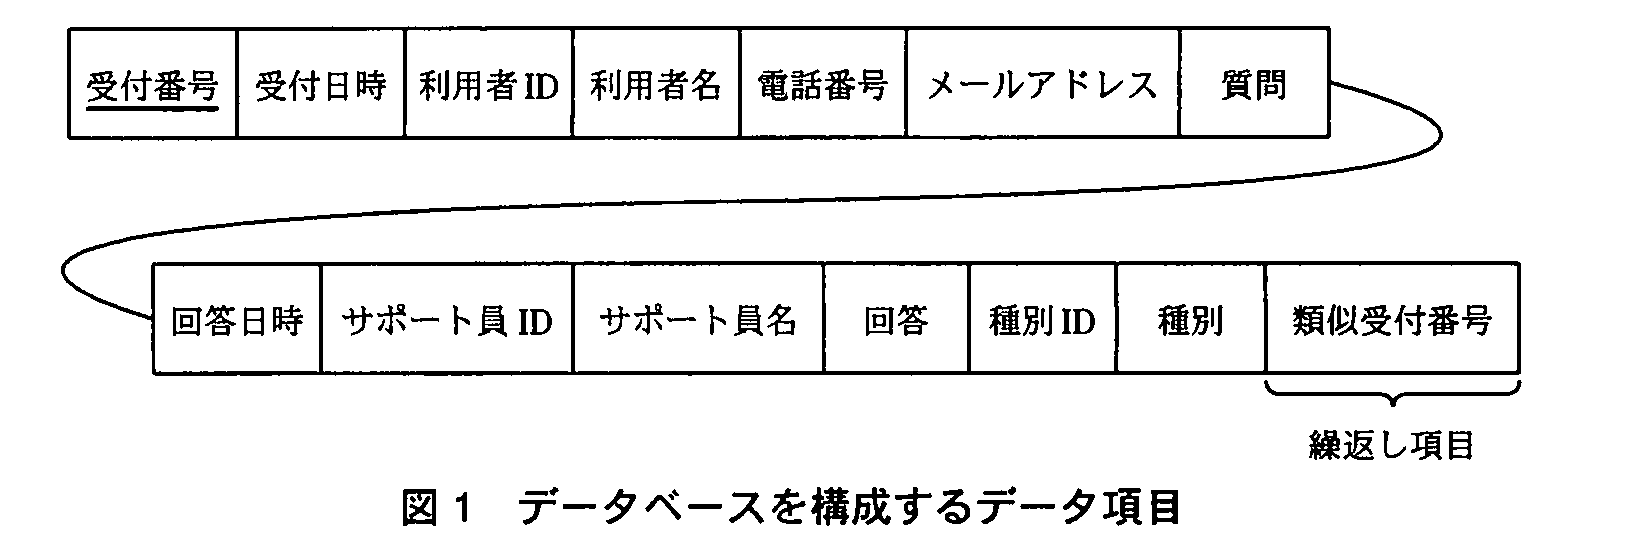
図1は、これらの業務を基に、データベースを構成するデータ項目を抽出したものである。下線付きの項目は主キーを表す。
設問1:
問題文を見る 図1に示したデータ項目を正規化して図2に示す表を設計し、運用を始めた。実施した正規化に関する説明文のに入れる正しい答えを、解答群の中から選べ。
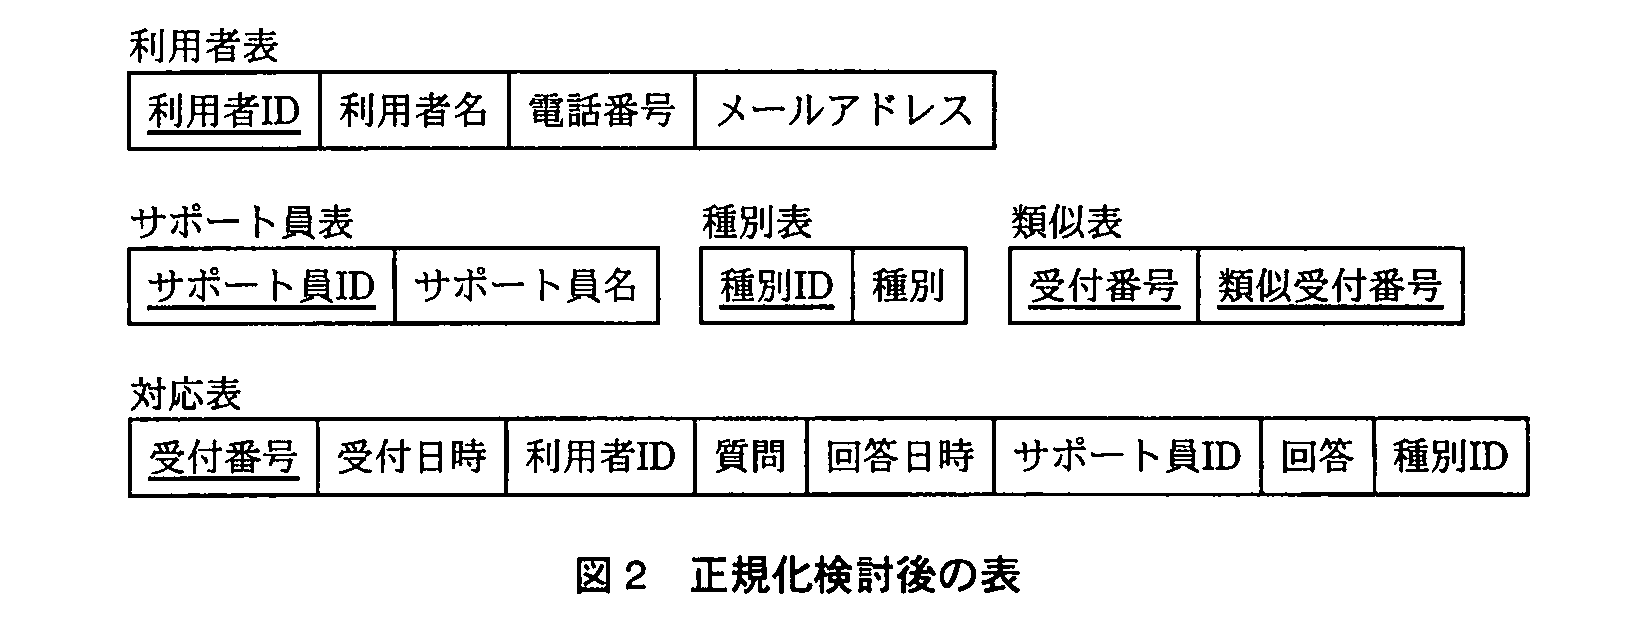
図1に示した状態は非正規形と呼ばれ、1事実1か所の関係が成立していないので、重複更新、事前登録、関係喪失などの問題がある。このため、第1正規化から順に第3正規化までを行うことにした。
まず、第1正規化の作業では、a。次に、第2正規化の作業では、b。そして、第3正規化の作業では、c。
解答群
ア:受付番号と類似受付番号の組合せを主キーとし、繰返し要素を排除した
イ:既に当該正規形に準じていたので、適用は不要だった
ウ:データ参照時の処理性能を考慮し、質問と回答を一つの表で管理するようにした
エ:利用者表、サポート員表及び種別表を作成し、主キー以外の項目における関数従属性を排除した
オ:類似表を作成し、主キーの一部における関数従属性を排除した
模範解答
a:ア、b:オ、c:エ
解説
解答の導き方
正規化とは、データを整理して、同じ情報を何度も登録したり、更新時に不整合が起きたりしにくくすることです。問題では、図1のデータを第1正規化から第3正規化まで順に整理します。
第1正規化:繰返し項目をなくします
図1には「繰返し項目」があります。これは、1件の対応記録の中に、同じ種類の情報を複数個並べて記録する形です。第1正規化では、そうした項目をなくし、繰返しがある情報を1件ずつ分けて記録します。
本文には、過去の類似した質問があれば、その「受付番号を類似受付番号として記録」するとあります。1件の受付に、類似する受付番号が複数ある場合も考えられます。そのため、受付番号だけでは各行を区別できません。
そこで、「受付番号」と「類似受付番号」の組合せを主キー(表の中で行を一つに決める項目)にして、繰返し要素をなくします。この作業に当たるのはアです。
第2正規化:主キーの一部だけで決まる情報を分けます
第1正規化でできた表では、主キーが「受付番号」と「類似受付番号」の組合せです。このように、複数の項目を組み合わせて主キーにすることを、複合主キーといいます。
関数従属性とは、ある項目の値が決まると、別の項目の値も決まる関係です。例えば、対応日時などの対応内容は「受付番号」が決まれば分かります。「類似受付番号」との組合せ全体がなくても決まるため、主キーの一部だけで決まる情報があります。
第2正規化では、このような関係をなくします。「受付番号」と「類似受付番号」の対応だけを類似表に分ける作業に当たるのは、オです。
第3正規化:主キー以外の項目を通じて決まる情報を分けます
第2正規化の後も、対応記録に利用者名やサポート員名、種別の名称を持たせると、IDから名称が決まる関係が残ります。
例えば、利用者IDが決まれば利用者名や電話番号が分かります。つまり、受付番号から利用者IDが分かり、その利用者IDから利用者名などが分かる関係です。主キー以外の項目を通じて、ほかの項目が決まっています。
第3正規化では、この関係を整理するために、利用者表、サポート員表及び種別表を作ります。これに当たるのはエです。
誤りやすいポイント
- 第1正規化を「項目を別の表に分ける作業」とだけ考えると、判断を誤りやすくなります。まず注目するのは、1件の中に繰り返して記録される項目があるかどうかです。
- 第2正規化では、主キーが複数項目から成る点が重要です。主キーの一部だけで決まる情報をなくすため、類似表を作るオが該当します。
- 第3正規化の対象は、主キー以外の項目同士の関係です。利用者IDから利用者名などが決まる関係を整理するため、利用者表などを作るエが該当します。
- イのように「適用は不要」とするのは適切ではありません。図1には繰返し項目があり、IDと名称の関係もあります。
- ウは処理性能を理由に表をまとめる内容です。正規化で重複する情報を整理する作業とは異なります。
FAQ
Q: 受付番号だけを主キーにできないのはなぜですか?
A: 1件の受付に類似する受付番号が複数あると、受付番号だけでは複数の行を区別できないためです。「受付番号」と「類似受付番号」の組合せで行を特定します。
A: 1件の受付に類似する受付番号が複数あると、受付番号だけでは複数の行を区別できないためです。「受付番号」と「類似受付番号」の組合せで行を特定します。
Q: 第2正規化と第3正規化の違いは何ですか?
A: 第2正規化では、複合主キーの一部だけで決まる情報を整理します。第3正規化では、主キー以外の項目を通じて決まる情報を整理します。
A: 第2正規化では、複合主キーの一部だけで決まる情報を整理します。第3正規化では、主キー以外の項目を通じて決まる情報を整理します。
Q: 利用者IDを対応表に残すのは、重複ではありませんか?
A: 対応表に残すのは利用者を示すIDです。利用者名や電話番号などの詳細は利用者表に置くため、詳細情報を対応記録ごとに繰り返し登録せずに済みます。
A: 対応表に残すのは利用者を示すIDです。利用者名や電話番号などの詳細は利用者表に置くため、詳細情報を対応記録ごとに繰り返し登録せずに済みます。
関連キーワード: 非正規形、第1正規形、第2正規形、第3正規形、複合主キー、関数従属性

設問2:
問題文を見る ある利用者から“オプションの指定方法”に関する質問を受けた。過去に類似の質問があったかどうかを確認するため、“オプション”というキーワードを含む質問をすべて抽出する。次のSQL文のに入れる正しい答えを、解答群の中から選べ。
SELECT 対応表.受付番号, 利用者表.利用者名, 対応表.質問
FROM 対応表, 利用者表
WHERE 対応表.利用者ID = 利用者表.利用者ID
AND
解答群
ア:質問 ANY ('%オプション%')
イ:質問 ANY ('_オプション_')
ウ:質問 IN ('%オプション%')
エ:質問 IN ('_オプション_')
オ:質問 LIKE '%オプション%'
カ:質問 LIKE '_オプション_'
模範解答
オ
解説
解答の導き方
この設問では、質問の文章に「オプション」という文字列を含む記録を探します。したがって、空欄には「質問の一部に指定した文字列が含まれるか」を調べる条件が必要です。
まず、WHERE句にはすでに「対応表.利用者ID = 利用者表.利用者ID」という条件があります。これは、対応表と利用者表を利用者IDで結び付ける条件です。空欄には、それとは別に質問の内容を絞り込む条件を加えます。
文字列の一部を探すときに使うのが、LIKEです。LIKEでは、%が「文字が0個以上続く」ことを表します。そのため、「%オプション%」は、「オプション」の前後にどのような文字があってもよい、という指定になります。質問の先頭や末尾に「オプション」がある場合も、質問全体が「オプション」だけの場合も検索できます。
よって、条件は「質問 LIKE '%オプション%'」となり、空欄に入るのはオです。
誤りやすいポイント
- INは、指定した値と完全に一致するかを調べるためのものです。「%オプション%」という文字列そのものと一致する質問を探すことになり、質問の中に「オプション」を含むものを探せません。
- ANYは、複数の値などと比較するために使うもので、文字列の一部を探す指定にはなりません。
- LIKEで使う_は、ワイルドカードとして解釈される場合でも、任意の長さではなく1文字を表します。前後にどれだけ文字があってもよい条件には、%を使います。
- LIKEを選んだだけでは不十分です。パターンが「%オプション%」になっているかも確認します。
FAQ
Q: 「オプション」だけの質問も検索されますか?
A: はい。%は文字が0個でもよいため、「オプション」だけの質問も一致します。
A: はい。%は文字が0個でもよいため、「オプション」だけの質問も一致します。
Q: 質問の前後にある文字数を決めて検索したい場合は、何を使いますか?
A: LIKEのパターンで_を使うと、1文字分を表せます。たとえば、文字数が決まっている場合に使えます。
A: LIKEのパターンで_を使うと、1文字分を表せます。たとえば、文字数が決まっている場合に使えます。
Q: 利用者IDを結び付ける条件は、なぜ必要ですか?
A: 対応表の利用者IDと利用者表の利用者IDを対応させ、質問に対して正しい利用者名を取り出すためです。
A: 対応表の利用者IDと利用者表の利用者IDを対応させ、質問に対して正しい利用者名を取り出すためです。
関連キーワード: SQL、LIKE、ワイルドカード、部分一致、表結合
設問3:
問題文を見る 製品のバージョンアップに当たり、コールセンターの対応記録を参考にして機能改善を検討することにした。種別が“使用法誤解”であった質問を抽出し、類似件数の多い順に表示する。次のSQL文のに入れる正しい答えを、解答群の中から選べ。
SELECT 類似受付番号, COUNT(*) FROM 対応表, 種別表, 類似表
WHERE
ORDER BY COUNT(*) DESC
解答群
ア:対応表.種別ID = (SELECT 種別ID FROM 種別表 WHERE 種別 = '使用法誤解') GROUP BY 類似表.類似受付番号
イ:対応表.種別ID = (SELECT 種別ID FROM 種別表 WHERE 種別 = '使用法誤解') AND 対応表.受付番号 = 類似表.受付番号 GROUP BY 類似表.受付番号
ウ:対応表.種別ID = 種別表.種別ID AND 対応表.受付番号 = 類似表.受付番号 AND 種別表.種別 = '使用法誤解' GROUP BY 類似表.受付番号
エ:対応表.種別ID = 種別表.種別ID AND 対応表.受付番号 = 類似表.受付番号 AND 種別表.種別 = '使用法誤解' GROUP BY 類似表.類似受付番号
模範解答
エ
解説
解答の導き方
SQL(Structured Query Language:データベースに検索や集計を指示する言語)では、必要な表を条件に合わせて結び付け、対象の行を選び、集計します。この問題では、「使用法誤解」に分類された質問について、類似受付番号ごとの件数を数える必要があります。
-
質問の種別を確認します。
図2では、質問の記録を持つ「対応表」に「種別ID」があり、種別の名前は「種別表」にあります。そのため、「対応表.種別ID」と「種別表.種別ID」を一致させて、質問と種別名を結び付けます。さらに、種別名が「使用法誤解」の行だけを対象にします。 -
質問と類似受付番号を結び付けます。
「類似表」には、類似の質問があったときの「受付番号」と「類似受付番号」が記録されています。「対応表」の質問に付けられた種別を調べるには、「対応表.受付番号」と「類似表.受付番号」を一致させる必要があります。ここまでの条件で、「使用法誤解」に分類された質問と、その質問に記録された類似受付番号を対応付けられます。 -
類似受付番号ごとに件数を数えます。
件数を数える対象は、元の質問の受付番号ではなく、過去の類似質問を表す「類似受付番号」です。そのため、類似受付番号ごとにまとめる GROUP BY(同じ値ごとに行をグループ化する句)の対象は「類似表.類似受付番号」です。各グループの行数は COUNT(*) で数えます。 -
件数の多い順に並べます。
ORDER BY COUNT() DESC は、COUNT() の値を降順、つまり大きい順に並べる指定です。以上の条件を満たすのは選択肢エです。WHERE句の中で3表を正しく結び付け、種別名で絞り込み、類似受付番号ごとに集計しています。
誤りやすいポイント
-
必要な表の結合条件を省かないようにします。
選択肢アは、種別の条件は指定していますが、各表を結び付ける条件がありません。複数の表を結び付ける条件がないと、無関係な行まで組み合わされ、正しい件数になりません。 -
選択肢イでは、種別表が結び付いていません。
対応表と類似表は結び付けていますが、FROM句にある種別表との結合条件がありません。そのため、種別表の行が余分に組み合わされ、件数が増えるおそれがあります。 -
グループ化する項目を取り違えないようにします。
選択肢ウは「類似表.受付番号」でグループ化しています。しかし、求めたいのは類似受付番号ごとの件数なので、「類似表.類似受付番号」でグループ化する必要があります。 -
表を結び付ける項目と、集計の単位を区別します。
「対応表.受付番号」と「類似表.受付番号」は、質問の記録と類似表を対応させるために使います。一方、件数をまとめる項目は「類似表.類似受付番号」です。
FAQ
Q: COUNT(*) は何を数えていますか。
A: 表を結び付けて条件に合った後の行数を数えています。この問題では、類似受付番号ごとに、その番号が記録された行数を数えます。
A: 表を結び付けて条件に合った後の行数を数えています。この問題では、類似受付番号ごとに、その番号が記録された行数を数えます。
Q: なぜ「対応表.受付番号」と「類似表.受付番号」を一致させるのですか。
A: 対応表の質問が、類似表のどの記録に対応するのかを特定するためです。この条件がないと、質問と無関係な類似受付番号まで集計される可能性があります。
A: 対応表の質問が、類似表のどの記録に対応するのかを特定するためです。この条件がないと、質問と無関係な類似受付番号まで集計される可能性があります。
Q: ORDER BY COUNT(*) DESC は何をしていますか。
A: 集計した件数を大きい順に並べています。DESC は降順を表します。
A: 集計した件数を大きい順に並べています。DESC は降順を表します。
関連キーワード: SQL、表結合、WHERE句、GROUP BY句、集約関数、ORDER BY句
設問4:
問題文を見る 新たに提供する製品に関する質問を記録するために、現在の表に製品型番の列を追加して製品を識別できるようにする。表の拡張と同時に、これまで蓄積した情報の製品型番の列にはすべて“A001”を設定する。正しいSQL文を、解答群の中から選べ。
解答群
ア:ALTER TABLE 対応表 ADD 製品型番 CHAR(4) DEFAULT 'A001' NOT NULL
イ:ALTER TABLE 対応表 MODIFY 製品型番 CHAR(4) DEFAULT 'A001' NOT NULL
ウ:CREATE TABLE 対応表 (製品型番 CHAR(4) DEFAULT 'A001')
エ:INSERT INTO 対応表 製品型番 VALUES 'A001'
模範解答
ア
解説
解答の導き方
求められているのは、既にある表に「製品型番」の列を追加し、これまでの記録にも「A001」を設定するSQL文です。SQL(Structured Query Language:データベースの表やデータを操作するための言語)の文を、目的に合わせて選びます。
まず、設問には「現在の表に製品型番の列を追加」とあります。既存の表の構造を変更するので、表の変更に使うALTER TABLEと、新しい列を加えるADDを使います。
次に、追加する列を次のように定義します。
製品型番 CHAR(4) DEFAULT 'A001' NOT NULL
CHAR(4)は、文字を4文字分入れる項目です。「A001」は4文字なので、この型に合います。DEFAULT 'A001'は、この列に値を指定しない場合の既定値を「A001」にする指定です。列を追加したときに既存の記録にもこの値が設定されるため、これまでの情報にも「A001」を入れられます。また、NOT NULLは、値が空のままになることを禁止します。
このように、既存の表に列を追加し、既定値も指定しているのはアです。
ほかの選択肢は、操作の目的が異なります。
- イのMODIFYは、既にある列の定義を変更するものです。今回のように新しい列を追加する指定ではありません。
- ウのCREATE TABLEは、新しい表を作るものです。既存の対応表に列を追加する操作ではありません。
- エのINSERT INTOは、表にデータの行を追加する操作です。列を追加する操作ではありません。
誤りやすいポイント
- 「表に列を追加すること」と「表にデータの行を追加すること」を混同しないようにします。列を追加するのはALTER TABLE ADD、行を追加するのはINSERT INTOです。
- DEFAULTは列を追加する命令ではありません。列を追加するADDと組み合わせて、値を指定しなかった場合の値を決めます。
- MODIFYは列の追加ではなく、既存の列の定義変更に使います。問題文に「列を追加」とあれば、ADDに注目します。
FAQ
Q: DEFAULT 'A001'を指定すると、今後の記録には必ず「A001」が入りますか?
A: 値を指定せずに記録した場合に「A001」が使われます。別の値を明示して記録することもできます。
A: 値を指定せずに記録した場合に「A001」が使われます。別の値を明示して記録することもできます。
Q: NOT NULLは、なぜ必要ですか?
A: 製品型番が空の記録を作らないためです。DEFAULTは値を指定しなかった場合の値を決め、NOT NULLは空の値を認めないようにします。
A: 製品型番が空の記録を作らないためです。DEFAULTは値を指定しなかった場合の値を決め、NOT NULLは空の値を認めないようにします。
Q: INSERT INTOで列を追加できないのはなぜですか?
A: INSERT INTOは、表の構造ではなく、表に保存するデータの行を追加する命令だからです。
A: INSERT INTOは、表の構造ではなく、表に保存するデータの行を追加する命令だからです。
関連キーワード: SQL、ALTER TABLE、ADD、DEFAULT、NOT NULL

