
基本情報技術者 2010年 春期 午後 問09
次のCプログラムの説明及びプログラムを読んで、設問1,2に答えよ。
〔プログラムの説明〕
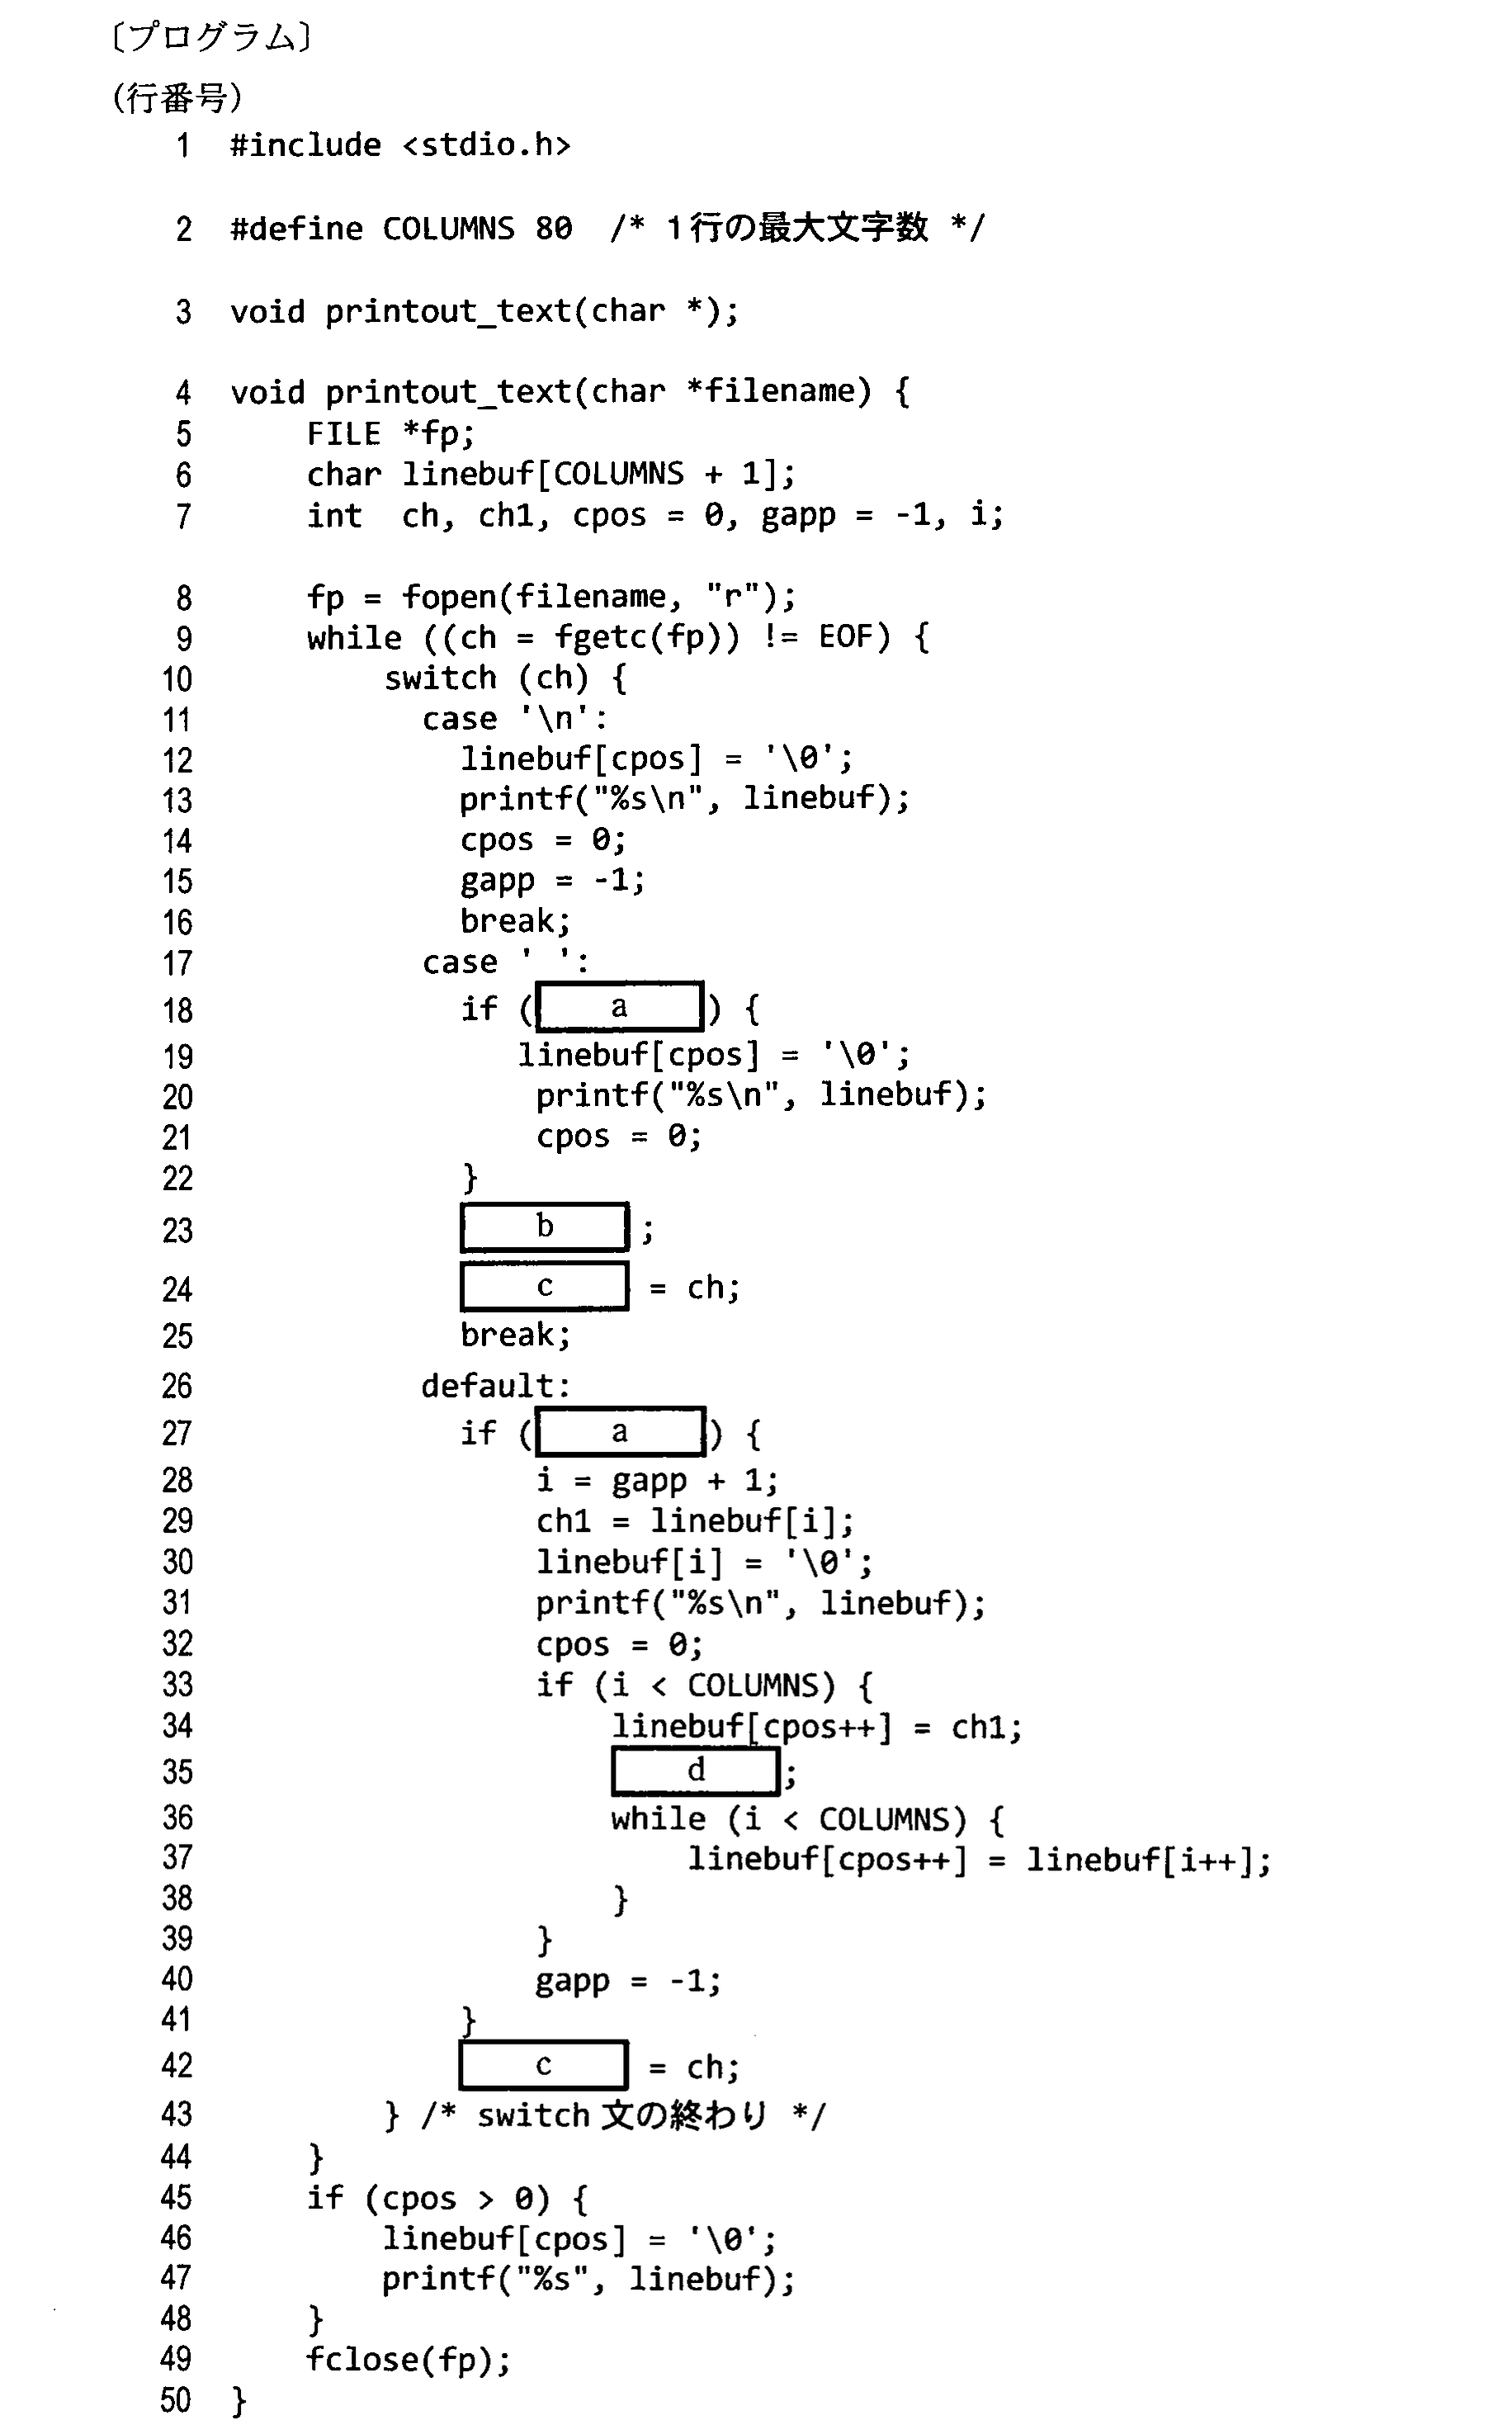
関数printout_textは、ファイルから英文テキストを読み込んで、単語が行末の改行で切れないように整形して出力するプログラムである。
(1) 関数printout_textの引数は、次のとおりである。ここで、ファイル名に誤りはないものとする。
filename 英文テキストが格納されているファイル名
(2) 英文テキストに含まれる文字は、次のものである。
① 英字 A〜Z、a〜z
② 数字 0〜9
③ 記号 ! ” # % & ’ ( ) * + , - . / : ; < = > ? [ ] ^ _ { | } ~
④ 空白文字
⑤ 改行文字
(3) 出力する1行の最大文字数(改行文字を含まない)は80文字である。
(4) 単語は空白文字及び改行文字を含まない文字列であり、1文字以上の連続する空白文字又は改行文字で区切られている。
(5) 空白文字及び改行文字はそのまま出力する。
(6) 単語の途中で1行の最大文字数を超える場合は、その単語が次の行の先頭になるように出力する。
(7) 単語の長さは、1行の最大文字数を超えない。
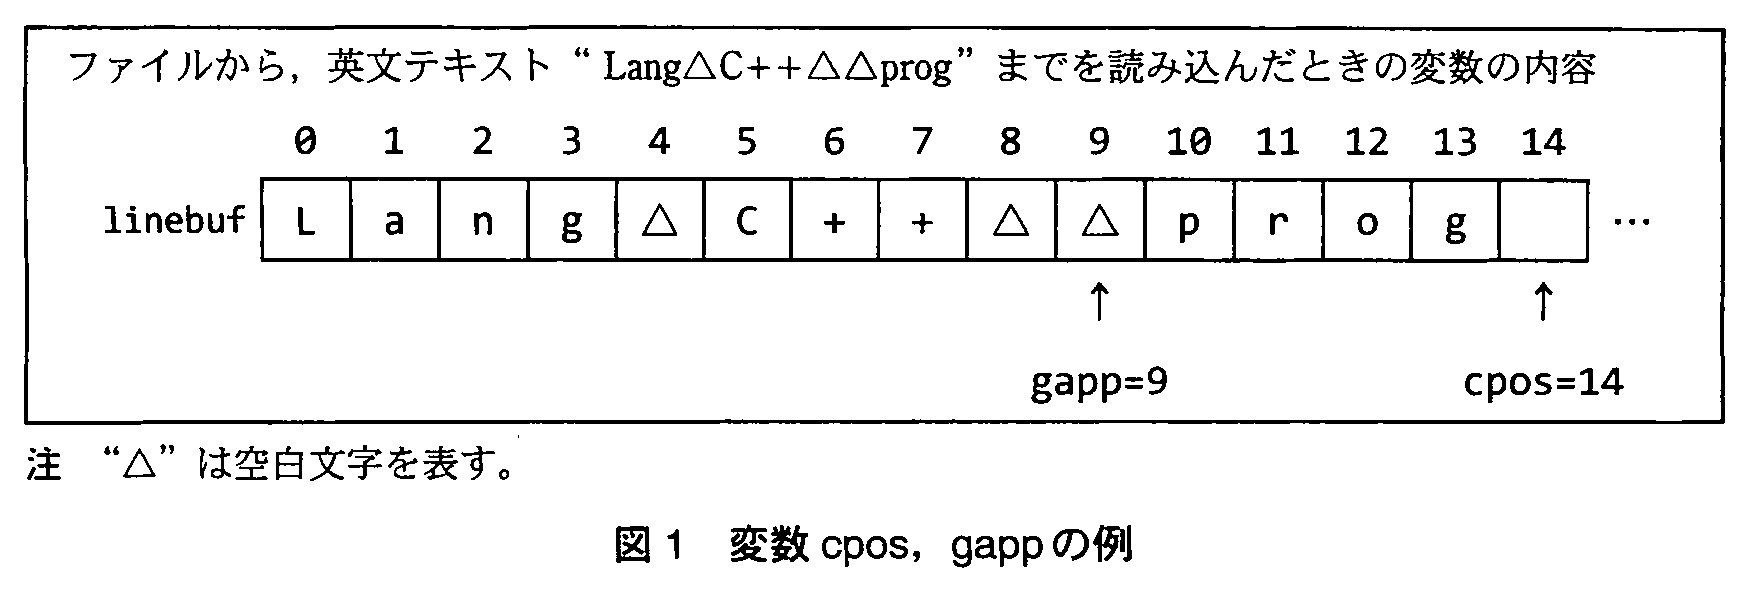
(8) プログラム中で使われる変数cposは出力用行バッファlinebufに次の文字を格納する位置を、変数gappはlinebufに最後に格納した空白文字の位置をもつ。変数cpos、gappの例を、図1に示す。
設問1:
問題文を見る プログラム中のに入れる正しい答えを、解答群の中から選べ。
aに関する解答群
ア:cpos < COLUMNS
イ:cpos <= COLUMNS
ウ:cpos > COLUMNS
エ:cpos >= COLUMNS
オ:gapp < COLUMNS
カ:gapp <= COLUMNS
キ:gapp > COLUMNS
ク:gapp >= COLUMNS
bに関する解答群
ア:gapp = -1
イ:gapp = cpos
ウ:gapp = COLUMNS
エ:gapp++
オ:gapp--
cに関する解答群
ア:linebuf[cpos]
イ:linebuf[cpos++]
ウ:linebuf[gapp]
エ:linebuf[gapp++]
オ:linebuf[++cpos]
カ:linebuf[++gapp]
dに関する解答群
ア:i = -1
イ:i = cpos
ウ:i = COLUMNS
エ:i++
オ:i--
模範解答
a:エ、b:イ、c:イ、d:エ
解説
解答の導き方
このプログラムでは、読み込んだ文字をlinebufというバッファ(一時的に文字を置いておく領域)にためてから出力します。linebufは配列(同じ種類の値を順番に並べて扱う領域)で、各文字の位置を添字(配列の位置番号)で表します。
cposは「次の文字を置く位置」、gappは「最後に置いた空白文字の位置」です。図1では、cpos=14が次の文字を置く位置、gapp=9が最後の空白文字の位置を示しています。
aに入る条件
問題文では「1行の最大文字数(改行文字を含まない)は80文字」とされています。文字を80文字格納した後、cposは80になります。つまり、次に文字を格納しようとする位置が、80文字分の領域の外です。
そのため、空白文字でも通常の文字でも、次の文字を格納する前に、cposがCOLUMNS以上かを調べる必要があります。aには「cpos >= COLUMNS」が入ります。解答群ではエです。
bとcに入る処理
空白文字を格納するときは、まず、その空白文字を格納する位置をgappに記録します。cposが空白文字の格納位置なので、bには「gapp = cpos」が入ります。解答群ではイです。
続いて、空白文字をlinebufに格納し、次の格納位置に進めます。つまり、格納してからcposを1増やします。cには「linebuf[cpos++]」が入るので、解答群ではイです。
ここで、空白文字をlinebufに入れる前にgappを更新するため、gappはその空白文字の位置を正しく示します。空白文字をそのまま格納することで、空白を出力から落とさずに済みます。
dに入る処理
通常の文字を格納しようとしたときにcposがCOLUMNS以上なら、現在の行に文字をそのまま追加できません。そこで、最後に記録した空白文字の後ろで行を分けます。
プログラムは、iをgapp+1にして、最後の空白文字の次の位置を調べます。その位置の文字をch1に退避し、そこに文字列の終わりを表す「'\0'」を置いてから出力します。これにより、最後の空白文字までは現在の行に出力されます。
次に、行をまたいで移す文字があれば、まずch1を新しい行の先頭に置きます。その後、iを次の位置に進めてから、残りの文字を順にコピーします。したがって、dには「i++」が入り、解答群ではエです。iを進めないと、ch1としてすでに移した文字をもう一度コピーしてしまいます。
最後に、cには空白文字の場合と同じ「linebuf[cpos++]」が入ります。行を分けた後の通常の文字も格納し、次の格納位置に進めるためです。
誤りやすいポイント
- 条件は「cposが80より大きい」ではなく、「cposが80以上」です。cposが80の時点で、次の文字を置く場所が1行の範囲を超えています。
- gappは空白文字を格納した後の位置ではなく、空白文字そのものを格納する位置です。そのため、空白文字を格納する前にgappを更新します。
- cpos++は、文字を格納した後にcposを1増やします。文字を格納せずに位置だけを進める処理ではありません。
- dのi++は、先頭に移したch1の次の文字からコピーするために必要です。これを忘れると、先頭の文字を二重にコピーします。
FAQ
Q: なぜ行を分ける位置を、最後の空白文字の後ろにするのですか?
A: 単語の途中で改行しないためです。最後の空白文字までは現在の行に出力し、その後の単語を次の行へ移します。
A: 単語の途中で改行しないためです。最後の空白文字までは現在の行に出力し、その後の単語を次の行へ移します。
Q: 「'\0'」は出力される文字ですか?
A: いいえ。文字列の終わりを示すための文字です。printfの「%s」は、この文字の手前までを文字列として出力します。
A: いいえ。文字列の終わりを示すための文字です。printfの「%s」は、この文字の手前までを文字列として出力します。
Q: gappを-1に戻すのはなぜですか?
A: 行を分けた後に、以前の行の空白位置を誤って使わないようにするためです。新しい行で空白文字を見つけたら、gappはその位置に更新されます。
A: 行を分けた後に、以前の行の空白位置を誤って使わないようにするためです。新しい行で空白文字を見つけたら、gappはその位置に更新されます。
関連キーワード: 配列、バッファ、添字、文字列終端文字、条件分岐、インクリメント

設問2:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
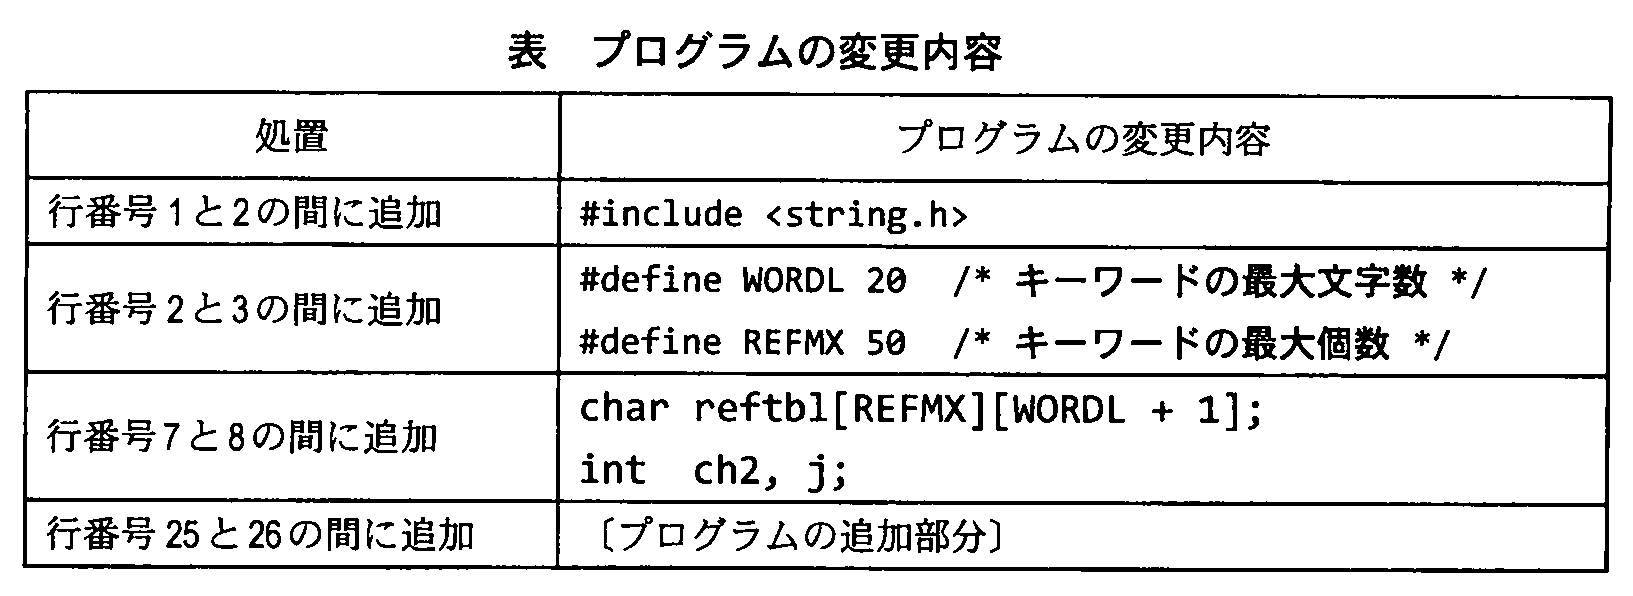
入力した英文テキスト(以下、入力英文テキストという)中に複数回出現する単語をキーワードという。最初の出現場所でキーワードとする単語と参照番号を定義し、それ以降の出現場所では参照番号で参照するように入力英文テキストの様式を変更した。入力英文テキストを整形して出力するときには、参照番号で示されているキーワードは、本来の文字列に戻して出力するようにプログラムを変更する。ここで、プログラム中のa〜dには、正しい答えが入っているものとする。
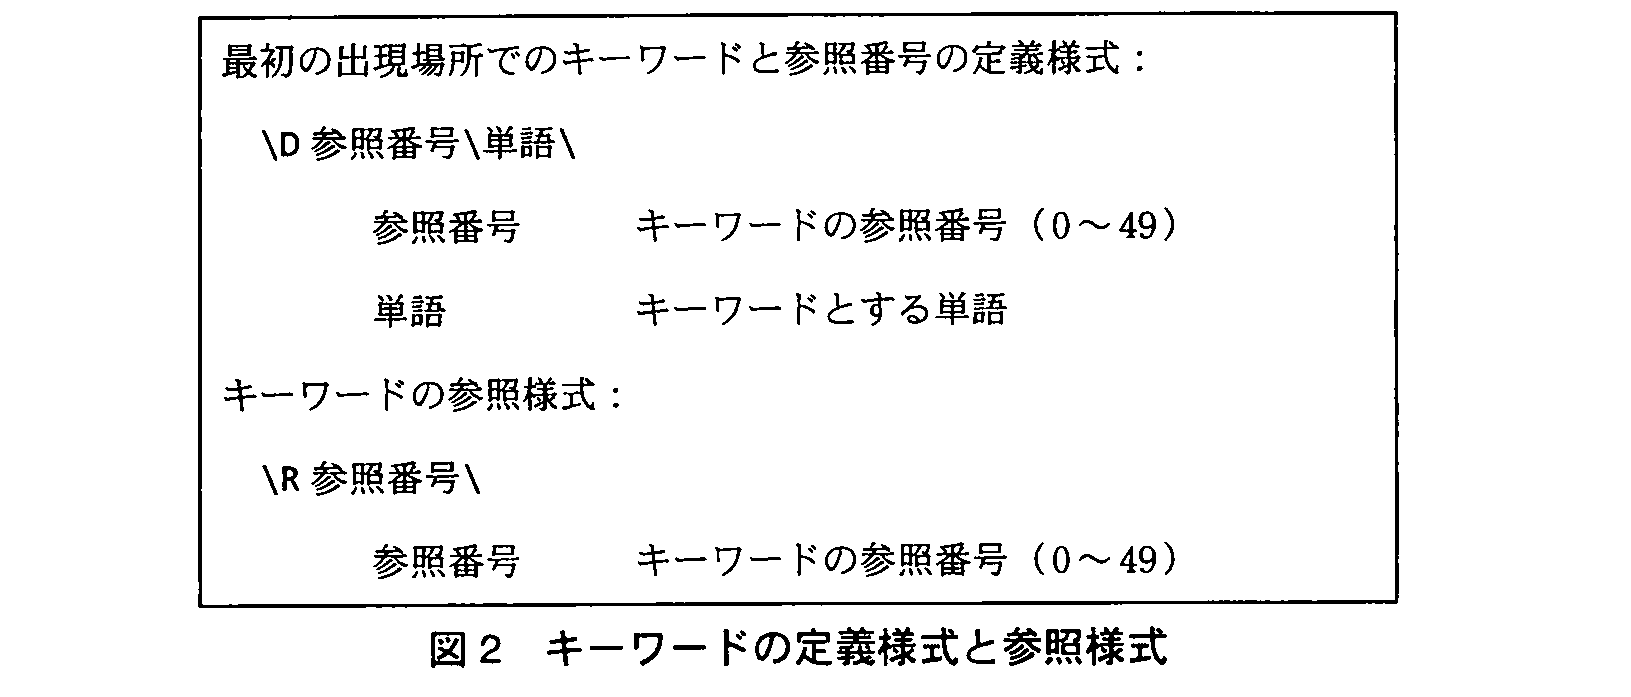
(1) 入力英文テキスト中でのキーワードの表現様式は図2のとおりである。
なお、キーワードの長さは20文字以下であり、キーワードの個数は50以下である。また、入力英文テキストに含まれる文字として文字“\”を追加する。追加された文字“\”は、キーワードの定義及び参照以外に使われることはない。
(2) 入力英文テキストを、次の規則で、出力する英文テキスト(以下、出力英文テキストという)に変換しながら、キーワードを含め単語が行末の改行で切れないように整形して出力する。
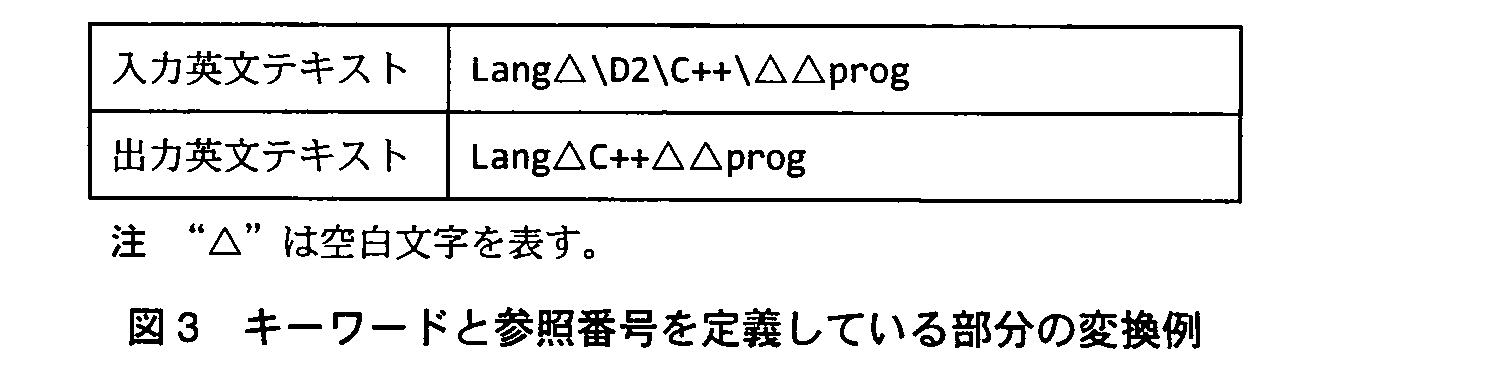
① キーワードと参照番号を定義している部分については、定義しているキーワードだけを出力英文テキストに残す。変換例を図3に示す。
② キーワードを参照している部分については、参照番号に対応するキーワードで置き換える。変換例を図4に示す。
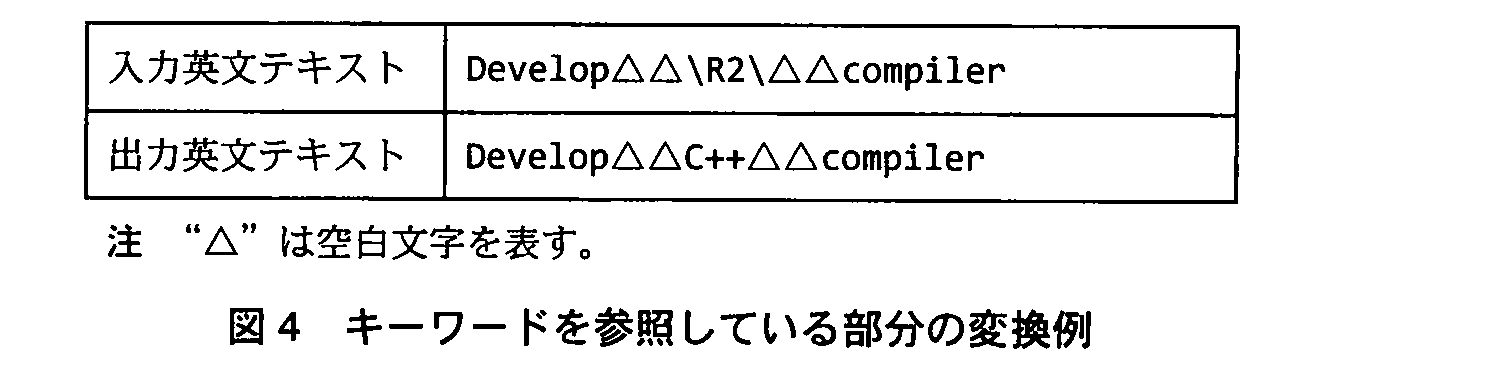
③ その他の部分は、〔プログラムの説明〕の(1)〜(8)に従う。
(3) キーワード処理に対応するために、プログラムを表のとおりに変更する。
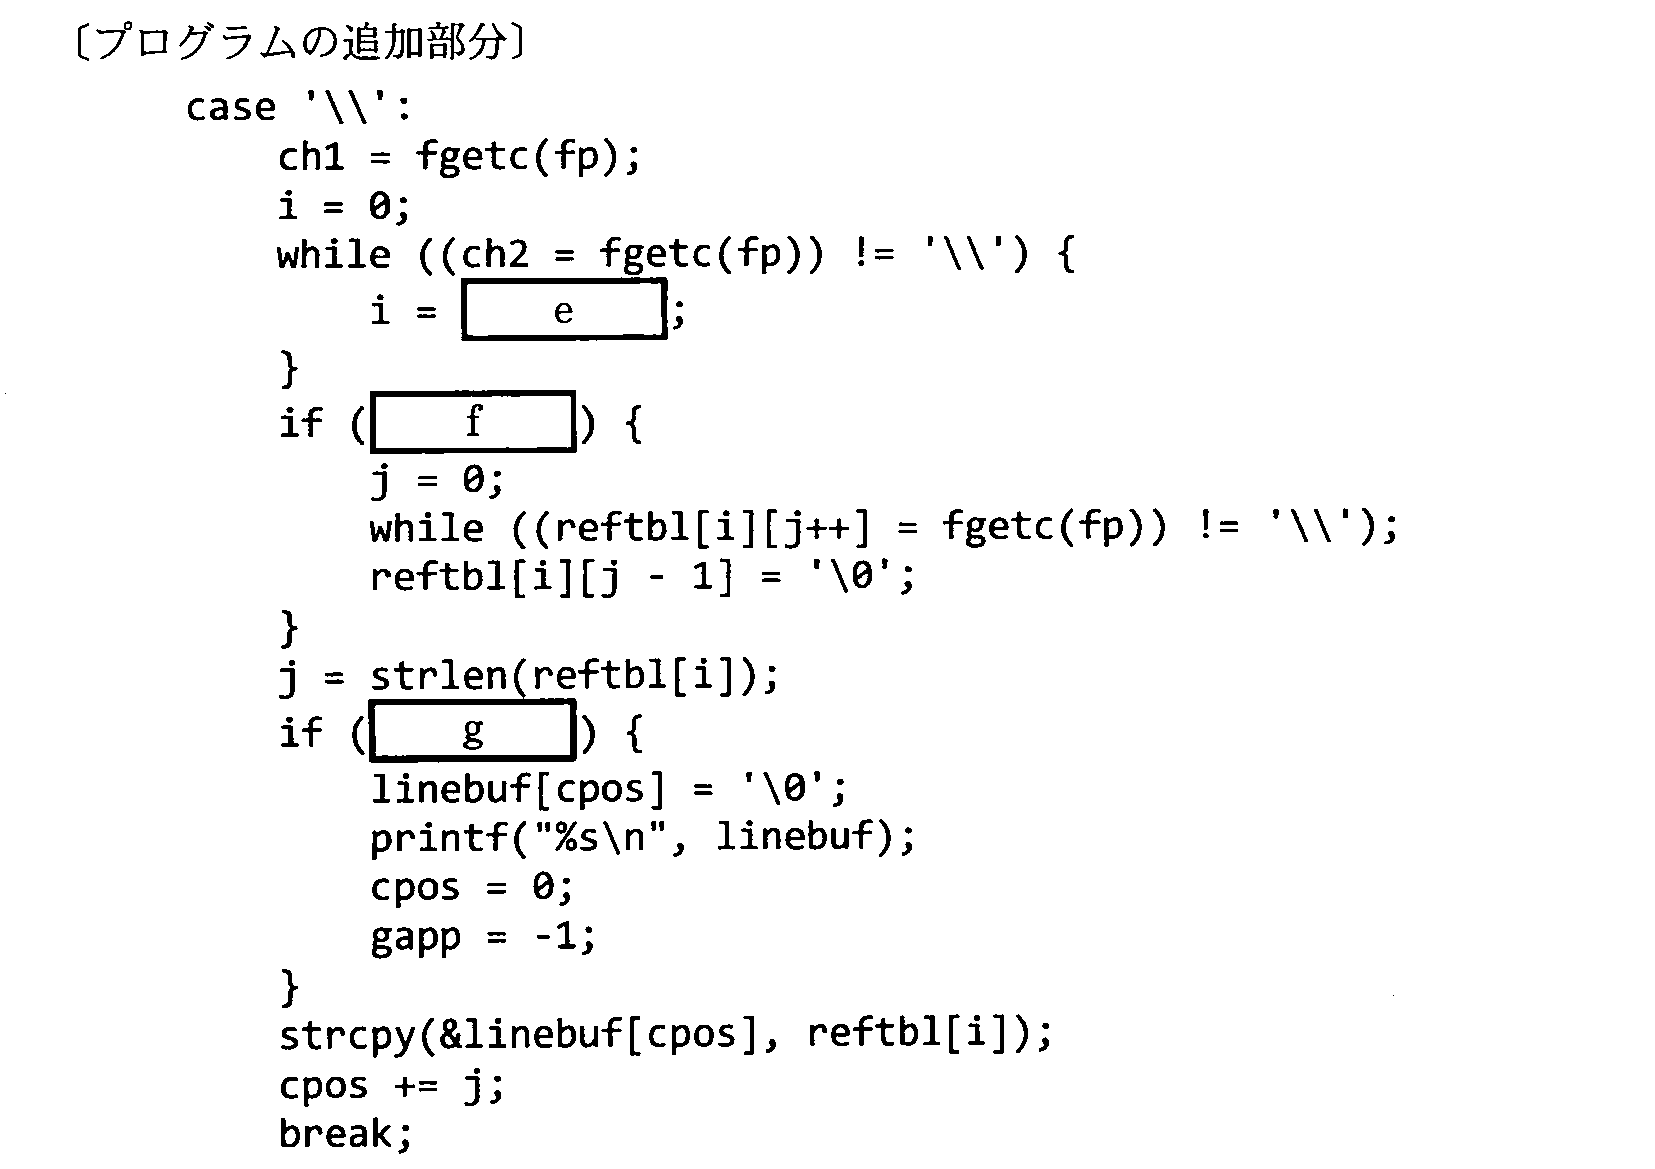
〔プログラムの追加部分〕で使用している関数strlenの仕様は次のとおりである。
unsigned int strlen(const char *s)
機能:文字列sの長さを求める。
返却値:終端を示すナル文字に先行する文字の個数。
eに関する解答群
ア:ch2
イ:ch2 - '0'
ウ:i + ch2
エ:i + ch2 - '0'
オ:i * 10 + ch2
カ:i * 10 + ch2 - '0'
fに関する解答群
ア:ch1 == 'D'
イ:ch1 == 'R'
ウ:ch1 == '\'
エ:i == 0
オ:i != 0
gに関する解答群
ア:cpos >= COLUMNS
イ:cpos + j >= COLUMNS
ウ:cpos + j - 1 >= COLUMNS
エ:gapp >= COLUMNS
オ:gapp + j - 1 >= COLUMNS
模範解答
e:カ、f:ア、g:ウ
解説
解答の導き方
この追加部分では、入力中の「\」を見つけたときに、その後ろに続くキーワードの定義または参照を読み取り、出力する文字列に置き換えます。順に確認しましょう。
-
参照番号を数値にする「\」の次の文字をch1に読み込みます。これは、キーワードを定義する「D」か、キーワードを参照する「R」です。その後、次の「\」までの文字をch2に読み込み、参照番号を変数iに組み立てます。参照番号は0~49なので、複数桁になる場合があります。たとえば「12」なら、最初の「1」でiを1にし、次の「2」でiを12にします。このように、読み取るたびに「これまでの値を10倍して、今回の数字を加える」必要があります。また、ch2に入るのは数字そのものではなく数字の文字なので、「'0'」を引いて数値に直します。したがって、eには「i * 10 + ch2 - '0'」が入ります。これに当たるのは カ です。
-
定義の場合だけ、キーワードを保存する問題文では、最初に現れた場所でキーワードと参照番号を定義し、それ以降は参照番号で参照するとしています。「D」は定義を表します。定義の形式では、参照番号の後ろにキーワードが続くため、その文字を読み取ってreftbl[i]に保存します。reftblは、参照番号を手掛かりにキーワードを取り出せるようにした配列(番号で要素を指定する並び)です。一方、「R」は参照を表します。参照の形式にはキーワード本文が続かないため、保存済みのreftbl[i]をそのまま使います。図3の「\D2\C++\」では参照番号2に「C++」を保存し、図4の「\R2\」ではその「C++」を使います。よって、保存処理を行う条件は「ch1 == 'D'」です。fには ア が入ります。
-
キーワード全体が1行に収まるか調べるstrlenは文字列の長さを調べる関数です。ここでは、reftbl[i]の長さをjに入れています。cposはlinebufに次の文字を格納する位置です。キーワードが長さjで、cposから格納されるなら、使う位置はcposからcpos+j-1までです。1行に出せる文字数は80文字なので、使える位置は0から79までです。最後に使う位置が80以上なら、キーワード全体が行に収まりません。その場合は、現在の行を出力してからキーワードを次の行に置きます。この判定は「cpos + j - 1 >= COLUMNS」です。したがって、gには ウ が入ります。たとえば、cposが70でjが10なら、最後に使う位置は79です。80文字ちょうどなので、その行に収まります。一方、cposが71でjが10なら、最後に使う位置は80です。位置80は1行の範囲外なので、先に改行します。
誤りやすいポイント
- 参照番号を「ch2 - '0'」だけで求めると、1桁の数字しか扱えません。参照番号は複数桁になることがあるため、これまでの値を10倍してから新しい数字を加えます。
- キーワードを保存するかどうかは、参照番号iが0かどうかでは判断しません。0も有効な参照番号です。定義か参照かは、ch1の「D」「R」で判断します。
- 行に収まるか調べるとき、キーワードの先頭位置だけを見てはいけません。キーワードの最後の文字まで含めて判定します。
- 「80文字以内」とは、行の文字位置0から79までを使えるという意味です。最後の位置が79なら収まり、80なら収まりません。
FAQ
Q: なぜ「cpos + j - 1」で最後の位置を求めるのですか?
A: cposが格納開始位置で、j文字を格納するためです。たとえば開始位置が5で長さが3なら、使う位置は5、6、7です。最後の位置は5+3-1になります。
A: cposが格納開始位置で、j文字を格納するためです。たとえば開始位置が5で長さが3なら、使う位置は5、6、7です。最後の位置は5+3-1になります。
Q: 参照の場合、キーワードはどこから取り出しますか?
A: 先に定義されたキーワードをreftblに保存しておき、参照番号iを使ってreftbl[i]から取り出します。
A: 先に定義されたキーワードをreftblに保存しておき、参照番号iを使ってreftbl[i]から取り出します。
Q: cposにはなぜjを加えるのですか?
A: cposは次に文字を格納する位置だからです。j文字を格納した後の次の位置は、格納前の位置にjを加えた位置になります。
A: cposは次に文字を格納する位置だからです。j文字を格納した後の次の位置は、格納前の位置にjを加えた位置になります。
関連キーワード: 文字列処理、配列、文字コード、終端文字、境界値判定、バッファ

