
基本情報技術者 2011年 春期 午後 問11
次のJavaプログラムの説明及びプログラムを読んで、設問1,2に答えよ。
〔プログラムの説明〕
クラスArrayAppendableCharSequence及びListAppendableCharSequenceは、追加可能な0個以上の文字からなる文字列(文字の並び)を表現するインタフェースAppendableCharSequenceを異なるデータ構造で実装したプログラムである。
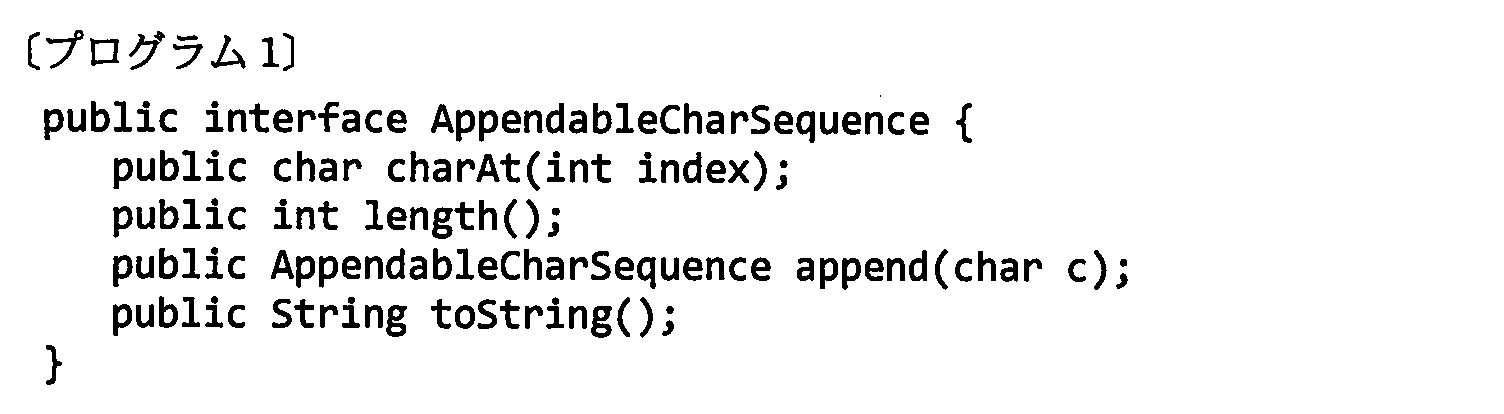
インタフェースAppendableCharSequenceは、パッケージjava.langのインタフェースCharSequence及びAppendableで定義されている次のメソッドからなる。
(1) メソッドcharAtは、引数indexで指定された位置の文字を返す。文字の位置はインデックス値で表され、文字列の長さが1以上のとき、最初の文字の位置は0、最後の文字の位置は文字列の長さ−1で表される。引数で指定されたインデックス値が負又は文字列の長さ以上の場合は、IndexOutOfBoundsExceptionを投げる。
(2) メソッドlengthは、文字列の長さを返す。
(3) メソッドappendは、引数で指定された文字を文字列の末尾に追加する。戻り値として、このAppendableCharSequenceのインスタンス自身を返す。
(4) メソッドtoStringは、このインスタンスの文字列をStringオブジェクトで返す。
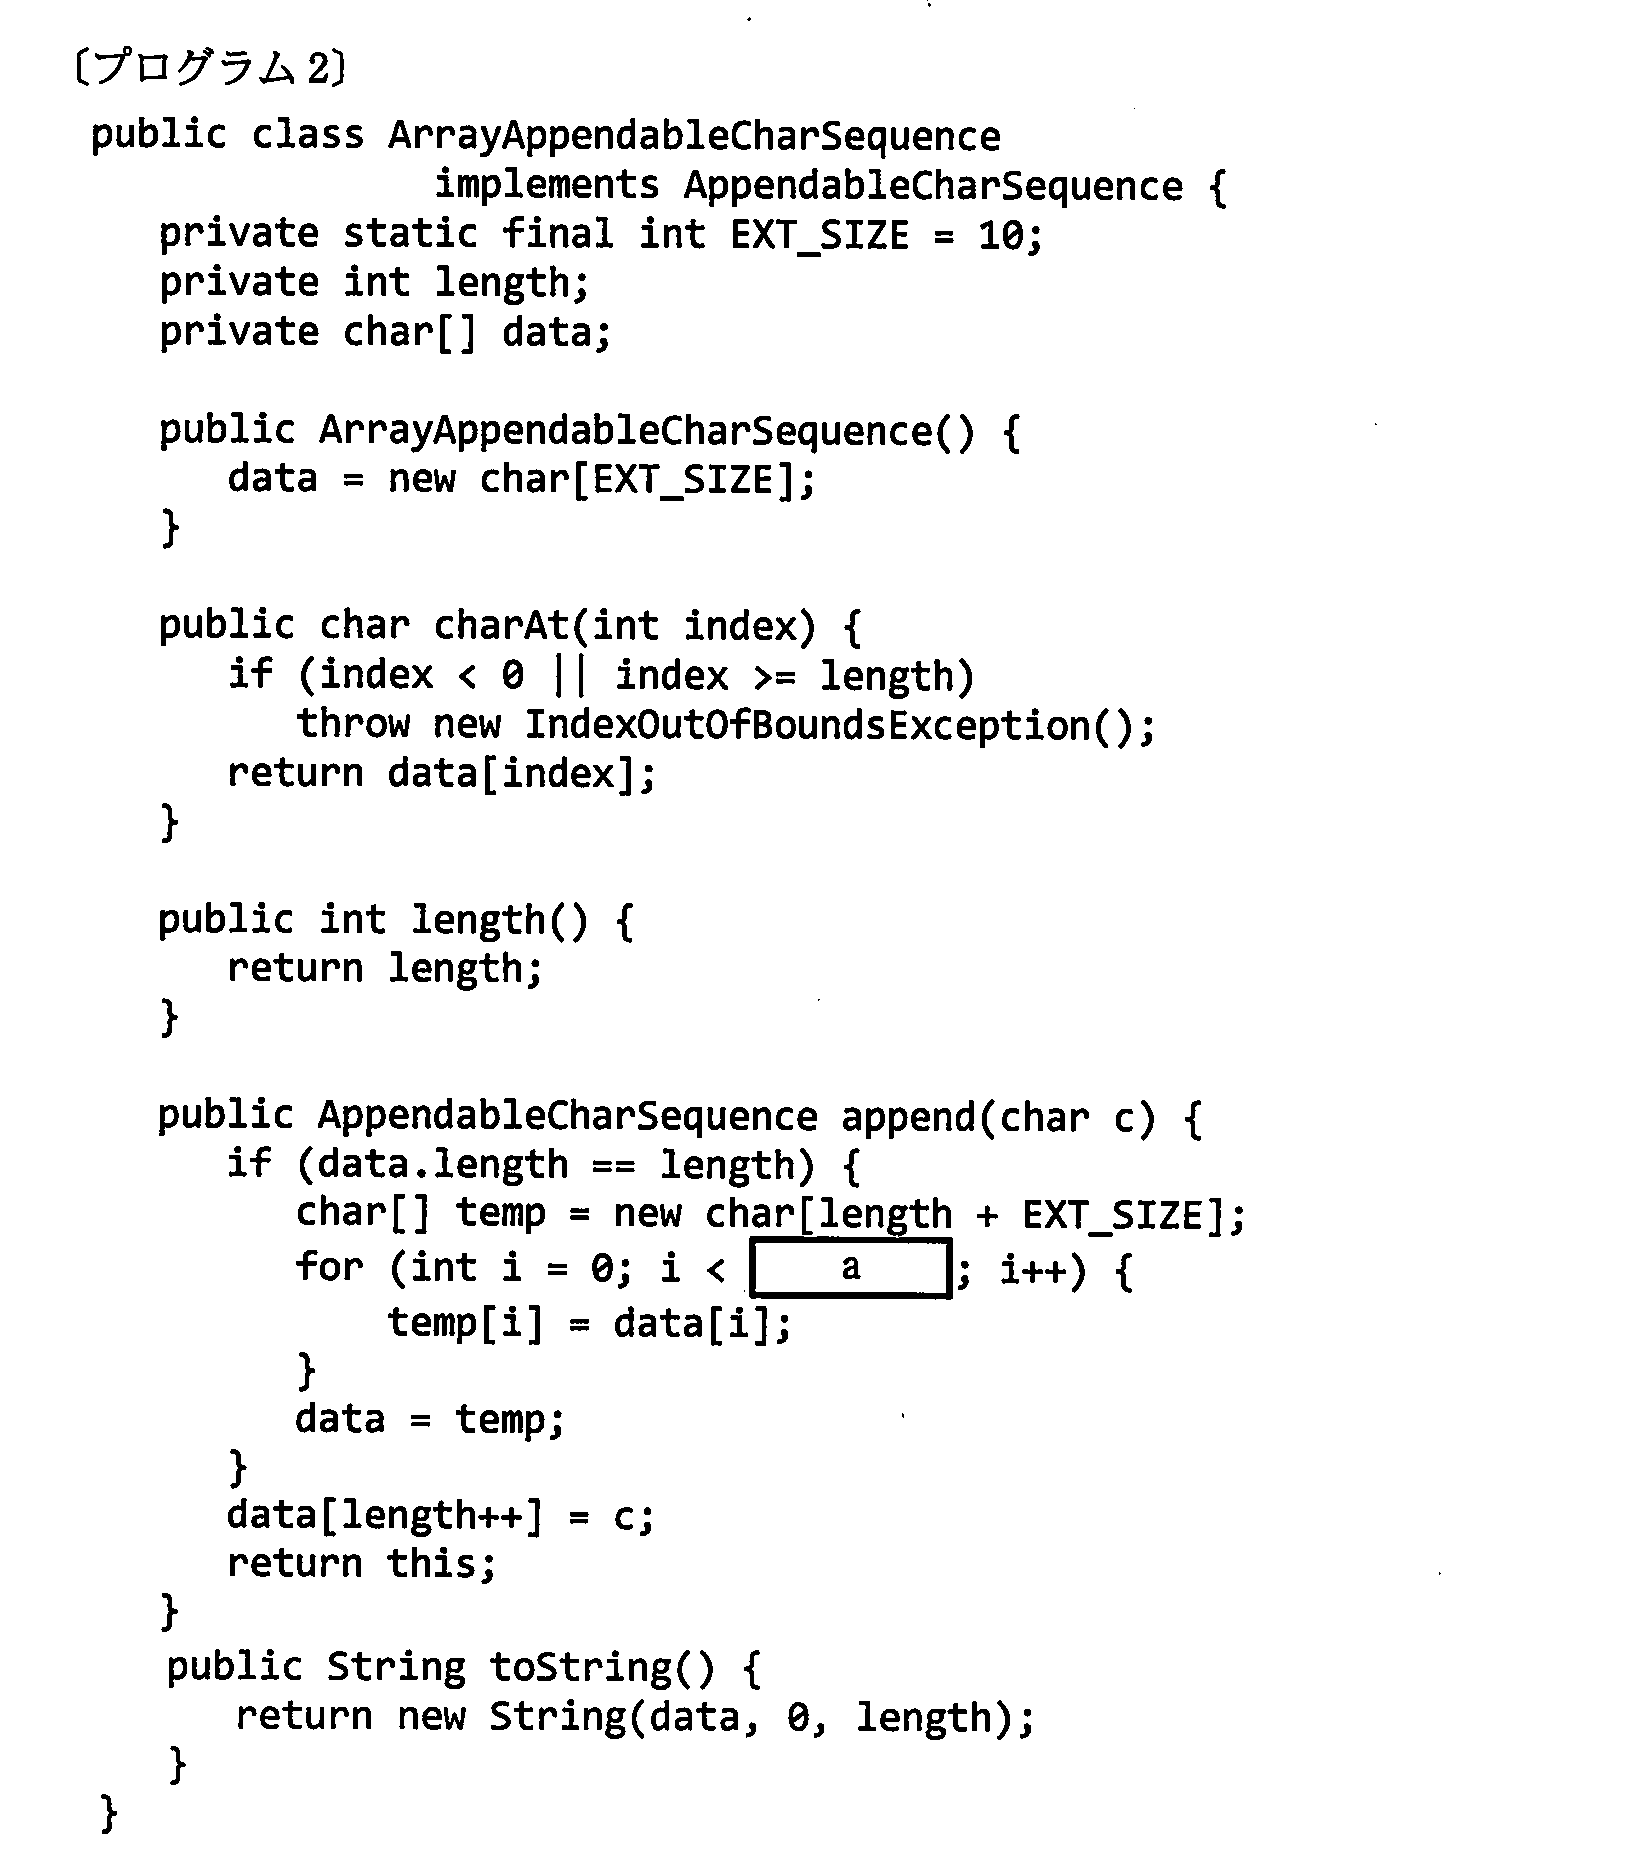
クラスArrayAppendableCharSequenceは、char型の配列を用いてインタフェースAppendableCharSequenceを実装したものである。メソッドappendは、配列の空いている最初の要素に文字を格納する。配列に空き要素がないときは、要素の個数が現在の配列よりもEXT_SIZEの値だけ大きな配列を生成し、既存の文字データを移し、空いている最初の要素に文字を格納する。
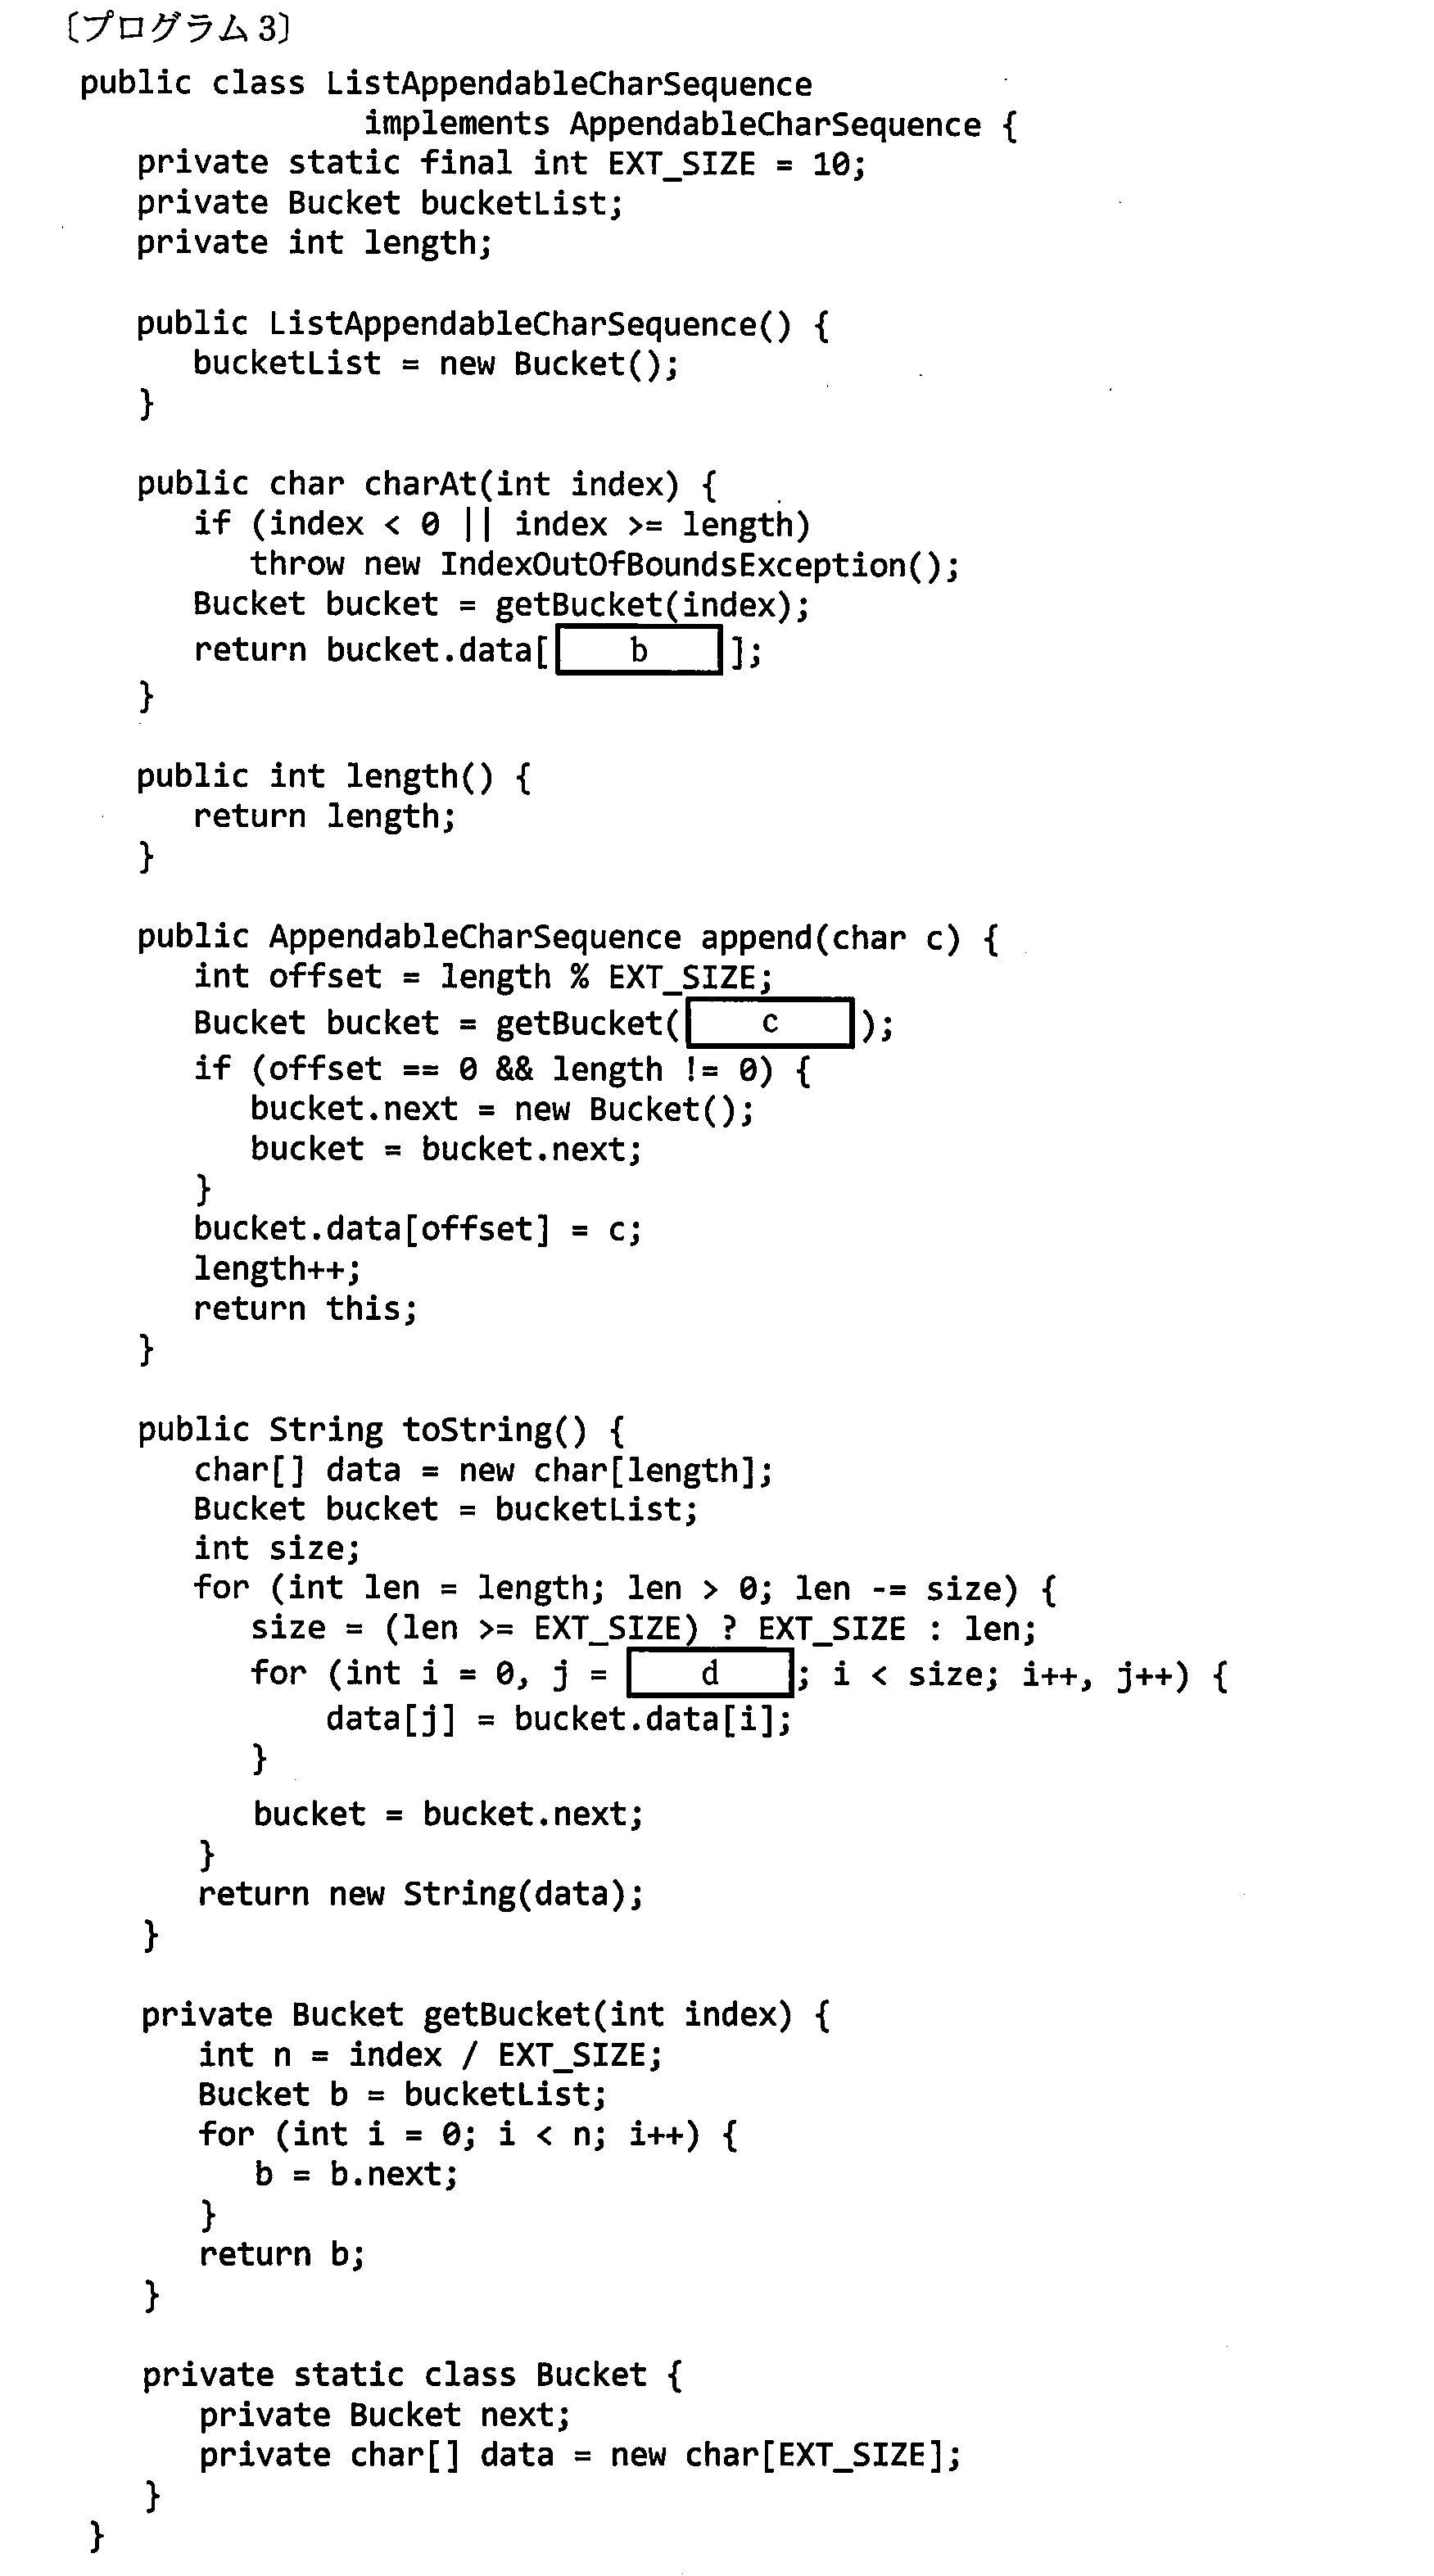
クラスListAppendableCharSequenceは、連結リスト構造を用いてインタフェースAppendableCharSequenceを実装したものである。入れ子クラスListAppendableCharSequence.Bucket(以下、Bucketという)は、連結リストの要素である。Bucketのインスタンス1個につき、要素の個数がEXT_SIZEであるchar型の配列を用意し、そこに文字データを保持する。Bucketの配列に空き要素がなくなり、次の文字を追加できないときは、新規にBucketのインスタンスを生成し、連結リストに追加する。
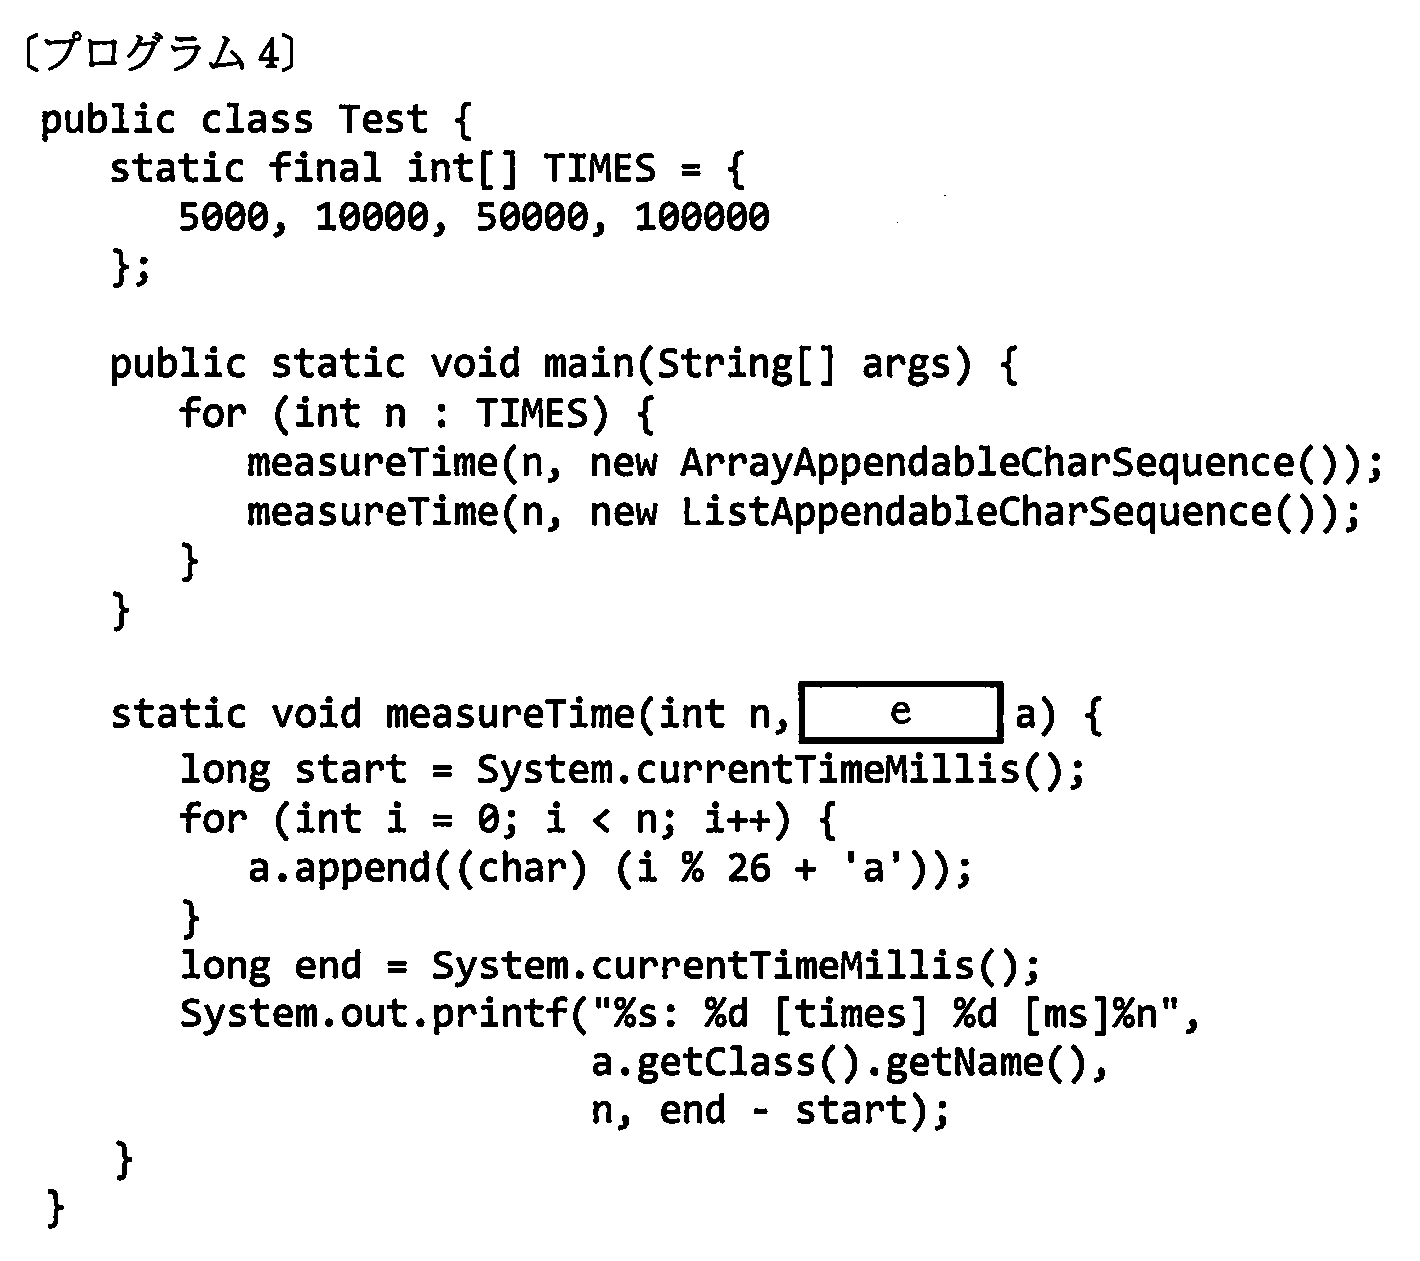
クラスTestは、上記二つのクラスそれぞれの実装が異なるメソッドappendの実行時間を測定するプログラムである。メソッドmeasureTimeは、引数nで指定された回数だけ、引数aで指定されたインスタンスのメソッドappendを呼び出し、実行時間をミリ秒単位で測定する。
設問1:
問題文を見る プログラム中のに入れる正しい答えを、解答群の中から選べ。
aに関する解答群
ア:data.length + length
イ:data.length + temp.length
ウ:length
エ:length + EXT_SIZE
オ:temp.length
bに関する解答群
ア:index
イ:index % EXT_SIZE
ウ:index / EXT_SIZE
エ:length
オ:length % EXT_SIZE
カ:length / EXT_SIZE
cに関する解答群
ア:length
イ:length + 1
ウ:length - 1
エ:offset
オ:offset + 1
カ:offset - 1
dに関する解答群
ア:len
イ:len % EXT_SIZE
ウ:len - length
エ:length
オ:length % EXT_SIZE
カ:length - len
eに関する解答群
ア:AppendableCharSequence
イ:ArrayAppendableCharSequence
ウ:ListAppendableCharSequence
エ:ListAppendableCharSequence.Bucket
オ:Object
カ:String
模範解答
a:ウ、b:イ、c:ウ、d:カ、e:ア
解説
解答の導き方
この問題では、配列を使う実装、連結リストを使う実装、両方に共通するインタフェースについて、それぞれ空欄に入る内容を考えます。インタフェースとは、クラスが備えるメソッドを定めた約束です。
a:配列にコピーする文字の範囲
ArrayAppendableCharSequenceでは、配列に空きがなくなると、新しい配列を作り、文字を移します。配列の大きさは「要素の個数が現在の配列よりもEXT_SIZEの値だけ大きな配列」とあります。
ここで、lengthは、文字列に実際に入っている文字数です。一方、data.lengthは、配列に入れられる文字数、つまり配列の大きさです。新しい配列に移すのは、すでに使っている文字だけなので、コピーの繰返し条件は「iがlengthより小さい間」です。したがって、aにはlengthが入ります。
b:文字列全体の位置から、Bucket内の位置を求める
ListAppendableCharSequenceでは、Bucket(文字を入れる配列を持つ連結リストの要素)ごとに、EXT_SIZE個の文字を保持します。連結リストは、要素同士を次の要素への参照でつないだ構造です。
charAtでは、まずgetBucket(index)で、indexの文字が入っているBucketを選びます。その後、そのBucketの配列の何番目に文字があるかを指定します。
indexをEXT_SIZEで割った余りが、Bucket内での位置です。例えば、indexが12なら、12を10で割った余りは2なので、Bucket内の位置は2です。よって、bにはindex % EXT_SIZEが入ります。
c:追加先のBucketを決める
appendでは、まずoffsetに「現在の文字数をEXT_SIZEで割った余り」を入れています。この値が、追加する文字のBucket内での位置になります。
getBucketには、現在の文字数そのものではなく、length - 1を渡します。これは、追加する前に最後に入っていた文字の位置です。現在の文字数が10なら、最後の文字の位置は9です。getBucket(9)で現在の最後のBucketを選び、offsetが0で、かつlengthが0でなければ、新しいBucketをその次につなぎます。
例えば、lengthが10のときは、最初のBucketがすでにいっぱいです。length - 1は9なので、getBucket(9)で最初のBucketを選び、その後、新しいBucketを作ってそこへ追加します。
文字数が0のときはlength - 1が-1になりますが、Javaの整数の割り算では-1 / 10の結果は0です。そのため、getBucket(-1)は最初のBucketを返します。lengthが0なので新しいBucketは作らず、最初のBucketに文字を入れます。したがって、cにはlength - 1が入ります。
d:Bucketの文字を、結果の配列のどこにコピーするか
toStringでは、全体の文字数分の配列を用意し、Bucketを先頭から順にたどって文字をコピーします。lenは、まだコピーしていない文字数です。jは、結果の配列におけるコピー先の開始位置です。
例えば、lengthが12の場合は次のようになります。
1回目は結果の配列の0番目から10文字をコピーします。コピー後はlenが2になり、2回目は結果の配列の10番目から残りの2文字をコピーします。したがって、dにはlength - lenが入ります。
e:二つのクラスに共通する引数の型
measureTimeは、ArrayAppendableCharSequenceとListAppendableCharSequenceの両方を受け取ります。この二つのクラスは、どちらもAppendableCharSequenceを実装しています。
measureTimeの中で呼び出しているのはappendです。両方のクラスに共通するappendを使える型として、eにはインタフェースのAppendableCharSequenceが入ります。これなら、配列を使う実装と連結リストを使う実装のどちらも、同じmeasureTimeに渡せます。
誤りやすいポイント
- aでは、配列の大きさを表すdata.lengthと、実際に使っている文字数を表すlengthを混同しないようにします。コピーする対象は、すでに入っている文字です。
- bでは、文字列全体での位置と、Bucket内での位置を区別します。Bucket内の位置は、indexをEXT_SIZEで割った余りです。
- cでは、追加する文字の位置ではなく、追加前の最後の文字の位置を使います。Bucketがいっぱいなら、その位置から現在の最後のBucketを選び、新しいBucketをつなぎます。
- dのlenは、繰返しのたびに減っていく残りの文字数です。結果の配列のコピー先は、length - lenで求めます。
- eには具体的なクラス名ではなく、二つのクラスに共通するインタフェースを選びます。
FAQ
Q: lengthとdata.lengthは、どちらも文字数を表すのですか?
A: lengthは、実際に文字列に入っている文字数です。data.lengthは、配列が保持できる最大の文字数です。配列に空きがある間は、data.lengthの方がlengthより大きくなります。
Q: cでlength - 1を使うのはなぜですか?
A: 追加前の最後の文字の位置を調べるためです。文字数が10なら最後の文字の位置は9です。そのBucketがいっぱいなら、新しいBucketをつないで、追加先を切り替えます。
Q: eに具体的なクラス名を指定してはいけないのですか?
A: どちらか一方のクラス名を指定すると、そのクラスのインスタンスしか受け取れません。共通するAppendableCharSequenceを指定すれば、どちらの実装も受け取れます。
関連キーワード: インタフェース、配列、連結リスト、剰余算արման

設問2:
問題文を見る クラスTestを用いて各クラスのメソッドappendの実行時間(ミリ秒)を測定したところ、表1の結果になった。
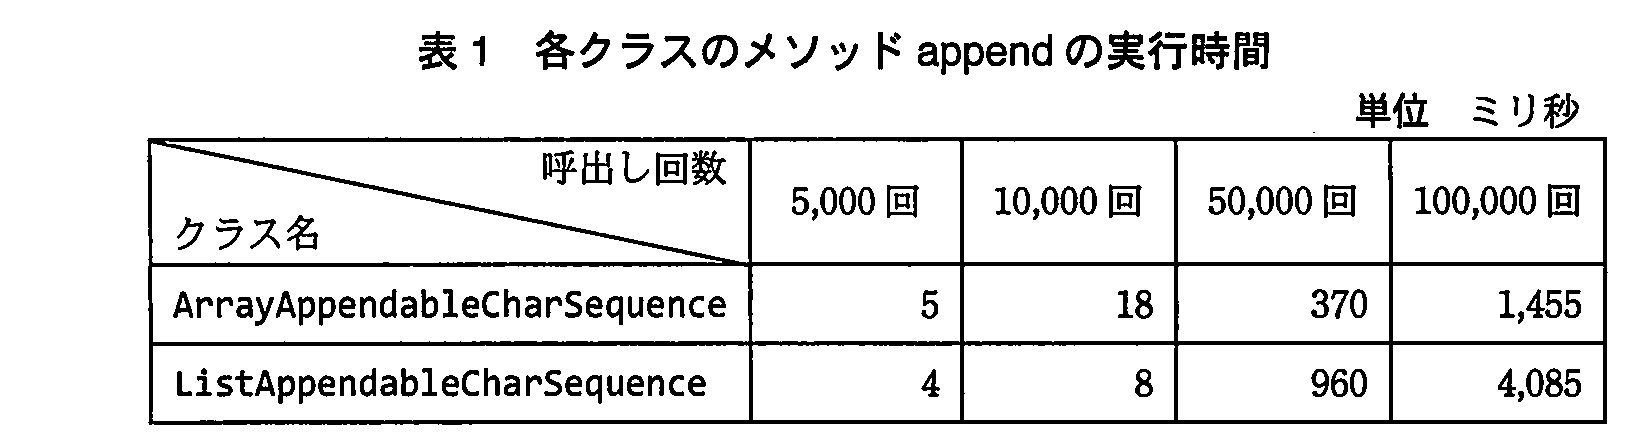
文字の追加回数が多くなるにつれてListAppendableCharSequenceの方が遅くなるのは、連結リストをたどる回数が増えるためであると推測される。そこで、ListAppendableCharSequence.appendの性能を改善するために、次の修正を行った。に入れる正しい答えを、解答群の中から選べ。
なお、ほかの変更はないものとする。
(1) 連結リストの最後の要素を常に参照するためのフィールドlastを追加する。
private Bucket last;
(2) コンストラクタでフィールドlastを初期化する。
public ListAppendableCharSequence() {
bucketList = new Bucket();
last = f;
}
(3) メソッドappendでフィールドlastを利用する。
public AppendableCharSequence append(char c) {
int offset = length % EXT_SIZE;
if (offset == 0 && length != 0) {
last.next = new Bucket();
last = g;
}
last.data[offset] = c;
length++;
return this;
}
解答群
ア:bucketList
イ:bucketList.next
ウ:last
エ:last.next
オ:new Bucket()
カ:null
模範解答
f:ア、g:エ
解説
解答の導き方
この設問では、ListAppendableCharSequenceのappendで、連結リスト(要素同士が次の要素への参照でつながった構造)をたどる回数を減らすための修正を考えます。
現在のappendは、追加する文字を入れるBucketを探すためにgetBucketを呼び出します。getBucketは先頭のBucketから始め、必要な数だけnextをたどります。文字が増えるほどBucketの数も増えるため、後ろのBucketを探すには、より多くの要素をたどることになります。
たとえばBucketの数をとすると、追加を続ける間にたどる回数は、おおよそのように増えていきます。つまり、追加のたびに先頭から探すことが、文字が多いときに遅くなる原因です。
そこで、連結リストの最後のBucketを覚えておくフィールドlastを追加します。lastは、最後のBucketを指す参照(オブジェクトを指し示す値)です。これがあれば、追加するBucketを先頭から探さずに済みます。
まず、コンストラクタではnew Bucket()でBucketを1個作り、それをbucketListに設定しています。この時点ではBucketは1個だけです。そのため、最後のBucketも先頭のBucketと同じです。よって、lastの初期値はbucketListとなり、fにはアが入ります。bucketList.nextは2番目のBucketではなく、まだ次のBucketがないためnullです。
次に、appendで新しいBucketが必要になる場合を考えます。EXT_SIZEは10なので、現在の文字数が10、20のように10の倍数になったとき、次のBucketを用意します。offsetはlength % EXT_SIZEで求めるため、このときoffsetは0です。
たとえば、文字数が10のときは、次のBucketをlast.nextにつなぎます。その後、lastを新しくつないだBucketへ進める必要があります。したがって、
last = last.next;
となり、gにはエが入ります。lastを更新しておけば、次に追加するときも、現在の最後のBucketへ直接文字を格納できます。
誤りやすいポイント
- bucketList.nextをlastの初期値にしないようにします。コンストラクタ直後はBucketが1個だけなので、bucketList.nextはnullです。最後のBucketを指すにはbucketListを使います。
- 新しいBucketをlast.nextにつないだだけで、lastの更新を忘れないようにします。更新しないと、lastは古いBucketを指したままです。
- 毎回新しいBucketを作るわけではありません。offsetが0で、かつlengthが0ではないときだけ、新しいBucketを追加します。それ以外は、lastが指すBucketの空き位置に文字を格納します。
FAQ
Q: 最初の文字を追加するとき、新しいBucketを作らないのはなぜですか。
A: コンストラクタですでにBucketを1個作っているからです。最初の文字は、そのBucketに格納します。
A: コンストラクタですでにBucketを1個作っているからです。最初の文字は、そのBucketに格納します。
Q: lastを更新しないと、どうなりますか。
A: lastが古いBucketを指し続けます。次のBucketが必要になったとき、古いBucketのnextを新しいBucketで置き換えてしまい、それまでにつないだBucketをリストからたどれなくなるおそれがあります。
A: lastが古いBucketを指し続けます。次のBucketが必要になったとき、古いBucketのnextを新しいBucketで置き換えてしまい、それまでにつないだBucketをリストからたどれなくなるおそれがあります。
Q: offsetが0なら、必ず新しいBucketを作るのですか。
A: いいえ。最初の追加ではlengthが0なので、新しいBucketは作りません。すでに文字があり、lengthが0以外のときに新しいBucketを作ります。
A: いいえ。最初の追加ではlengthが0なので、新しいBucketは作りません。すでに文字があり、lengthが0以外のときに新しいBucketを作ります。
関連キーワード: 連結リスト、配列、参照、リスト走査、計算量

