
基本情報技術者 2012年 秋期 午後 問03
電子メールで用いるMIME形式に関する次の記述を読んで、設問1,2に答えよ。
インターネットの電子メールは、規格上、US-ASCIIのような7ビット符号で書かれたテキストしか送信できない。そのため、UTF-8のような8ビット符号で書かれたテキストや、画像データなどのバイナリデータを電子メールで送信する際は、MIME(Multipurpose Internet Mail Extensions)と呼ばれる書式(以下、MIME形式という)に従ってメッセージを作成する。
MIME形式では、7ビット符号で書かれたテキスト以外のコンテンツを、base64やquoted-printableなどの方式で7ビット符号に変換(以下、エンコードという)する。ただし、エンコードを行うコンピュータのメモリ上では、7ビット符号を、先頭に0のビットを1ビット付加した8ビット(1バイト)として取り扱う。
base64によるエンコードでは、コンテンツを先頭から6ビットごとに区切り、各6ビットを、ビットパターンごとに定められた、US-ASCIIの図形文字1文字に変換する。
一方、quoted-printableによるエンコードでは、コンテンツをバイト列とみなし、US-ASCIIの制御文字又は図形文字“=”と一致するバイト、及び先頭ビットが1のバイトを、“=XX”(XXは2桁の16進数字列)の形の3文字のUS-ASCIIの図形文字列に置き換える。US-ASCIIの図形文字(“=”を除く)と一致するバイトは置き換えない。幾つかの例外があるが、ここでは考慮しなくてよいものとする。
例えば、UTF-8で書かれたテキスト“©△IPA△2012.”(“©”には16進数でC2A9の2バイトの符号が、他の文字にはUS-ASCIIと同じ1バイトの符号が、それぞれ割り当てられている)をa1でエンコードすると“=C2=A9△IPA△2012.”になる。同じテキストをa2でエンコードすると“wqkgSVBBIDIwMTIu”となり、いずれもUS-ASCIIに含まれる図形文字だけから成る7ビット符号のバイト列となる。ここで、“△”は空白(符号は16進数で20)を表すものとする。
エンコード後のデータ量に着目すると、大部分がUS-ASCIIに含まれる図形文字で構成されているテキストのエンコードにはa3が適しており、バイナリデータのエンコードにはa4が適している。
UTF-8では、平仮名1文字に先頭ビットが1であるバイト三つから成る符号を割り当てているので、UTF-8で書かれた6文字の平仮名から成るテキストをquoted-printableでエンコードすると、b文字の文字列となる。
設問1:
問題文を見る 記述中のに入れる正しい答えを、解答群の中から選べ。ただし、a1〜a4に入れる答えは、aに関する解答群の中から組合せとして正しいものを選ぶものとする。
aに関する解答群
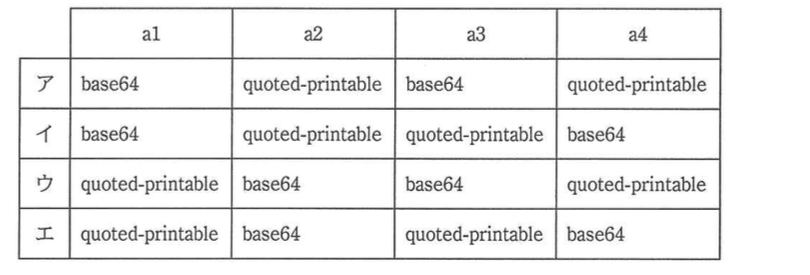
bに関する解答群
ア:8
イ:18
ウ:24
エ:54
模範解答
a:エ、b:エ
解説
解答の導き方
MIME(Multipurpose Internet Mail Extensions:電子メールで文字以外のデータも扱えるようにする拡張形式)では、送信しやすい文字だけを使ってデータを表し直すことがあります。この表し直しをエンコードといいます。
この問題では、base64とquoted-printableのどちらを使ったか、またどちらがデータ量を抑えやすいかを判断します。
-
例の変換結果から、 と を判断します。問題文では、quoted-printableについて「先頭ビットが1のバイト」を“=XX”の形にすると説明しています。UTF-8(Unicode Transformation Format 8-bit:Unicodeの文字をバイト列で表す方式)での“©”は、16進数でC2A9の2バイトです。どちらのバイトも先頭ビットが1なので、“=C2”と“=A9”に変わります。一方、空白や“IPA”など、この例で置換対象にならない部分はそのままです。そのため、“©△IPA△2012.”をquoted-printableでエンコードした結果は“=C2=A9△IPA△2012.”となり、 はquoted-printableです。base64では、問題文にあるとおり「先頭から6ビットごとに区切り」、その値を文字に置き換えます。特定のバイトだけでなく、元のデータ全体を変換する方式です。例の出力“wqkgSVBBIDIwMTIu”が得られるので、 はbase64です。
-
文章データとバイナリデータで、データ量を比べます。US-ASCII(ASCII:American Standard Code for Information Interchangeを基にした、英数字や記号などの文字コード)の図形文字とは、画面に表示できる文字や記号のことです。大部分がUS-ASCIIの図形文字でできたテキストでは、quoted-printableなら置換が必要な部分だけが長くなり、それ以外の部分はそのまま残ります。問題文でも「US-ASCIIの図形文字(“=”を除く)と一致するバイトは置き換えない」とされています。これに対して、base64は元のデータ全体を変換します。したがって、テキストに適しているのはquoted-printableであり、 はquoted-printableです。バイナリデータは、文字としてそのまま送れる部分が少ないことがあります。quoted-printableでは、先頭ビットが1のバイトは1バイトから3文字になります。一方、base64では3バイトを4文字に変換します。バイナリデータではbase64のほうがデータ量を抑えやすいため、 はbase64です。以上の組合せに当てはまるのは、選択肢のエです。
-
平仮名6文字をquoted-printableでエンコードした文字数を求めます。問題文では、UTF-8の平仮名1文字は先頭ビットが1のバイト三つで表されるとあります。したがって、6文字分のバイト数は次のとおりです。quoted-printableでは、先頭ビットが1の1バイトを“=XX”の3文字に置き換えます。よって、エンコード後の文字数は次のとおりです。選択肢では54文字に当たるエを選びます。
誤りやすいポイント
- quoted-printableは、ASCII文字をすべてそのままにする方式ではありません。制御文字(改行など、文字を表示するのではなく動作を指示する文字)や“=”も置換対象です。置換しないのは、“=”を除くUS-ASCIIの図形文字です。
- base64は、先頭ビットが1のバイトだけを変換する方式ではありません。データ全体を6ビット単位で扱います。
- UTF-8では、文字数とバイト数が一致しないことがあります。この問題の平仮名は1文字が3バイトなので、まずバイト数を求めてからエンコード後の文字数を計算します。
- quoted-printableで“=XX”にする場合、元の1バイトは3文字になります。「1バイトが1文字になる」と考えないようにします。
FAQ
Q: quoted-printableでは、なぜ“=”も置換するのですか?
A: “=”は、quoted-printableで置換後のバイトを示すときにも使います。そのため、元のデータにある“=”をそのまま残すと、置換用の記号と区別できなくなるので、置換します。
Q: base64はデータを暗号化する方式ですか?
A: いいえ。base64はデータを別の文字列で表すための方式です。秘密にするための暗号化とは目的が異なります。
Q: 平仮名6文字なのに、計算では18バイトとして扱うのはなぜですか?
A: この問題では、UTF-8の平仮名1文字が3バイトで表されるためです。quoted-printableは文字ではなくバイトを置換するので、まず6文字を18バイトに直して考えます。
関連キーワード: MIME、base64、quoted-printable、UTF-8、US-ASCII

設問2:
問題文を見る MIME形式を使用すると、1通の電子メールに複数のコンテンツを格納することができる。1通の電子メールに二つのコンテンツを格納したMIME形式のメッセージは、図1のようになる。
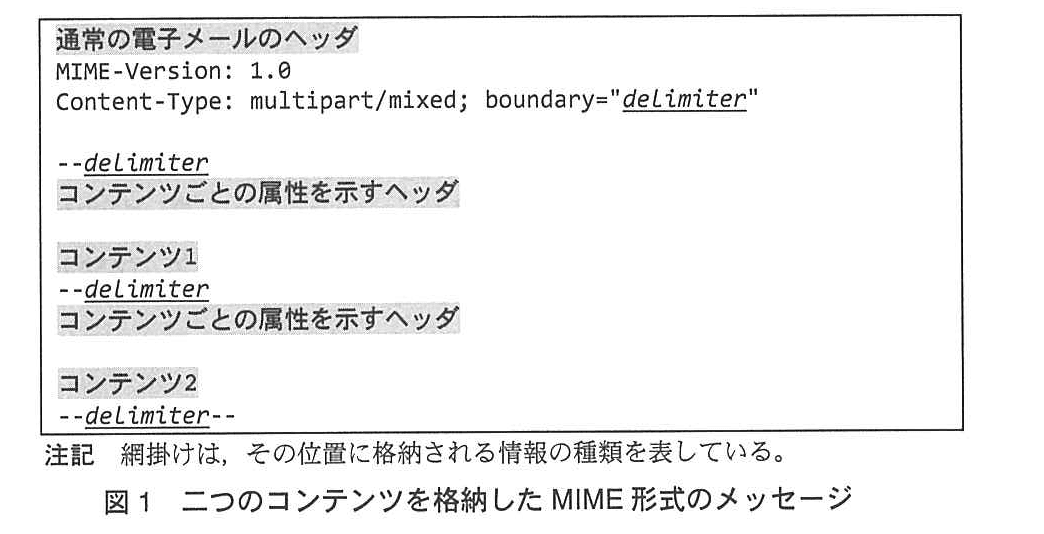
boundary="delimiter"のdelimiterには、格納したコンテンツの区切りを示す文字列を指定する。
delimiterの先頭に“--”を付けたものが一つのコンテンツの開始を示し、delimiterを“--”で囲ったものが最後のコンテンツの終了を示す。
delimiterには、コンテンツに含まれる行が、誤ってコンテンツの区切りと認識されることのないような文字列を、選択しなければならない。
“コンテンツごとの属性を示すヘッダ”には、テキストや画像などのコンテンツの種類や、エンコードの方式などを指定する。エンコードの方式には“base64”や“quoted-printable”のほか、コンテンツがエンコードされていない7ビット符号のテキストであることを示す“7bit”などが指定できる。
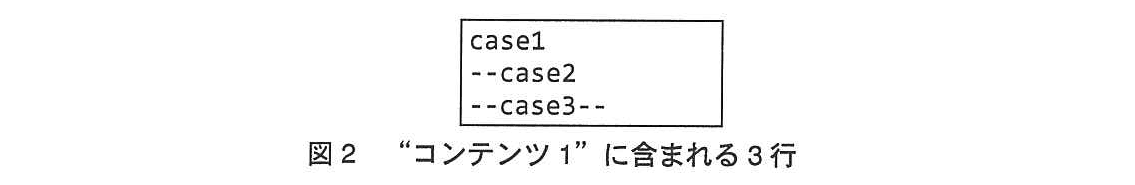
図1中の“コンテンツ1”が7ビット符号のテキストであって、図2に示す3行をコンテンツに含むとき、delimiterとしてふさわしくない文字列を、解答群の中から三つ選べ。
解答群
ア:--case1
イ:--case2
ウ:--case3
エ:case1
オ:case2
カ:case3
キ:case1--
ク:case2--
ケ:case3--
模範解答
オ、カ、ケ
解説
解答の導き方
この設問では、図2にある3行が、MIME(Multipurpose Internet Mail Extensions:電子メールでテキスト以外のデータなども扱えるようにする書式)のコンテンツ境界と誤認される候補を探します。
本文には、boundaryに指定した文字列の先頭に「--」を付けるとコンテンツの開始を示し、文字列を「--」で囲むと最後のコンテンツの終了を示す、とあります。つまり、候補ごとに次の2種類の行を作り、図2の行と一致するかを確認します。
- 開始を示す行:「--」+boundaryの文字列
- 終了を示す行:「--」+boundaryの文字列+「--」
図2の3行は、「case1」「--case2」「--case3--」です。それぞれの候補について、作られる開始行または終了行が、この3行のどれかと一致するかを調べます。
コンテンツ内の行が境界の行と一致してしまうのは、オ、カ、ケです。
誤りやすいポイント
- 候補の文字列だけを見るのではなく、候補に「--」を付けて作られる境界の行を確認します。たとえば、候補が「case2」なら、開始行は「--case2」です。
- 図2の行に候補と同じ文字列が含まれていても、行全体が境界の行と一致しなければ誤認されません。
- カとケは、候補の文字列が異なります。しかし、カでは終了行が「--case3--」になり、ケでは開始行が「--case3--」になるため、どちらも図2の3行目と一致します。
FAQ
Q: 「case1」が図2にあるのに、エはふさわしくない候補ではないのですか?
A: エの候補は「case1」です。この場合、境界の開始行は「--case1」ですが、図2の行は「case1」なので一致しません。
A: エの候補は「case1」です。この場合、境界の開始行は「--case1」ですが、図2の行は「case1」なので一致しません。
Q: カとケは、なぜ両方ともふさわしくないのですか?
A: カでは「--case3--」が終了行として作られます。ケでは同じ「--case3--」が開始行として作られます。どちらも図2の3行目と一致します。
A: カでは「--case3--」が終了行として作られます。ケでは同じ「--case3--」が開始行として作られます。どちらも図2の3行目と一致します。
関連キーワード: MIME、マルチパート形式、boundary、電子メール、区切り文字

