
基本情報技術者 2015年 春期 午後 問03
自治会員の情報を管理する関係データベースの設計及び運用に関する次の記述を読んで、設問1〜4に答えよ。
X地区の自治会では、世帯数の増加と、個人情報管理の厳格化を背景に、手書きの帳票で管理していた自治会員の情報を電子化することにした。この自治会には、236世帯、667人が登録されていて、各世帯は1〜8班のいずれかに所属している。
従来は図1に示すとおり、世帯ごとに、世帯主氏名、住所、電話番号、登録日、所属する班、同居者氏名、続柄、性別、生年月日などの情報を管理していた。
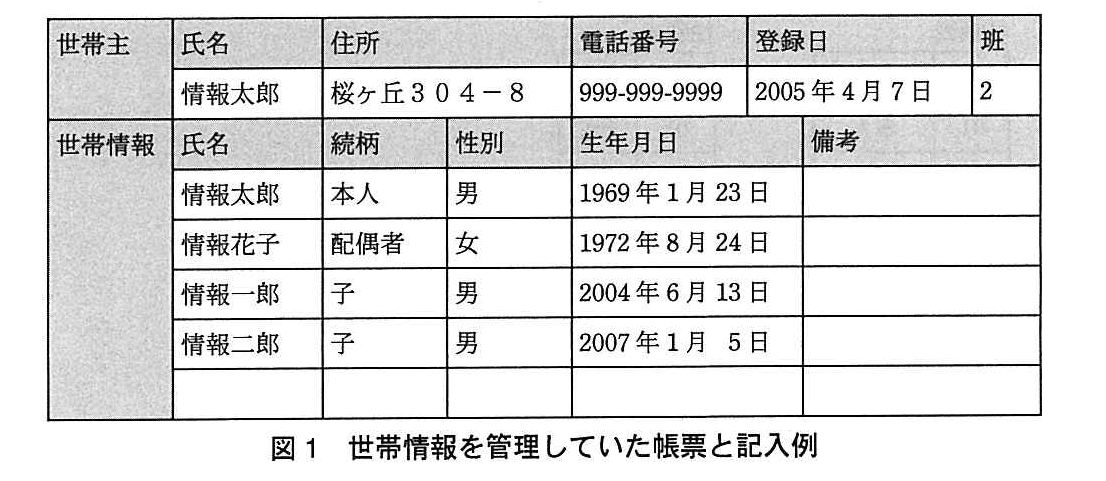
図1の帳票を基に、図2に示す表構成をもつ関係データベースを作成した。下線付きの項目は、主キーを表す。
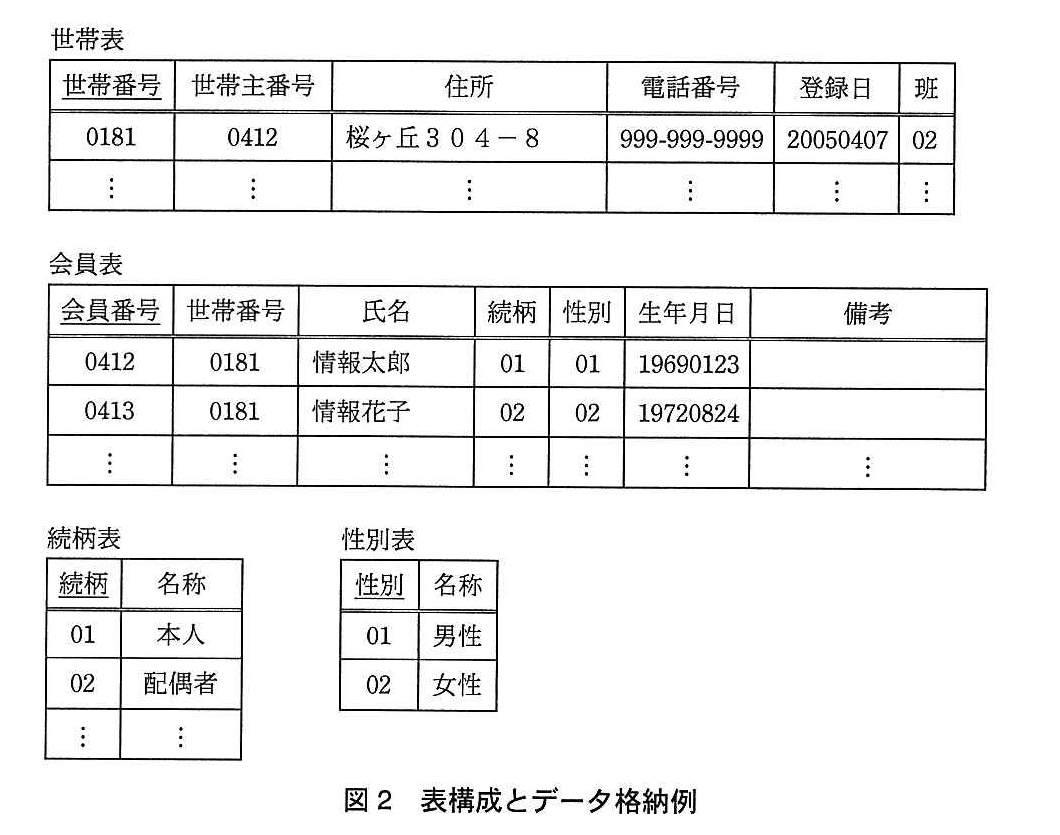
〔表の説明〕
(1) 世帯表の世帯番号には、各世帯に一意に割り当てた番号が格納されている。
(2) 世帯表の世帯主番号には、世帯主の会員番号が格納されている。
(3) 会員表の会員番号には、各会員に一意に割り当てた番号が格納されている。
(4) 会員表の世帯番号には、会員が属する世帯の世帯番号が格納されている。
設問1:
問題文を見る模範解答
a:イ、b:エ
解説
解答の導き方
この問題では、帳票にある情報をどのように表へ分けるかを考えます。正規化とは、データの重複や食い違いを減らすために、表を整理することです。
まず、図1には世帯主の情報のほかに、同じ世帯に住む複数の人の氏名や続柄などが記録されています。つまり、世帯情報の中に、会員ごとに繰り返される情報があります。この繰り返しを会員ごとの行に分けて、会員表を作るのが第1正規化に基づく整理です。そのため、aには「第1正規化に基づいて」が入ります。
次に、図2では、会員表に「続柄」や「性別」の値を記録し、その値の名称を続柄表や性別表で管理しています。例えば、性別の名称を会員表の各行に直接記録すると、「男」と「男性」のように、同じ意味なのに異なる書き方が混在する可能性があります。性別表に名称を一つだけ登録すれば、同じ性別コードには常に同じ名称を対応させられます。
このように、会員番号から続柄コードが決まり、続柄コードから続柄の名称が決まる関係を考えます。主キー(表の中で行を一つに特定する項目)である会員番号から、別の項目を経由して名称が決まる関係を整理するのは、第3正規化に基づく考え方です。したがって、bには「第3正規化に基づいて」が入ります。
誤りやすいポイント
- 第1正規化と第3正規化を混同しないようにしましょう。第1正規化では、会員ごとに繰り返される情報を分けることがポイントです。
- 続柄表や性別表の件数が少ないことだけを理由に、第3正規化だと判断するわけではありません。名称を一元管理し、表記の食い違いを防ぐことがポイントです。
- 「男」と「男性」のような表記の違いを防ぐ効果は、続柄表や性別表を作る理由の一つです。正規化の段階を選ぶときは、情報の依存関係にも注目しましょう。
FAQ
Q: 第1正規化と第3正規化の違いは何ですか?
A: 第1正規化は、繰り返される情報を分け、項目を一つずつ扱える形にすることが中心です。第3正規化は、主キーから別の項目を経由して決まる情報を分けて整理することが中心です。
A: 第1正規化は、繰り返される情報を分け、項目を一つずつ扱える形にすることが中心です。第3正規化は、主キーから別の項目を経由して決まる情報を分けて整理することが中心です。
Q: 続柄や性別を、会員表に名称で記録してはいけないのですか?
A: 記録自体はできますが、表記が「男」と「男性」のように揺れる可能性があります。別の表でコードと名称を対応させれば、名称を統一して管理できます。
A: 記録自体はできますが、表記が「男」と「男性」のように揺れる可能性があります。別の表でコードと名称を対応させれば、名称を統一して管理できます。
Q: 正規化では、表を細かく分けるほどよいのですか?
A: むやみに分けるのではなく、繰り返しやデータの依存関係を整理するために分けます。この問題では、会員ごとの情報と、続柄・性別の名称を分けています。
A: むやみに分けるのではなく、繰り返しやデータの依存関係を整理するために分けます。この問題では、会員ごとの情報と、続柄・性別の名称を分けています。
関連キーワード: 正規化、第一正規形、第三正規形、主キー、推移的従属性

設問2:
問題文を見る 地区の福祉委員会から、1940年よりも前に生まれた会員が含まれる世帯の世帯番号について、情報提供を求められた。該当する世帯番号を抽出する正しいSQL文を解答群の中から選べ。
なお、同じ世帯番号は一つだけ抽出する。
解答群
ア:SELECT DISTINCT 世帯番号 FROM 会員表 WHERE 会員表.生年月日 >= 19400101
イ:SELECT 世帯番号 FROM 会員表 WHERE 会員表.生年月日 >= 19391231
ウ:SELECT 世帯番号 FROM 会員表 WHERE 会員表.生年月日 < 19400101 GROUP BY 世帯番号
エ:SELECT 世帯番号 FROM 会員表 WHERE 会員表.生年月日 <= 19391231 GROUP BY 世帯番号, 会員番号
模範解答
ウ
解説
解答の導き方
求めるのは、1940年よりも前に生まれた会員がいる世帯の「世帯番号」です。会員ごとに生年月日を調べたあと、該当する会員が複数いる世帯も、世帯番号は一度だけ表示する必要があります。
SQL(Structured Query Language:データベースを操作する言語)の条件を考えるときは、まず「1940年よりも前」を読み取ります。図2の生年月日は「19690123」のように年月日の順で格納されています。この形式では、1940年より前の日付は「19400101」より小さくなります。1940年1月1日は「1940年よりも前」ではないので、条件は「生年月日 < 19400101」です。
この条件に合う会員を選ぶのが、WHERE句(表から条件に合う行を選ぶ部分)の役目です。その後、同じ世帯番号を一度だけ表示する必要があります。ウは、条件に合う行を世帯番号ごとにまとめるGROUP BY句(同じ値をもつ行をグループにする部分)を使っています。選ぶ項目も世帯番号だけなので、該当者が同じ世帯に複数いても、世帯番号は一度だけ出力されます。
ほかの選択肢も確認します。
- アは「生年月日 >= 19400101」で、1940年以降に生まれた会員を選びます。必要な条件とは逆です。DISTINCT(重複した値を一つにまとめる指定)を使っていても、抽出する対象が違います。
- イも「生年月日 >= 19391231」と、1940年より前の会員を選ぶ条件になっていません。また、世帯番号の重複を取り除く指定もありません。
- エの「生年月日 <= 19391231」は、1940年より前の日付を選ぶ条件としては使えます。しかし、世帯番号だけでなく会員番号ごとにもグループを分けます。会員番号は会員ごとに異なるため、同じ世帯の該当会員が複数いると、その世帯番号も複数回出る可能性があります。
誤りやすいポイント
- 「1940年よりも前」を「1940年以降」と取り違えないようにします。「前」なので、1940年1月1日より小さい日付を選びます。
- 条件に合う会員を選ぶことと、世帯番号の重複をなくすことは別の処理です。両方を確認します。
- GROUP BY句に会員番号まで含めると、同じ世帯の会員をまとめられません。何を一度だけ表示したいのかに合わせて、グループ化する項目を選びます。
FAQ
Q: GROUP BY句は、合計などを計算するときだけ使うのですか?
A: いいえ。同じ値をもつ行をまとめるためにも使えます。この問題では世帯番号ごとにまとめるので、該当する世帯番号を一度だけ表示できます。
A: いいえ。同じ値をもつ行をまとめるためにも使えます。この問題では世帯番号ごとにまとめるので、該当する世帯番号を一度だけ表示できます。
Q: DISTINCTを使えば、同じ世帯番号を一度だけ表示できますか?
A: はい。重複を取り除けます。ただし、先に生年月日の条件が正しい必要があります。アはDISTINCTを使っていますが、抽出条件が逆です。
A: はい。重複を取り除けます。ただし、先に生年月日の条件が正しい必要があります。アはDISTINCTを使っていますが、抽出条件が逆です。
Q: 19391231を条件に使う選択肢は、なぜ正解ではないのですか?
A: エは日付条件だけを見ると該当する日付を選べますが、世帯番号と会員番号の組合せごとにグループ化します。そのため、同じ世帯に該当する会員が複数いれば、世帯番号も複数回出る可能性があります。
A: エは日付条件だけを見ると該当する日付を選べますが、世帯番号と会員番号の組合せごとにグループ化します。そのため、同じ世帯に該当する会員が複数いれば、世帯番号も複数回出る可能性があります。
関連キーワード: SQL、WHERE句、GROUP BY句、DISTINCT、重複排除
設問3:
問題文を見る 班ごとの会員数に偏りがあるとの意見が挙がったので、班の再編を検討することになった。現在の状況を確認するために、班ごとの世帯数と会員数を集計する。次のSQL文のに入れる正しい答えを、解答群の中から選べ。
SELECT 世帯表.班, c
FROM 世帯表, 会員表
WHERE 世帯表.世帯番号 = 会員表.世帯番号
GROUP BY 世帯表.班
解答群
ア:COUNT(*), COUNT(会員表.会員番号)
イ:COUNT(*), MAX(会員表.会員番号)
ウ:COUNT(DISTINCT 世帯表.世帯番号), COUNT(*)
エ:COUNT(世帯表.世帯番号), MAX(会員表.会員番号)
模範解答
c:ウ
解説
解答の導き方
求めるのは、班ごとの「世帯数」と「会員数」です。SQL(Structured Query Language:関係データベースのデータを問い合わせたり操作したりする言語)では、COUNTなどの集計関数を使って数を求めます。
まず、FROM句では世帯表と会員表を使い、WHERE句で「世帯表.世帯番号 = 会員表.世帯番号」として結び付けています。会員表の世帯番号は、会員が属する世帯の番号です。そのため、結び付けた結果では、同じ世帯の情報が、その世帯に属する会員の人数分だけ並びます。
たとえば、ある世帯に4人の会員がいる場合、結び付けた結果にはその世帯番号が4回現れます。このときCOUNT(*)を使うと、世帯数ではなく、結び付けた結果の行数、つまり会員数を数えます。
次に、世帯数を数える方法を考えます。世帯番号の重複を除いて数える必要があります。DISTINCTは、同じ値を一つにまとめる指定です。したがって、COUNT(DISTINCT 世帯表.世帯番号)なら、同じ世帯番号が何回現れても1世帯として数えられます。
さらに、GROUP BY 世帯表.班によって、班ごとに結果がまとめられます。つまり、世帯数はCOUNT(DISTINCT 世帯表.世帯番号)、会員数はCOUNT(*)で求めます。この組合せは解答群のウです。
ほかの選択肢が適切でない理由も確認します。
- アは、会員数を数えるCOUNT(会員表.会員番号)は使えますが、COUNT(*)で世帯数を数えると、同じ世帯が会員の人数分だけ数えられてしまいます。
- イとエのMAX(会員表.会員番号)は、会員番号の最大値を求める関数であり、会員数を数えるものではありません。
- エのCOUNT(世帯表.世帯番号)も、同じ世帯番号を重複して数えるため、世帯数にはなりません。
誤りやすいポイント
- 世帯表と会員表を結び付けた後は、世帯の行が会員数分だけ増えることを見落としやすいです。
- COUNT(*)は世帯数を数える関数ではありません。結び付けた後の結果では、該当する行数を数えます。
- COUNT(DISTINCT ...)は、重複を除いて数えたいときに使います。世帯数のように、同じ番号が複数回現れる場合に有効です。
- MAXは最大値を求める関数です。番号が並んでいるからといって、件数を数えているわけではありません。
FAQ
Q: COUNT(*)とCOUNT(会員表.会員番号)は、いつも同じ結果になりますか?
A: この問題では、結び付けた各行に会員番号が存在するため、どちらも会員数を数えます。ただし、一般には、COUNT(*)は行数を数え、COUNT(項目名)はその項目が空でない行だけを数えるという違いがあります。
Q: COUNT(DISTINCT 世帯表.世帯番号)のDISTINCTは何をしていますか?
A: 同じ世帯番号が複数回出てきても、重複分をまとめてから数えます。そのため、世帯ごとの会員数に関係なく、各世帯を1回ずつ数えられます。
Q: GROUP BY 世帯表.班は何のために使いますか?
A: 班ごとにデータをまとめ、その単位で世帯数や会員数を集計するためです。
関連キーワード: 関係データベース、表の結合、GROUP BY、集計関数、COUNT、DISTINCT
設問4:
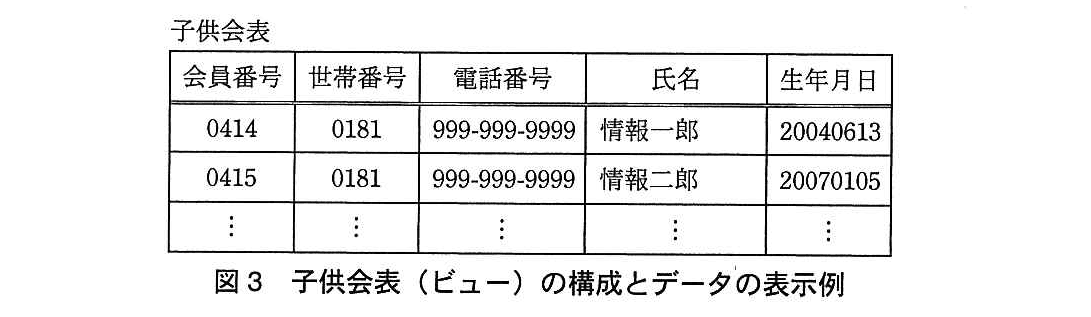
問題文を見る 地区の子供会役員から、子供会に所属する子供の情報を照会できるようにしてほしいとの要望が挙がったので、図3に示すビューを作成することにした。子供会には、生年月日が20030402〜20090401の会員が所属する。次のSQL文のに入れる正しい答えを、解答群の中から選べ。
CREATE VIEW 子供会表 AS
SELECT 会員表.会員番号, 会員表.世帯番号,
世帯表.電話番号, 会員表.氏名, 会員表.生年月日
FROM 世帯表, 会員表
WHERE d
解答群
ア:会員表.会員番号 = ANY(SELECT 会員表.会員番号 FROM 会員表 WHERE 会員表.生年月日 IN(20030402, 20090401))
イ:会員表.会員番号 = 世帯表.世帯主番号 AND 会員表.生年月日 BETWEEN 20030402 AND 20090401
ウ:会員表.世帯番号 = ANY(SELECT 会員表.世帯番号 FROM 会員表 WHERE 会員表.生年月日 IN(20030402, 20090401))
エ:会員表.世帯番号 = 世帯表.世帯番号 AND 会員表.生年月日 BETWEEN 20030402 AND 20090401
模範解答
d:エ
解説
解答の導き方
この設問では、子供会表の各行に必要な情報を、世帯表と会員表から正しく取り出す条件を考えます。SQL(Structured Query Language:データベースに問い合わせるための言語)で作るビュー(表のように参照できる、検索結果の見せ方)です。
まず、SELECT句には会員表の会員番号・世帯番号・氏名・生年月日と、世帯表の電話番号があります。つまり、会員の情報は会員表から、電話番号はその会員が属する世帯の世帯表から取り出します。
この二つの表を正しく対応させるには、会員表の世帯番号と世帯表の世帯番号が等しいことが必要です。FROM句に二つの表を並べただけでは、各会員と各世帯のあらゆる組合せができてしまいます。世帯番号を等しくする条件を加えることで、会員の属する世帯の電話番号を取得できます。
次に、子供会に所属する会員の範囲を指定します。問題文では、生年月日が「20030402〜20090401」の会員が対象です。SQLのBETWEENは、指定した下限と上限を含む範囲を表します。そのため、生年月日が20030402以上、かつ20090401以下であることを指定できます。
必要な条件は、次の二つです。
- 会員表と世帯表を世帯番号で対応させる
- 会員表の生年月日を指定された範囲に絞る
この二つを同時に満たすのはエです。会員番号と世帯主番号を結び付ける必要はありません。子供会の会員は、世帯主ではない会員も含むためです。
誤りやすいポイント
- アは、INで生年月日が20030402または20090401と等しい会員だけを調べています。範囲内のほかの日付は含まれません。また、世帯表と会員表を世帯番号で対応させる条件もありません。
- イは、生年月日の範囲は指定できていますが、会員番号と世帯主番号を等しくしています。この条件では世帯主だけが対象となり、子供会に所属する会員を正しく取得できません。
- ウは、生年月日が指定範囲内かどうかを、取り出す会員それぞれについて確認していません。また、生年月日が範囲の両端と一致する会員の世帯番号を使う条件になっています。
- BETWEENは範囲の端を含みます。指定された期間の初日や最終日も対象になります。
FAQ
Q: BETWEENの範囲に、20030402と20090401は含まれますか?
A: 含まれます。BETWEENは下限と上限の両方を含む条件です。
A: 含まれます。BETWEENは下限と上限の両方を含む条件です。
Q: 世帯主番号ではなく、世帯番号を使うのはなぜですか?
A: 子供会の対象者は世帯主に限られません。会員表の世帯番号と世帯表の世帯番号を対応させれば、世帯主以外の会員についても、その会員が属する世帯の電話番号を取得できます。
A: 子供会の対象者は世帯主に限られません。会員表の世帯番号と世帯表の世帯番号を対応させれば、世帯主以外の会員についても、その会員が属する世帯の電話番号を取得できます。
Q: ビューは通常の表と何が違いますか?
A: ビューは、表のようにデータを参照できる仕組みです。今回のように複数の表から必要な列や行を選び、利用目的に合わせた見せ方を作れます。
A: ビューは、表のようにデータを参照できる仕組みです。今回のように複数の表から必要な列や行を選び、利用目的に合わせた見せ方を作れます。
関連キーワード: SQL、ビュー、表結合、BETWEEN、主キー

