
基本情報技術者 2015年 春期 午後 問11
次のJavaプログラムの説明及びプログラムを読んで、設問1,2に答えよ。
〔プログラムの説明〕
D社では、利用者が入力した文字列をHTMLに埋め込むことによって、動的にWebページを生成するアプリケーションを開発している。
このようなアプリケーションでは、利用者が入力した文字列をHTMLに埋め込む際の処理が不適切な場合、情報漏えいの発生などシステムの安全な運用を脅かすおそれがある。
利用者が入力した文字列をHTMLに埋め込む前には、サニタイズすることが必要である。サニタイズとは、システムの安全な運用を脅かす文字列を、無害な文字列に変換することをいう。文字列の変換方法は、文字列を埋め込む場所によって異なる。
当該アプリケーションでは、HTMLのタグの間(ただし、“”との間は除く)に文字列を埋め込むケースと、JavaScriptの文字列として埋め込むケースの二つのケースでサニタイズする必要がある。サニタイズは、変換前の文字列中の各文字を、それぞれ次のように変換することによって行うことにした。
(1) HTMLのタグの間に文字列を埋め込むケース
① 英数字と次に示す文字は、そのまま出力する。
!#$%()*+,-.:;=?@[]^_`{|}~
② 表1に示す文字は、実体参照に変換する。
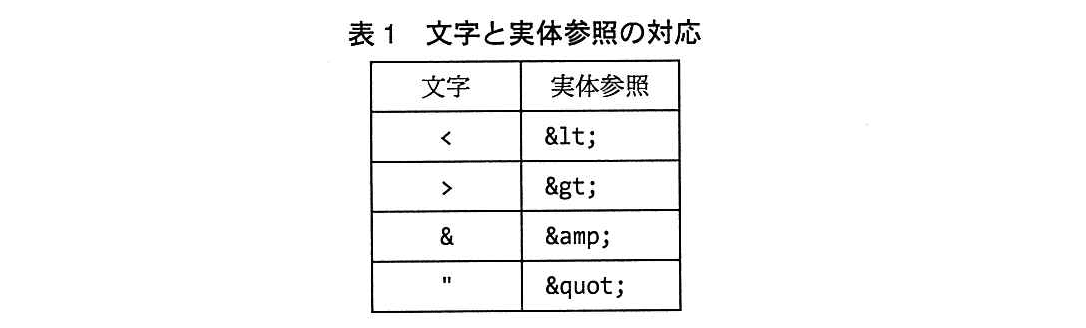
③ その他の文字は、“&#ddd;”に変換する。ここで、dddは変換対象文字の文字コードを表す、最大で5桁の10進数である。また、変換前の文字列に含まれる各文字は、2バイトで表すことができるものとする。
(2) JavaScriptの文字列として埋め込むケース
① 英数字は、そのまま出力する。
② 文字コードが256未満の英数字以外の文字は、“\xXX”に変換する。ここで、XXは変換対象の文字の文字コードを表す、2桁の16進数である。
③ その他の文字は、“\uXXXX”に変換する。ここで、XXXXは変換対象の文字の文字コードを表す、4桁の16進数である。また、変換前の文字列に含まれる各文字は、2バイトで表すことができるものとする。
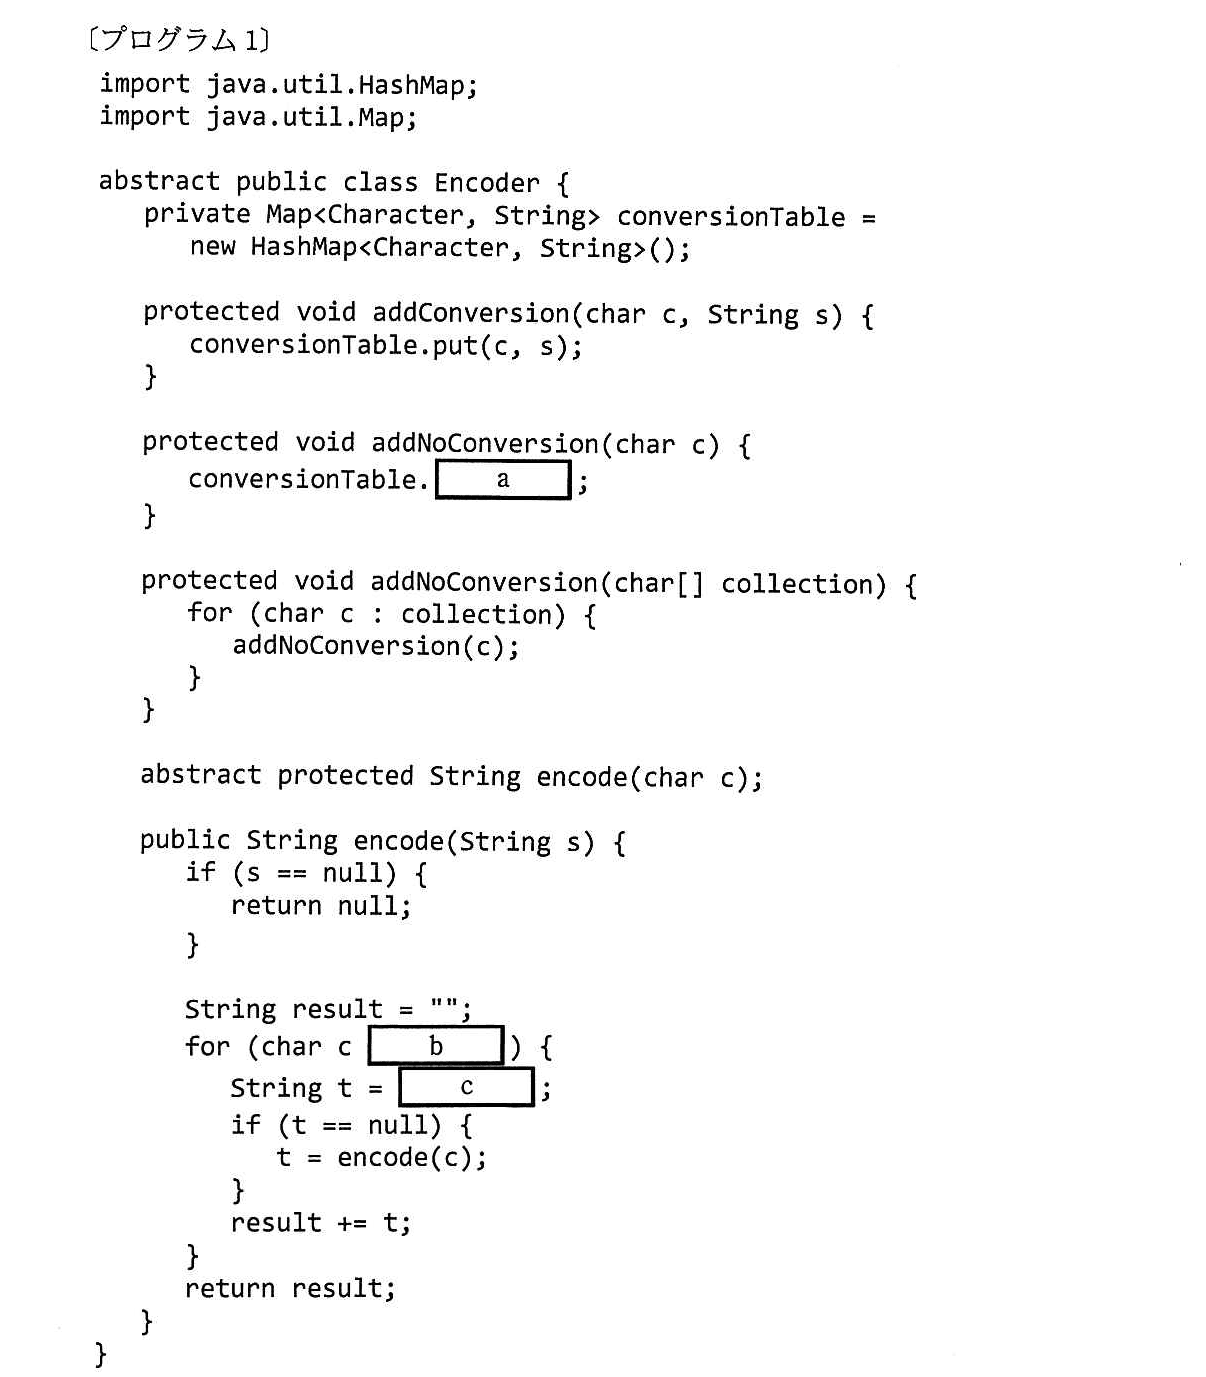
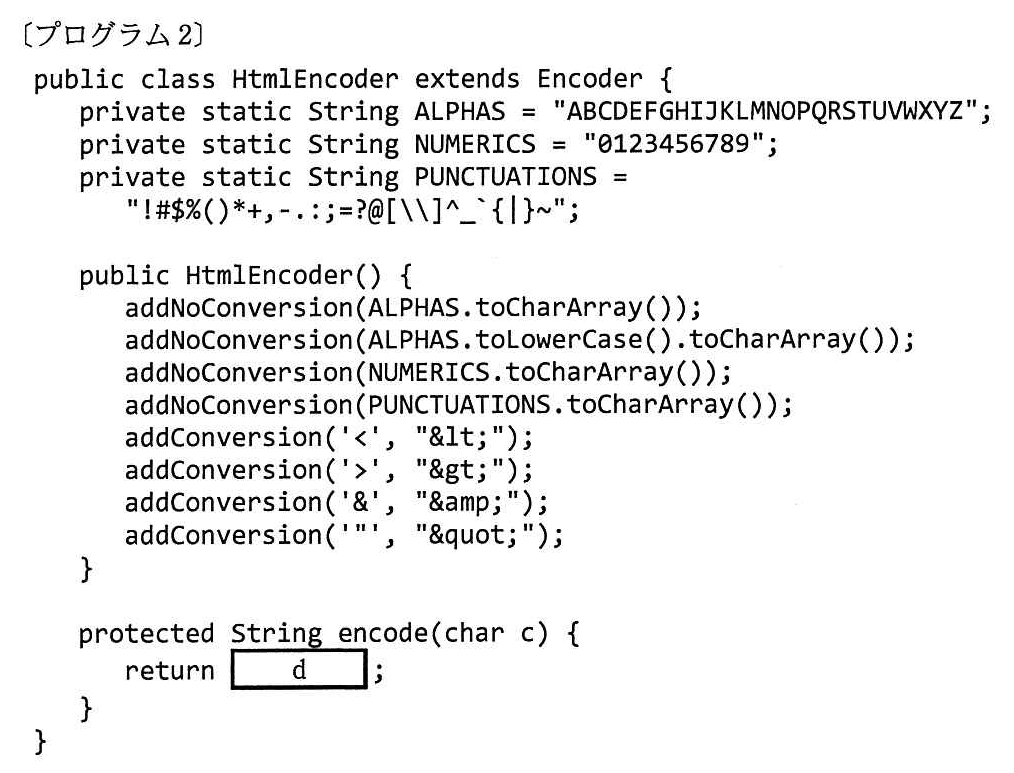
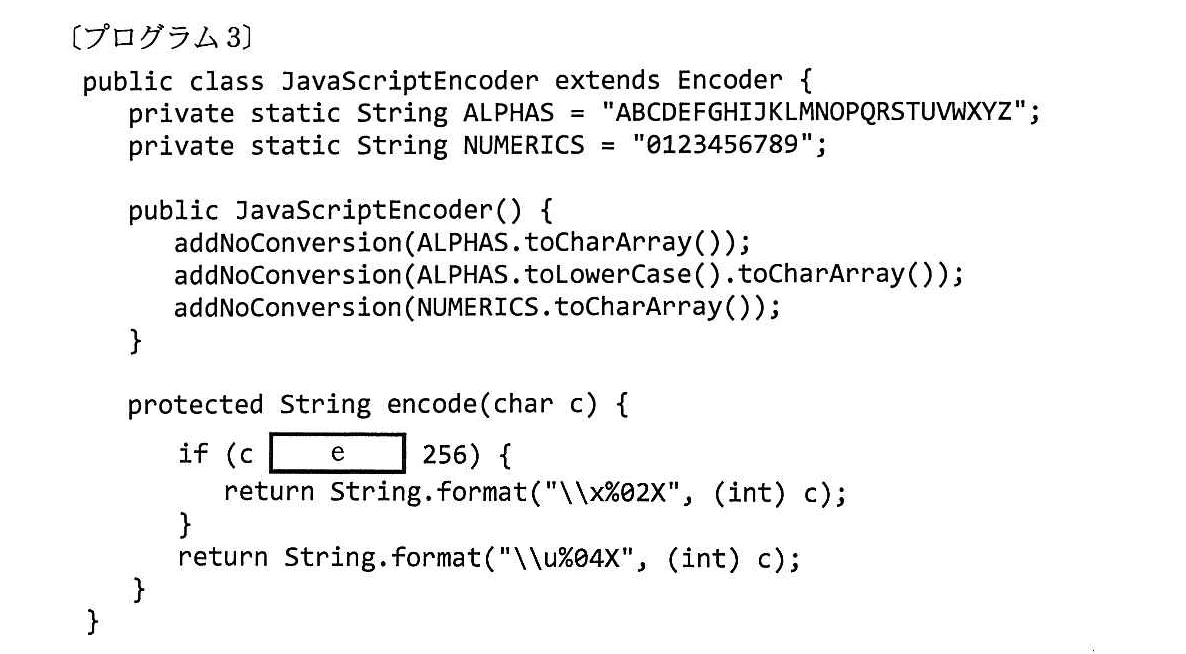
クラスEncoderは、サニタイズを行うクラスが継承する抽象クラスである。パブリックメソッドencodeは、引数で与えられた文字列をサニタイズし、結果を返す。クラスHtmlEncoderは、HTMLのタグに埋め込む文字列をサニタイズするクラスである。クラスJavaScriptEncoderは、JavaScriptの文字列として埋め込む文字列をサニタイズするクラスである。
設問1:
問題文を見る プログラム1〜3中のに入れる正しい答えを、解答群の中から選べ。
aに関する解答群
ア:clear()
イ:get(c)
ウ:put(c, String.valueOf(c))
エ:remove(c)
bに関する解答群
ア:: conversionTable.keySet()
イ:: s.toCharArray()
ウ:= 0; c < s.length(); c++
エ:= 0; s.indexOf(c) > 0; c++
cに関する解答群
ア:addConversion(c, t)
イ:addNoConversion(c)
ウ:conversionTable.get(c)
エ:conversionTable.remove(c)
dに関する解答群
ア:"&#" + (int) c + ";"
イ:"&#" + c + ";"
ウ:"\u" + (int) c
エ:"\u" + c
eに関する解答群
ア:!=
イ:<
ウ:==
エ:>
模範解答
a:ウ、b:イ、c:ウ、d:ア、e:イ
解説
解答の導き方
このプログラムでは、入力文字列の各文字について、あらかじめ登録した変換方法があればそれを使い、なければ用途に応じた変換を行います。まず、共通部分のプログラムから順に考えます。
-
a:変換しない文字も、表に登録しますconversionTableは、文字と変換後の文字列を対応付ける表です。たとえば、文字「<」に対して「<」を登録すれば、文字「<」を見つけたときに「<」を出力できます。addNoConversionは、変換せずにそのまま出力する文字を登録するためのメソッドです。そのため、文字cをキーにして、値にはc自身を文字列にしたものを登録します。これに該当するのは「put(c, String.valueOf(c))」で、aはウです。remove(c)を使うと、文字を表から削除してしまいます。すると、後で「変換方法が登録されていない」と判断され、別の変換が行われてしまいます。
-
b:入力文字列を1文字ずつ取り出しますencode(String s)では、文字列sの各文字を順に処理する必要があります。拡張for文の「for (char c : ... )」には、1文字ずつ取り出せる配列などを指定します。「s.toCharArray()」は、文字列sを文字の配列にする処理です。したがって、bはイです。
-
c:表に変換方法が登録されているか調べますループの中では、現在の文字cについて変換表を調べ、その結果をtに入れます。表からキーに対応する値を取り出すメソッドは「get(c)」なので、cはウです。表に変換後の文字列が登録されていれば、その文字列をそのまま結果に加えます。登録されておらず、取り出した値がnullなら、後続の「encode(c)」を呼び出して変換します。つまり、共通の処理がまず変換表を確認し、表にない文字はHTML用またはJavaScript用の処理に任せています。
-
d:HTML用では、残りの文字を10進数の文字参照にしますHTML(HyperText Markup Language:Webページの構造を記述する言語)のタグの間に文字を埋め込む場合、「<」「>」「&」「"」は表に登録された実体参照に変換されます。また、英数字と指定された記号は、そのまま出力します。それ以外の文字は、問題文のとおり「&#ddd;」の形式に変換します。dddは文字コードを表す10進数です。Javaでは「(int) c」として文字cを整数にすると、文字そのものではなく文字コードを取り出せます。そのため、必要な戻り値は「"&#" + (int) c + ";"」で、dはアです。「"&#" + c + ";"」では、cの文字そのものが文字列に加わり、文字コードの数字になりません。
-
e:JavaScript用では、文字コードが256未満かを調べますJavaScriptの文字列として埋め込む場合、英数字は表に登録されているので、そのまま出力されます。残りの文字については、文字コードが256未満なら「\xXX」、それ以外なら「\uXXXX」に変換します。したがって、条件は「c < 256」です。eはイです。文字コードが256未満のときだけ2桁の16進数形式を使い、それ以上のときは4桁の16進数形式を使うため、問題文のルールと一致します。
誤りやすいポイント
-
変換しない文字を表に登録する理由を見落とすこと変換しない文字も、元の文字を値として登録します。登録しておけば、後で変換表を調べたときにnullにならず、別の変換処理に進みません。
-
addNoConversionを「変換表から削除する処理」と考えること削除すると、その文字は表にない扱いになります。するとencode(c)が呼ばれ、HTML用またはJavaScript用の変換対象になってしまいます。
-
表にない文字の処理を取り違えること変換表に登録されていない場合は、サブクラス側のencode(c)で処理します。HTML用とJavaScript用では変換ルールが異なるため、この使い分けが必要です。
-
文字と文字コードを混同すること「c」を文字列に加えると文字そのものが加わります。一方、「(int) c」は文字コードを整数として取り出します。HTML用の数値文字参照を作るには、文字コードが必要です。
-
256との比較を逆にすること「c < 256」のときに「\xXX」を使います。条件を「c > 256」などにすると、2種類の変換形式を使う文字の範囲が逆になってしまいます。
FAQ
Q: なぜ変換表にない文字だけ、別のencodeメソッドで処理するのですか?
A: 英数字など、変換せずに出力する文字や、決まった置き換え先がある文字は変換表で処理できます。そこに登録されていない文字だけをHTML用またはJavaScript用の処理に渡すことで、共通部分と用途ごとの処理を分けています。
A: 英数字など、変換せずに出力する文字や、決まった置き換え先がある文字は変換表で処理できます。そこに登録されていない文字だけをHTML用またはJavaScript用の処理に渡すことで、共通部分と用途ごとの処理を分けています。
Q: HTML用とJavaScript用で変換方法が違うのはなぜですか?
A: 文字列を埋め込む場所によって、特別な意味をもつ文字が異なるためです。HTMLのタグの間で必要な変換と、JavaScriptの文字列の中で必要な変換は同じではありません。
A: 文字列を埋め込む場所によって、特別な意味をもつ文字が異なるためです。HTMLのタグの間で必要な変換と、JavaScriptの文字列の中で必要な変換は同じではありません。
Q: nullはここではどのような意味ですか?
A: この処理では、変換表から値を取り出したときにnullなら、その文字に対応する変換方法が表に登録されていないという意味です。その場合に限り、用途ごとのencode(c)で変換します。
A: この処理では、変換表から値を取り出したときにnullなら、その文字に対応する変換方法が表に登録されていないという意味です。その場合に限り、用途ごとのencode(c)で変換します。
関連キーワード: サニタイズ、変換表、文字コード、実体参照、エスケープ処理

設問2:
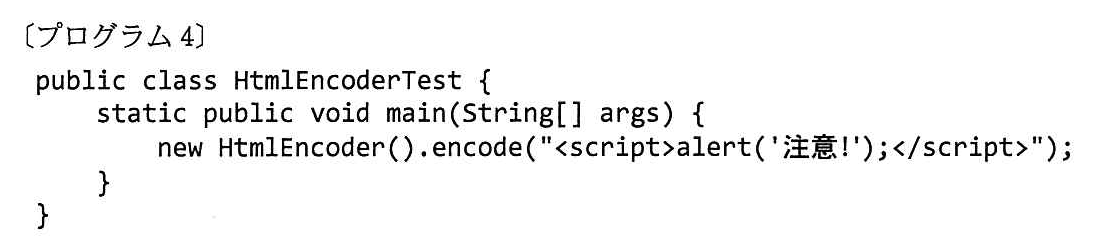
問題文を見る プログラム4を実行したときに、プログラム2のメソッドencodeが呼び出される回数として正しい答えを、解答群の中から選べ。
ここで、プログラム1〜3中のには正しい答えが入っているものとする。
解答群
ア:0
イ:4
ウ:5
エ:13
オ:30
模範解答
ウ
解説
解答の導き方
問われているのは、プログラム4の実行中に、プログラム2の encode(char c) が何回呼び出されるかです。HTML(HyperText Markup Language:Webページの構造を記述する言語)に埋め込む文字列を処理するため、対象は HtmlEncoder です。
プログラム1の encode(String s) は、文字列を1文字ずつ調べます。文字に対応する変換結果が登録されていれば、その結果を使います。変換結果が見つからない場合だけ、encode(c) を呼び出します。つまり、入力された文字数を数えるのではなく、変換表に登録されていない文字を数えます。
HtmlEncoder の変換表には、英数字や指定された記号が「そのまま出力する文字」として登録されています。また、「<」「>」「&」「"」は実体参照(HTMLで特殊な記号を文字として表示するための表記)に変換する文字として登録されています。
プログラム4の入力を順に確認します。
「'」は2回、「注」と「意」は合わせて2回、「/」は1回です。したがって、プログラム2の encode(char c) が呼び出される回数は、 回です。
誤りやすいポイント
- 入力された文字列全体の文字数を数えるのではありません。変換表に登録されていない文字だけが encode(char c) に渡されます。
- encode(String s) と encode(char c) は、引数の型が異なる別のメソッドです。文字列を処理する encode(String s) が呼び出されても、それだけでプログラム2の encode(char c) の呼出し回数にはなりません。
- 英字や「!」「(」「)」「;」は、そのまま出力する文字として登録されています。一方、「'」や「/」は登録されていないため、呼出し回数に含めます。
- 「<」や「>」は変換されますが、変換表に変換結果があるので、プログラム2のメソッドは呼び出されません。
FAQ
Q: 「<」や「>」も変換されるのに、呼出し回数に含まれないのはなぜですか?
A: 変換表に実体参照への変換結果が登録されているためです。変換表に結果がない文字だけが encode(char c) に渡されます。
A: 変換表に実体参照への変換結果が登録されているためです。変換表に結果がない文字だけが encode(char c) に渡されます。
Q: 「'」と「/」は、なぜ呼出し対象になるのですか?
A: どちらも、そのまま出力する文字としての登録も、実体参照に変換する文字としての登録もありません。そのため、変換表から結果を取得できず、encode(char c) が呼び出されます。
A: どちらも、そのまま出力する文字としての登録も、実体参照に変換する文字としての登録もありません。そのため、変換表から結果を取得できず、encode(char c) が呼び出されます。
Q: JavaScriptEncoderの場合も、同じ文字で同じ回数になりますか?
A: いいえ。この設問では HtmlEncoder を使っています。どの文字をそのまま出力するか、どの文字を変換するかは、埋め込む場所に応じて異なります。
A: いいえ。この設問では HtmlEncoder を使っています。どの文字をそのまま出力するか、どの文字を変換するかは、埋め込む場所に応じて異なります。
関連キーワード: サニタイズ、HTML実体参照、文字コード、ハッシュマップ

