
基本情報技術者 2016年 春期 午後 問12
次のアセンブラプログラムの説明及びプログラムを読んで、設問1〜4に答えよ。
〔プログラムの説明〕
10,000m競走に、1チーム8名で、9チーム72名が参加し、各チームの合計タイムを競う。プログラムRACEは、個人別のタイムを所属するチーム番号とともに入力し、チーム別合計タイムを求め、チーム別合計タイムの昇順に、チーム番号とそのチームの1名当たりの平均タイムを出力する。
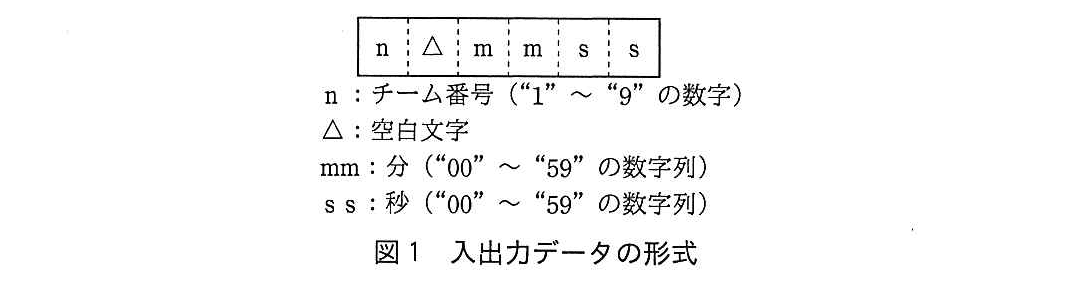
(1) 個人ごとの入力データ及びチームごとの出力データの形式は図1のとおりとする。ここで、60分以上のデータはないものとする。
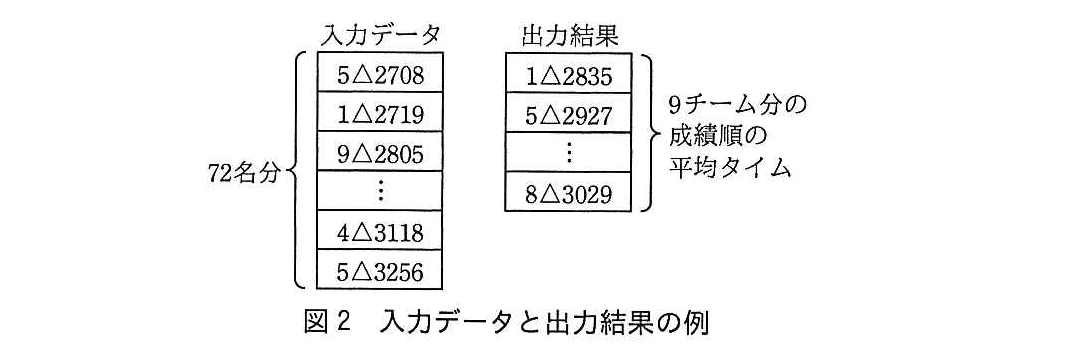
(2) プログラムRACEの入力データと出力結果の例を図2に示す。
(3) データの入力処理と出力処理は、それぞれ副プログラムINPUTとOUTPUTを呼び出して行う。
(4) 副プログラムINPUTは、呼ばれるごとに図1に示す形式の個人のデータを1件読み込む。読み込んだデータのチーム番号及び秒数に変換したタイムを2進数で、それぞれGR1とGR2に設定し、GR0には正の値を設定して、呼出し元に返す。全員のデータを読み終わっている場合は、GR0に−1を設定して呼出し元に返す。
(5) 副プログラムOUTPUTは、GR1とGR2のそれぞれに2進数で設定されたチーム番号と平均タイム(1秒未満を切り捨てた秒数)を、図1に示す形式に変換して書き出す。
設問1:
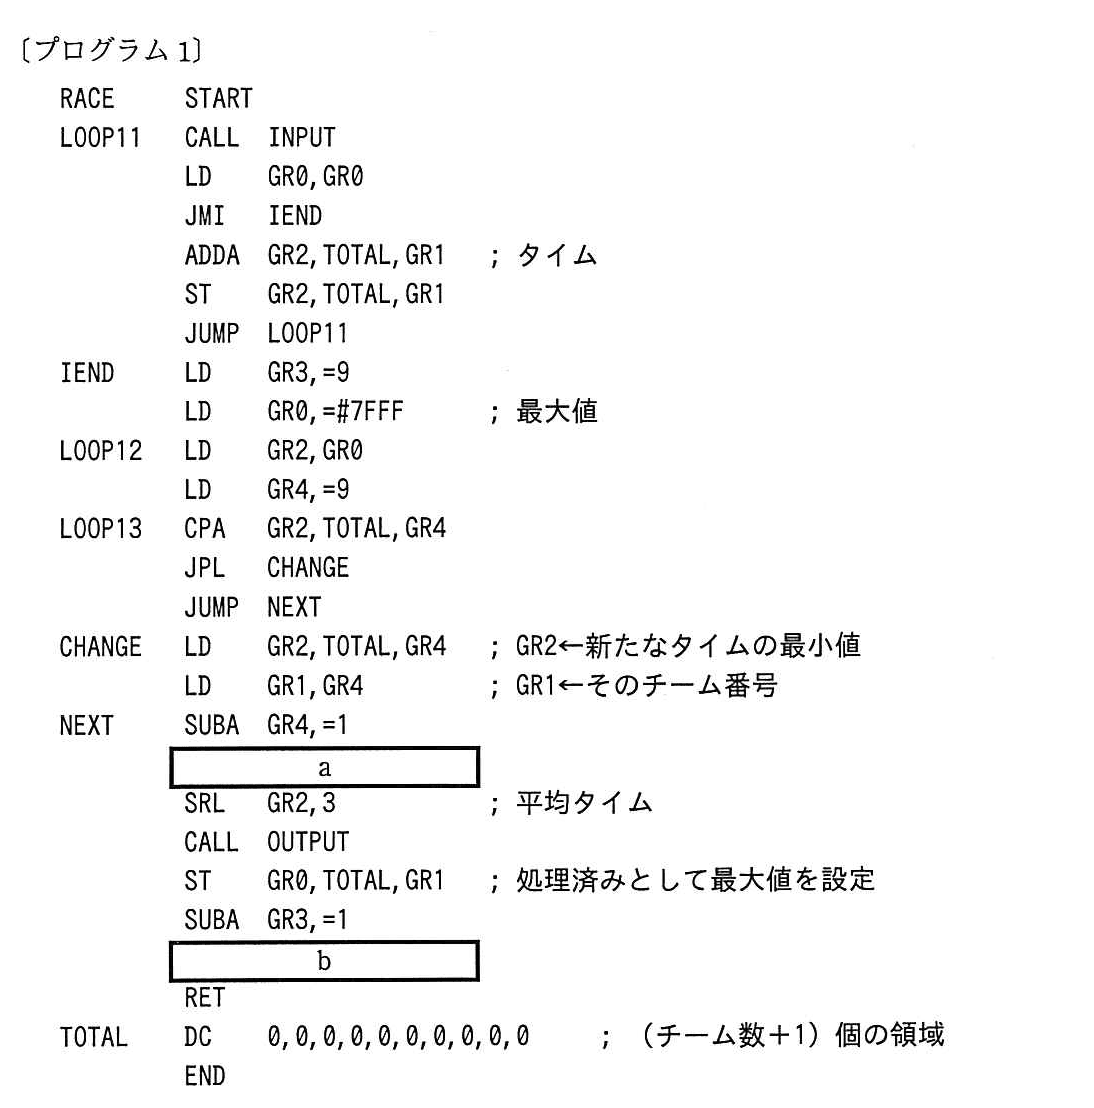
問題文を見る プログラム1中のに入れる正しい答えを、解答群の中から選べ。
解答群
ア:JMI LOOP12
イ:JMI LOOP13
ウ:JPL LOOP12
エ:JPL LOOP13
オ:JUMP LOOP12
カ:JUMP LOOP13
キ:JZE LOOP12
ク:JZE LOOP13
模範解答
a:エ、b:ウ
解説
解答の導き方
このプログラムは、まずチーム別の合計タイムを求めます。その後、まだ出力していないチームの中から合計タイムが最も小さいチームを探し、平均タイムを出力します。
1. aは、チーム番号を順に調べるための分岐です
チーム別合計タイムは、配列TOTALにチーム番号を添字として格納されています。図1のチーム番号は「1」~「9」なので、調べる添字も9から1までです。添字0はチーム番号ではありません。
LOOP13では、現在の候補タイムGR2と、TOTALのGR4番目の値を比較しています。GR2のほうが大きければ、そのチームの合計タイムのほうが小さいので、CHANGEで候補を更新します。
NEXTでは、GR4を1減らします。その後も調べる添字が残っている間だけLOOP13に戻る必要があります。
- 添字9を調べた後、GR4は8になります。8は正なので、次の添字を調べます。
- この処理を続け、添字1を調べた後、GR4は0になります。0は正ではないので、ここでLOOP13には戻らず、チームの探索を終えます。
したがって、aには「正の値ならLOOP13に戻る」という分岐が入ります。JPLは正の値のときに分岐する命令なので、aはJPL LOOP13です。
2. bは、残りのチームがある間、最小タイムを探し直すための分岐です
最小タイムのチームを出力した後、次の処理でそのチームを「処理済み」にします。
ST GR0,TOTAL,GR1
このときGR0には#7FFFが設定されています。実際のチーム合計タイムは、1人当たり60分未満で、1チーム8名分なので、#7FFFより小さい値です。そのため、処理済みのチームを#7FFFに置き換えると、次の探索でそのチームが最小候補に選ばれなくなります。
次にGR3を1減らします。GR3は残りのチーム数を表しており、最初は9です。GR3が正ならまだチームが残っているので、LOOP12に戻って次の最小タイムを探します。最後のチームを出力するとGR3は0になるため、LOOP12には戻らずRETに進みます。
よって、bにも正の値のときに分岐する命令が入り、分岐先はLOOP12です。したがってbはJPL LOOP12です。
誤りやすいポイント
- JPLは、値が0のときには分岐しません。aでは、GR4が0になった時点で探索を終える必要があります。
- aの分岐先はLOOP12ではなくLOOP13です。LOOP13はチームを1つずつ比較する場所で、LOOP12は次のチームを選ぶための探索全体を始める場所です。
- bでは、GR3を減らした後に残りのチーム数を判定します。GR3が0になった後も繰り返すと、必要なチーム数を超えて処理してしまいます。
- SRL GR2,3はGR2を右に3ビットずらす処理です。正の整数を8で割った値になり、余りは切り捨てられるため、8名分の合計タイムから1名当たりの平均タイムを求められます。
FAQ
Q: なぜ、処理済みのチームの合計タイムを#7FFFに置き換えるのですか?
A: 次の探索で、処理済みのチームが再び最小のチームとして選ばれないようにするためです。#7FFFは有効なチーム合計タイムより大きい値として使われています。
A: 次の探索で、処理済みのチームが再び最小のチームとして選ばれないようにするためです。#7FFFは有効なチーム合計タイムより大きい値として使われています。
Q: JZE LOOP13ではいけないのですか?
A: JZEは値が0のときに分岐する命令です。添字9を調べた直後のGR4は8なので、JZE LOOP13では次のチームを調べる処理に進めません。
A: JZEは値が0のときに分岐する命令です。添字9を調べた直後のGR4は8なので、JZE LOOP13では次のチームを調べる処理に進めません。
Q: チーム別の順位は、どのように決めていますか?
A: まだ処理していないチームの中から合計タイムが最小のものを探して出力し、そのチームを処理済みにします。この探索を繰り返すことで、合計タイムの昇順に出力します。
A: まだ処理していないチームの中から合計タイムが最小のものを探して出力し、そのチームを処理済みにします。この探索を繰り返すことで、合計タイムの昇順に出力します。
関連キーワード: アセンブリ言語、条件分岐、比較命令、配列、最小値探索、選択ソート

設問2:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
同じ合計タイムのチームが複数ある場合、c。
解答群
ア:チーム番号の昇順に出力される
イ:チーム番号の降順に出力される
ウ:どのチームが先に出力されるかは時々で異なる
模範解答
c:イ
解説
解答の導き方
チームの合計タイムが同じとき、出力順を決めるには、プログラムがチームをどの順番で調べ、同じタイムを見つけたときに候補をどう扱うかを確認します。
まず、個人のタイムは所属チームごとに合計されます。合計タイムを保存する領域は、チーム番号で位置を指定する「TOTAL」です。このように、番号で場所を指定して値を保存する領域を配列といいます。
次に、プログラムは合計タイムが最も小さいチームを探します。候補の合計タイムをGR2に置き、GR4を9から1へ減らしながら、チームを順番に調べます。GR1からGR4は、計算中の値を一時的に置くレジスタです。
調べるときの命令は、CPA GR2,TOTAL,GR4です。現在の候補であるGR2と、GR4で指定したチームの合計タイムを比べています。その後のJPL CHANGEは、GR2のほうが大きい場合にCHANGEへ進む命令です。つまり、調べたチームのタイムのほうが小さければ、新しい候補にします。
ここで重要なのは、2つのタイムが同じ場合です。GR2のほうが大きいわけではないため、JPL CHANGEは実行されません。新しい候補に置き換わらず、先に見つけたチームが候補として残ります。
チームは番号の大きい9から小さい1へ調べられます。そのため、合計タイムが同じチームが複数あれば、先に見つかるのは番号の大きいチームです。後から番号の小さいチームを調べても、タイムが同じなら候補は置き換わりません。したがって、同じ合計タイムのチームは、番号の大きい順に出力されます。
出力したチームの合計タイムは、GR0に設定した最大値で置き換えられます。これは、そのチームを次の探索で再び選ばないための目印です。このように、すでに処理したデータを特別な値で示す方法を番兵値といいます。
誤りやすいポイント
- 合計タイムの昇順で出力することだけを見て、同じタイムの場合も番号の昇順になると思い込まないようにします。同じタイムの順序は、チームを調べる順序にも左右されます。
- JPL CHANGEは、比較した値が同じ場合には実行されません。ここで候補が置き換わらないことが、出力順を決めるポイントです。
- チームの番号は9から1へ減っていきます。番号の小さいチームから調べているのではありません。
- 出力済みのチームには最大値が設定されます。これは合計タイムとして採用する値ではなく、次の探索で再選択させないための目印です。
FAQ
Q: 入力データに書かれた順番は、同じタイムの出力順に影響しますか?
A: 影響しません。チームごとに合計タイムを保存した後、チーム番号の大きい順に調べて候補を決めるためです。
A: 影響しません。チームごとに合計タイムを保存した後、チーム番号の大きい順に調べて候補を決めるためです。
Q: なぜ、すでに出力したチームの合計タイムを最大値に置き換えるのですか?
A: 次に最小の合計タイムを探すとき、出力済みのチームが候補に選ばれないようにするためです。
A: 次に最小の合計タイムを探すとき、出力済みのチームが候補に選ばれないようにするためです。
Q: SRL GR2,3は何をしていますか?
A: SRL(Shift Right Logical:ビットを右にずらす命令)でGR2を3ビット右にずらしています。8名の平均タイムを求めるため、合計タイムを、つまり8で割っています。
A: SRL(Shift Right Logical:ビットを右にずらす命令)でGR2を3ビット右にずらしています。8名の平均タイムを求めるため、合計タイムを、つまり8で割っています。
関連キーワード: 配列、線形探索、比較演算、番兵値、論理シフト
設問3:
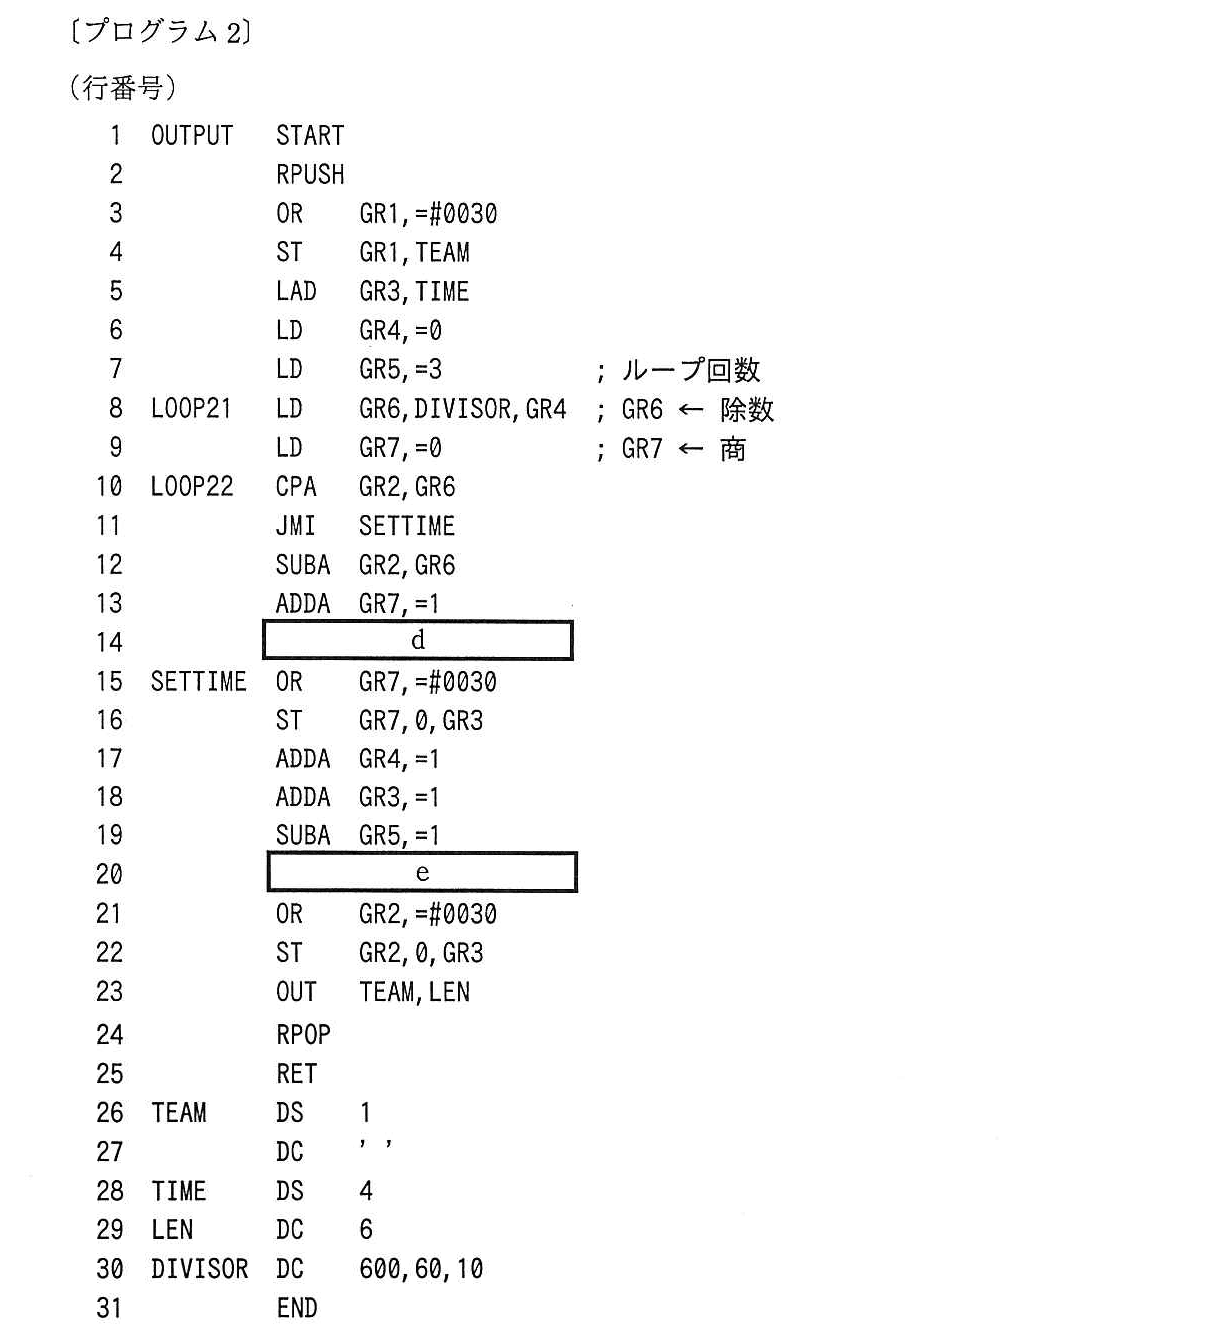
問題文を見る 副プログラムOUTPUTを次に示す。プログラム2中のに入れる正しい答えを、解答群の中から選べ。
dに関する解答群
ア:JMI LOOP21
イ:JMI LOOP22
ウ:JPL LOOP21
エ:JUMP LOOP21
オ:JUMP LOOP22
カ:JZE LOOP22
eに関する解答群
ア:JMI LOOP21
イ:JPL LOOP21
ウ:JPL LOOP22
エ:JUMP LOOP22
オ:JZE LOOP21
カ:JZE LOOP22
模範解答
d:オ、e:イ
解説
解答の導き方
OUTPUTは、GR2に入っている平均タイムを、分と秒を表す4桁にして出力します。空欄dは「同じ桁の計算を続ける処理」、空欄eは「次の桁の計算に進む処理」です。
まず、GR1やGR2のようなGRは、計算中の値を一時的に入れておくレジスタです。また、CPAは値を比べる命令で、その結果は「正・0・負」のどれかとして記録されます。JMIは結果が負のとき、JPLは正のときに分岐します。JUMPは条件に関係なく分岐します。
-
LOOP22は、同じ桁の商を求めるループです。LOOP21では、GR6に除数を設定し、GR7を0にします。GR6の値は、順に600、60、10です。つまり、計算する桁ごとに除数を切り替えます。LOOP22では、GR2とGR6を比べます。GR2がGR6以上なら、GR2からGR6を引き、GR7を1増やします。この引き算を繰り返すことで、何回引けたかをGR7に数えます。反対に、GR2がGR6より小さくなると、CPAの結果が負になります。その場合、既にあるJMI SETTIMEによって、同じ桁の計算を終えます。したがって、引き算と商の加算をした後は、もう一度CPAで比較する必要があります。dには無条件でLOOP22に戻るJUMP LOOP22が入ります。解答群ではオです。
-
除数を切り替える回数は、GR5で管理します。GR5は最初に3に設定されています。600、60、10の3種類の除数を使って、タイムの上位3桁を順番に求めるためです。1桁分の計算が終わると、GR5を1減らし、GR4も1増やします。GR4が次の除数を選ぶ位置になり、GR5は残りの桁数を表します。GR5が正の間は、LOOP21に戻って次の除数を読み込み、GR7を0にして次の桁を求めます。そのため、eには「GR5が正ならLOOP21に戻る」JPL LOOP21が入ります。解答群ではイです。3回目の計算後はGR5が0になるため、分岐せず、残ったGR2を最後の1桁として出力します。
-
数値を4桁にする処理を例で確認します。例えば、平均タイムが1715秒なら、次のように計算します。600で2回引くと、です。次に60で8回引くと35になり、10で3回引くと5が残ります。GR7から得た2、8、3と、最後に残った5を並べると2835です。これは28分35秒を表します。つまり、LOOP22は同じ桁の数字を数えるために繰り返し、LOOP21は次の桁へ進むために繰り返します。
誤りやすいポイント
- dとeは、どちらもループへの分岐ですが、戻る先が違います。dは同じ除数で引き算を続けるためLOOP22へ戻り、eは次の除数を読み込むためLOOP21へ戻ります。
- dの直前ではGR2から除数を引き、GR7を増やしたところです。次の引き算が可能かを調べるため、条件を決めつけずにCPAへ戻る必要があります。
- eの直前ではGR5を1減らしています。残り回数が正のときだけ次の桁へ進むため、JPLを使います。JZEでは、GR5が0になった最後の回にも分岐してしまいます。
- LOOP22は除算命令そのものではありません。引き算を繰り返し、引けた回数を商として数える処理です。
FAQ
-
Q: なぜGR2がGR6より小さくなったらSETTIMEへ進むのですか?
A: その桁の除数をもう引けないためです。GR7に数えた回数がその桁の値になり、残ったGR2は次の桁の計算に使われます。 -
Q: なぜ除数が600、60、10なのですか?
A: 出力するタイムは分・秒の4桁です。600秒は10分の位、60秒は分の1の位、10秒は秒の10の位を求めるために使います。最後に残った値が秒の1の位です。 -
Q: OR GR7, =#0030は何のためですか?
A: GR7にある数字の値を、出力できる数字の文字に変えるためです。最後のGR2にも同様の処理をしてから、TIMEに格納します。
関連キーワード: 比較命令、条件分岐、反復処理、除算、文字コード
設問4:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
出力されたデータが次のとき、プログラム2の行番号12のSUBA命令はf回実行された。
 解答群
ア:9
イ:17
ウ:20
エ:270
オ:299
解答群
ア:9
イ:17
ウ:20
エ:270
オ:299模範解答
f:ア
解説
解答の導き方
出力データの「7△2708」は、チーム番号が7、平均タイムが27分08秒という意味です。プログラム2では、秒数を出力形式の「分・秒」に直すとき、各桁に対応する秒数を繰り返し引き、その回数を桁の値にします。
まず、27分08秒を秒数に直します。
この1628秒から、出力する各桁に合わせて秒数を引いていきます。
600秒を2回引くと、分の十の位は2です。残った428秒から60秒を7回引くと、分の一の位は7で、残りは8秒です。8秒から10秒は引けないため、秒の十の位は0となり、残った8秒が秒の一の位になります。
行番号12のSUBA命令は、これらの繰り返し減算で実行されます。実行回数は、2回、7回、0回を合計して、回です。
誤りやすいポイント
- 「7」はチーム番号です。時間の変換で行う減算回数には含めません。
- 「2708」をそのまま秒数と考えないようにします。これは27分08秒を表す出力形式です。
- 秒の一の位の8を得るために、1秒を8回引くわけではありません。8秒は残りの値としてそのまま使います。
FAQ
Q: なぜ600秒を引くのですか?
A: 600秒は10分です。繰り返し引いた回数が、出力する分の十の位になります。
A: 600秒は10分です。繰り返し引いた回数が、出力する分の十の位になります。
Q: 秒の十の位が0のときも、SUBA命令を実行しますか?
A: 10秒を引ける回数が0回なので、この桁のためのSUBA命令は実行されません。
A: 10秒を引ける回数が0回なので、この桁のためのSUBA命令は実行されません。
Q: 残った8秒はどのように出力しますか?
A: 8秒は秒の一の位として使います。1秒ずつ引いて数える必要はありません。
A: 8秒は秒の一の位として使います。1秒ずつ引いて数える必要はありません。
関連キーワード: 繰返し処理、減算、秒換算、時間形式、数値変換

