
基本情報技術者 2019年 秋期 午後 問09
次のCプログラムの説明及びプログラムを読んで、設問1,2に答えよ。
入力ファイルの内容を、文字及び16進数で表示するプログラムである。
〔プログラムの説明〕
(1) 関数dumpの引数の仕様は、次のとおりである。
char *filename 入力ファイルのファイル名
long from 表示を開始するバイト位置
long to 表示を終了するバイト位置(値が負の場合はファイルの末尾)
ここで、バイト位置は、ファイルの先頭のバイトから順に0, 1, …と数える。
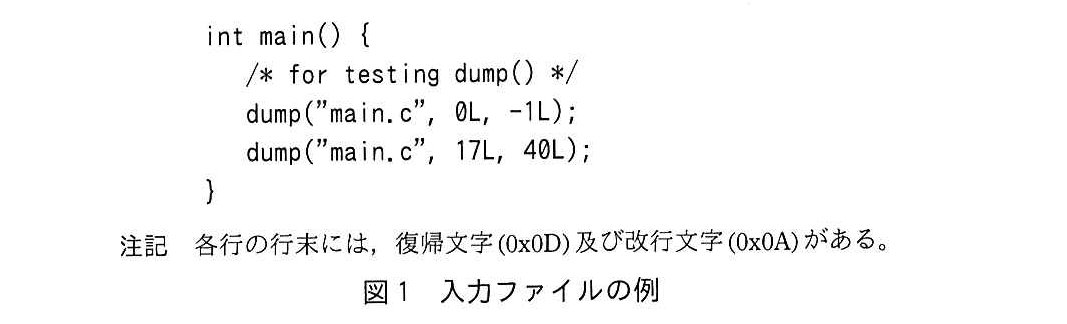
(2) 入力ファイルは、バイナリファイルとして読み込む。入力ファイル中の各バイトの内容(ビット構成)に制約はない。図1に、入力ファイルの例を示す。
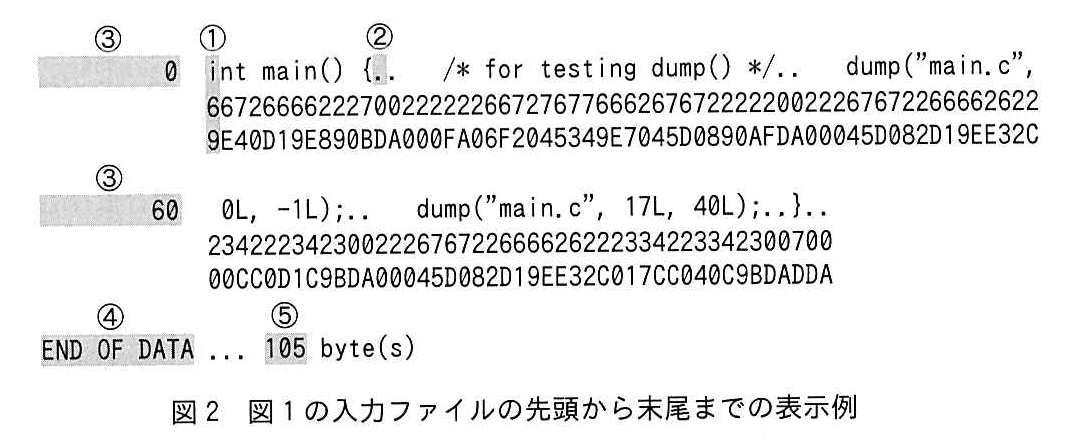
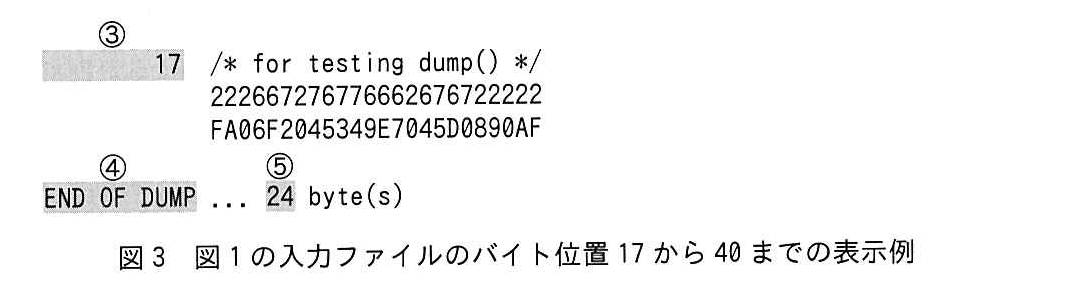
(3) 入力ファイル中の各バイトの内容を、文字及び16進数で表示する。図2は図1の入力ファイルの先頭から末尾までの表示例であり、図3は同じファイルのバイト位置17から40までの表示例である。
(4) 表示の様式を、次に示す。説明中の①、②、・・・は、図中の網掛け部分を指している。
・入力ファイルのバイト位置fromから60バイトずつを、3行1組で表示する。
・各組の1行目に各バイトが表す文字を、2行目に各バイトの16進数表示の上位桁を、3行目に同下位桁を、それぞれ表示する。例えば、①のバイトは、文字表示が“i”で、その16進数表示が69である。
・バイトの内容が16進数表示で20~7E以外の場合は、そのバイトが表す文字として、②のように“.”を表示する。
・各組の1行目の行頭に、その組に表示する最初のバイトのバイト位置を10進数で③の形式で表示する。
・入力ファイルの内容の表示が終わった後、最終行の④の位置には、入力ファイルの終わりに達して終了した場合は“END OF DATA”を、表示を終了するバイト位置に達して終了した場合は“END OF DUMP”を表示する。⑤の位置には、表示した入力ファイルの内容のバイト数を10進数で表示する。
(5) 入力ファイルのファイルサイズ(バイト数)及び引数from, toの値は、次の式を満たすものとする。
to < 0の場合:to < 0 ≦ from <ファイルサイズ<
to ≧ 0の場合:0 ≦ from ≦ to <ファイルサイズ<
(6) プログラム中で使用している関数fgetc(s)は、ストリームsから1文字を読み込んで返す。ファイルの終わりに達しているときは、EOFを返す。
設問1:
問題文を見る プログラム中のに入れる正しい答えを、解答群の中から選べ。ここで、b1とb2に入れる答えは、bに関する解答群の中から組合せとして正しいものを選ぶものとする。
aに関する解答群
ア:chr & 0x0F
イ:chr & 0xF0
ウ:chr && 0x0F
エ:chr && 0xF0
bに関する解答群
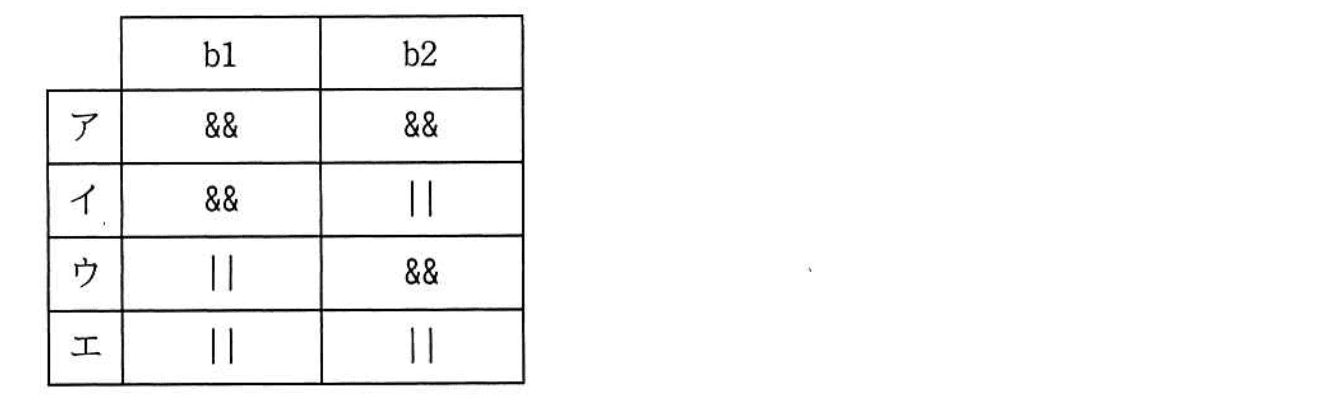
cに関する解答群
ア:cnt > from
イ:cnt >= from
ウ:cnt >= from - 1
dに関する解答群
ア:cnt == WIDTH - 1
イ:cnt == WIDTH
ウ:cnt == WIDTH + 1
エ:pos == WIDTH - 1
オ:pos == WIDTH
カ:pos == WIDTH + 1
模範解答
a:ア、b:イ、c:ア、d:オ
解説
解答の導き方
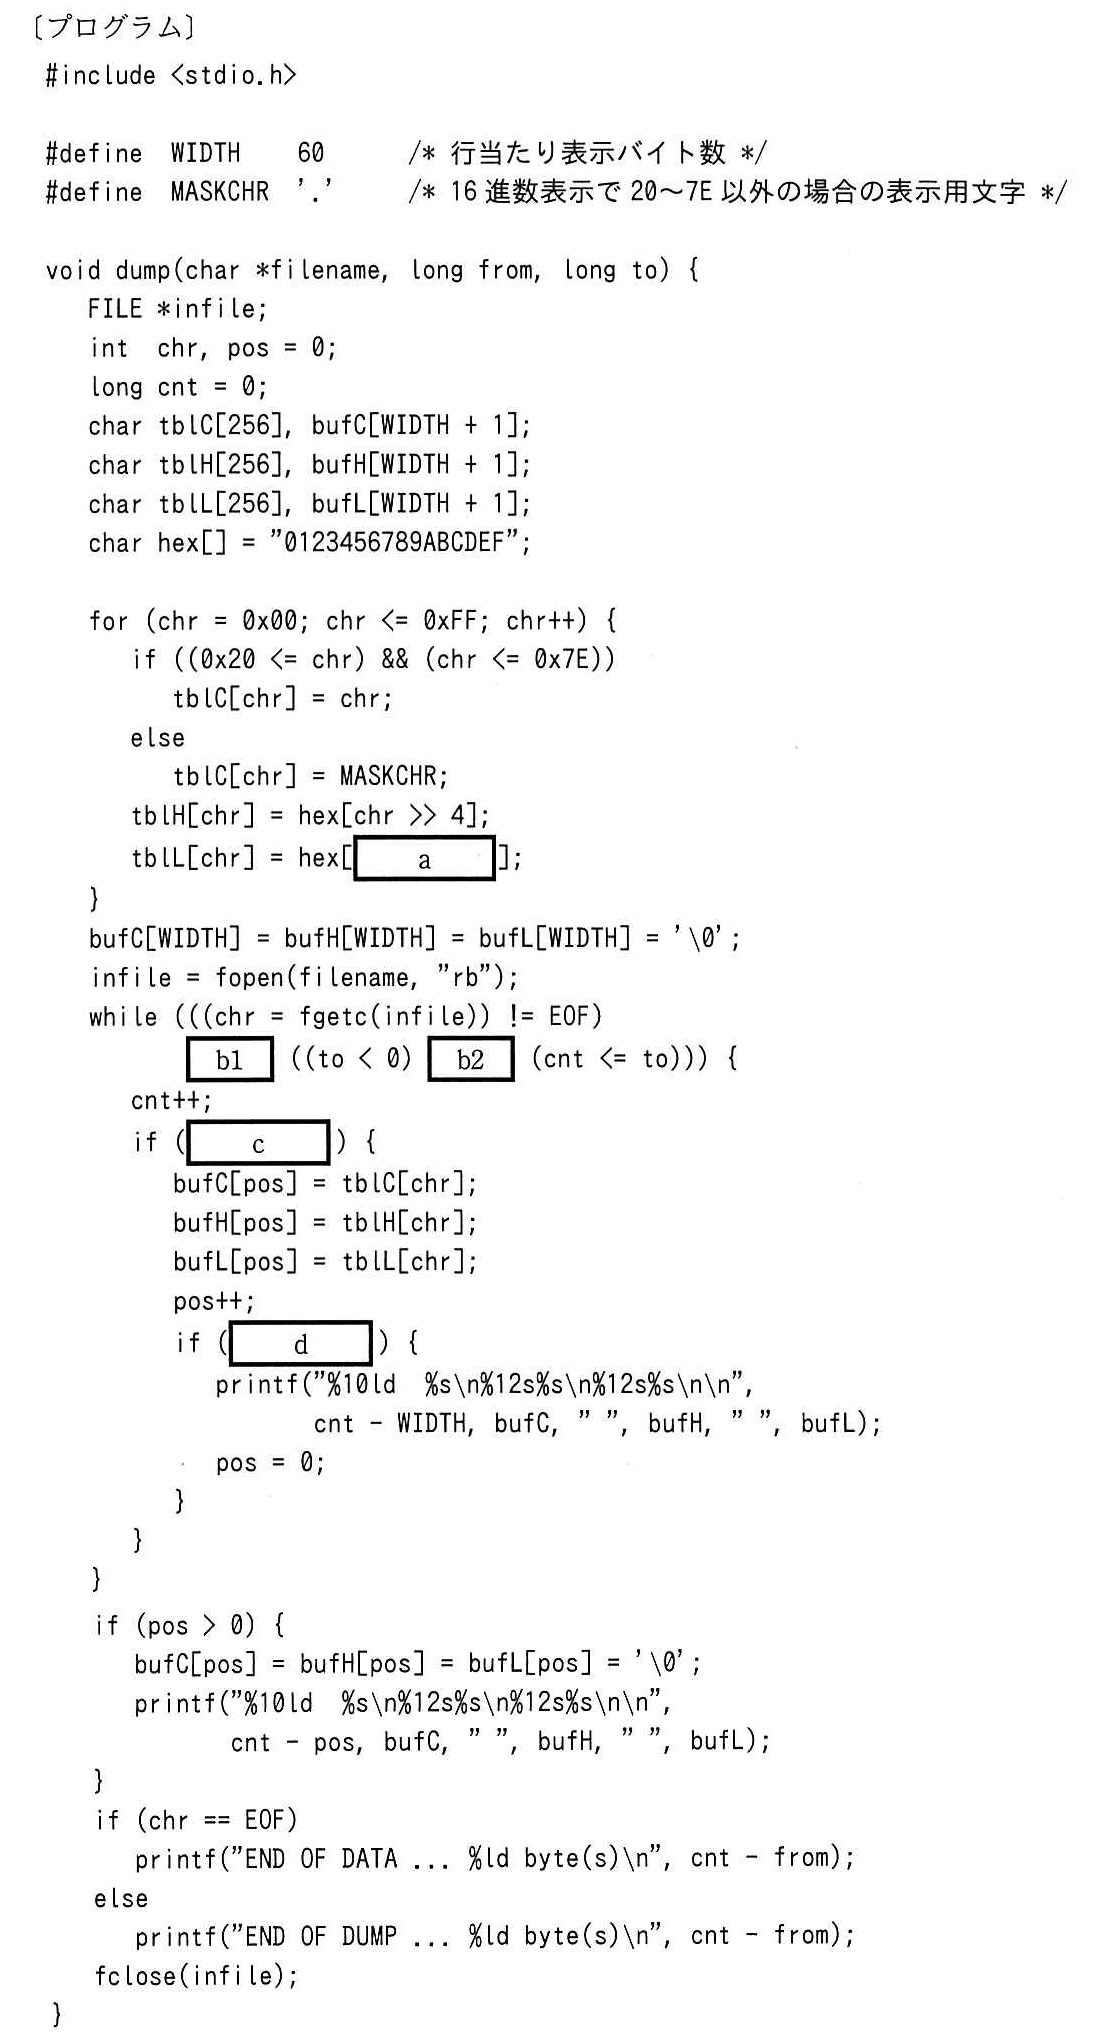
このプログラムでは、ファイルを1バイトずつ読み込み、文字表示と16進数表示を作ります。空欄は、16進数の下位桁を取り出す方法、読み込みを続ける条件、表示範囲の判定、60バイト分の表示タイミングを考えると決められます。
-
a:16進数の下位桁を取り出します16進数は、1バイトを上位の桁と下位の桁に分けて表示します。プログラムでは、上位の桁を「chr >> 4」で取り出しています。下位の桁を取り出すには、chrの下位4ビットだけを残します。そのために使うのが「chr & 0x0F」です。&は、対応するビットが両方とも1のときだけ1にする演算です。一方、「&&」は、値が0かどうかを判定する論理演算子です。chr && 0x0Fでは下位4ビットを取り出せません。したがって、aには「chr & 0x0F」となるアが入ります。
-
b:ファイルの終わりと表示範囲を判定しますfgetcは、読み込んだ1バイトを返します。読み込むデータがなくなると、EOF(End Of File:ファイルの終わりを示す値)を返します。まず、読み込んだ値がEOFではないことを確認します。EOFでなければ、さらに表示範囲の条件を確認します。この2つは両方とも満たす必要があるので、b1には論理積の「&&」が入ります。次に、表示終了位置toの条件を考えます。問題文では「値が負の場合はファイルの末尾」とあります。つまり、toが負なら上限を設けず、toが0以上ならcntがto以下の間だけ読み込みます。この条件は、次のように表せます。「to < 0」または「cnt <= to」どちらか一方を満たせばよいので、b2には論理和の「||」が入ります。よって、bはイです。b1が「||」だと、chrがEOFでも後半の条件が真なら読み込み処理を続けてしまうおそれがあります。ファイルの終わりを正しく扱うため、b1は「&&」でなければなりません。
-
c:表示を始めるバイト位置を判定しますcntは、ループ内でバイトを読み込んだ後に1増えます。そのため、バイト位置がfromのデータを読み込んだ時点では、cntはfromより1大きくなっています。例えばfromが17の場合は、次のようになります。位置16のバイトは表示せず、位置17のバイトから表示するには、「cnt > from」で判定します。したがって、cにはアが入ります。
-
d:60バイト分をためたら表示しますposは、表示用の配列にためたバイト数です。バイトを配列に入れるたびにposが1増えます。配列には「WIDTH + 1」個の要素があり、表示する60バイトに加えて、文字列の終わりを示す値を置く場所があります。60バイトをためた時点でposはWIDTHと等しくなるので、そのときに表示します。したがって、dには「pos == WIDTH」となるオが入ります。posがWIDTH - 1のときはまだ1バイト足りず、WIDTH + 1になってからでは遅すぎます。
誤りやすいポイント
- aでは、&と&&を混同しないようにします。&はビットを取り出すために使い、&&は条件を論理的に結び付けるために使います。
- bの条件では、「EOFではないこと」と「表示範囲内であること」の両方が必要です。そのため、b1は「&&」です。一方、toが負の場合とcntがto以下の場合はどちらかを満たせばよいので、b2は「||」です。
- cntはバイト位置そのものではなく、ループ内で読み込みを数えた値です。読み込み後にcntが増えるため、fromのバイトを表示する条件はcnt > fromになります。
- 1行に表示するバイト数を数えているのはposです。cntはファイル全体の読み込み数、posは現在の表示グループにためた数として区別します。
FAQ
Q: 表示終了位置toのバイトも表示されますか?
A: 表示されます。toが0以上の場合、toの位置のバイトを読み込む前のcntはtoです。そのため「cnt <= to」の条件を満たし、そのバイトは表示対象になります。図3のように、位置17から40までなら、40 - 17 + 1で24バイトです。
Q: 表示バイト数をcnt - fromで求められるのはなぜですか?
A: cntは、表示した最後のバイト位置より1大きい値になります。図3の位置17から40までなら、表示後のcntは41となり、41 - 17で24バイトです。
Q: fgetcの戻り値を受け取るchrがint型なのはなぜですか?
A: 1バイトの値だけでなく、ファイルの終わりを示すEOFも区別して扱う必要があるためです。EOFを0~255のバイト値と区別できる型で受け取ります。
関連キーワード: バイト位置、16進数、ビットマスク、論理演算子、配列、EOF

設問2:
問題文を見る 関数dumpの動作に関する次の記述中のに入れる正しい答えを、解答群の中から選べ。
表示結果の最終行(表示が1行だけの場合はその行)の表示内容について、次の二つのケースを考える。
〔ケース1〕 ファイルサイズ = 100, from = 99, to = 99
この場合、最終行の表示内容は“e”となる。
〔ケース2〕 ファイルサイズ = 0, from = 0, to < 0
この場合、ファイルサイズ及びfromの値がプログラムの説明(5)の条件を満たしていない。このケースについて関数dumpを実行すると、最終行の表示内容は“f”となる。
e, fに関する解答群
ア:END OF DATA ... -1 byte(s)
イ:END OF DUMP ... -1 byte(s)
ウ:END OF DATA ... 0 byte(s)
エ:END OF DUMP ... 0 byte(s)
オ:END OF DATA ... 1 byte(s)
カ:END OF DUMP ... 1 byte(s)
模範解答
e:オ、f:ウ
解説
解答の導き方
この設問では、表示を終えた理由と、表示したバイト数をそれぞれ確認します。
プログラムでは、fgetcでファイルから1バイトずつ読み込みます。EOF(End Of File:ファイルの終わりを示す値)が返った場合は、ファイルの終わりに達したことを表します。
また、cntは読み込んだバイト数を数える変数です。表示を開始する位置より前のバイトも読み込んで数えるため、最後に表示したバイト数を求めるときは、cntからfromを引いています。
ケース1
ファイルサイズが100で、from = 99、to = 99です。バイト位置は0から数えるので、最後のバイトの位置は99です。
プログラムは位置99のバイトを読み込み、表示します。その後、もう一度読み込もうとすると、ファイルの終わりに達してfgetcがEOFを返します。したがって、終了理由は「END OF DATA」です。
読み込んだバイト数はcnt = 100で、表示開始位置はfrom = 99です。表示したバイト数はなので、最終行は「END OF DATA ... 1 byte(s)」となります。よって、eはオです。
ケース2
ファイルサイズが0なので、最初のfgetcですぐにEOFが返ります。読み込み処理の中には入らないため、cntは0のままです。また、表示するバイトがないので、表示したバイト数はです。
終了理由はファイルの終わりに達したことなので、最終行は「END OF DATA ... 0 byte(s)」となります。よって、fはウです。
誤りやすいポイント
- toの値に達した場合は必ず「END OF DUMP」になる、と考えないようにしましょう。ケース1ではto = 99に達した後、次の読み込みでファイルの終わりを検出します。そのため「END OF DATA」になります。
- バイト位置は0から始まります。ファイルサイズが100なら、最後のバイト位置は100ではなく99です。
- cntには、表示開始位置より前に読み込んだバイトも含まれます。表示したバイト数はcntそのものではなく、cntからfromを引いて求めます。
- ケース2は問題文にある通常の条件を満たしませんが、設問ではその条件外での動作を尋ねています。ファイルの終わりに達した時点でのcntとfromを使って判断します。
FAQ
Q: to = 99なのに、ケース1で「END OF DUMP」にならないのはなぜですか?
A: 位置99のバイトを読み込んだ後、次の読み込みでファイルの終わりを検出するからです。ファイルの終わりを検出した場合は「END OF DATA」と表示します。
A: 位置99のバイトを読み込んだ後、次の読み込みでファイルの終わりを検出するからです。ファイルの終わりを検出した場合は「END OF DATA」と表示します。
Q: ケース2では、バイトを表示していないのに「0 byte(s)」と表示されるのはなぜですか?
A: 最初の読み込みでEOFが返り、cntは0のままです。表示バイト数はなので、となります。
A: 最初の読み込みでEOFが返り、cntは0のままです。表示バイト数はなので、となります。
Q: 「END OF DATA」と「END OF DUMP」はどう使い分けますか?
A: ファイルの終わりを読み込んだ場合は「END OF DATA」です。ファイルの終わりより前に、表示終了位置に達した場合は「END OF DUMP」です。
A: ファイルの終わりを読み込んだ場合は「END OF DATA」です。ファイルの終わりより前に、表示終了位置に達した場合は「END OF DUMP」です。
関連キーワード: バイナリファイル、fgetc、EOF、カウンタ、論理演算子

