
基本情報技術者 2019年 春期 午後 問03
定期健康診断のデータが登録されているデータベースに関する次の記述を読んで、設問1〜3に答えよ。
D中学校では、年に1回、定期健康診断を実施し、結果をデータベースに登録している。
身長と体重の測定結果は、身長の単位はcm、体重の単位はkgとして、いずれも0.1刻みで健診結果表に登録している。定期健康診断を受ける生徒の生年月日、性別などの属性情報は、受診者情報表に登録している。
健診結果表を作成するSQL文の一部と、受診者情報表を作成するSQL文を次に示す。
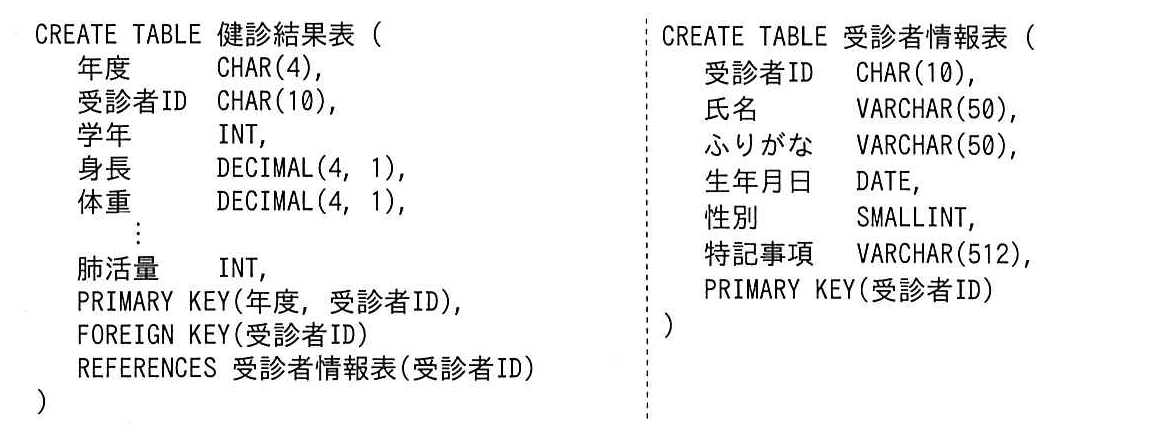
ここで、DECIMAL(x, y)は固定小数点数を扱うデータ型であり、xは精度であって、表示する数字の桁数を示し、yは位取りであって、小数点以下の数字の桁数を示す。例えば、データベースに175.5を登録するには、xに4を、yに1を指定する。
健診結果表及び受診者情報表のデータ(以下、定期健康診断データという)から、身長と体重を統計データとして参照するために、測定結果ビューを使用する。測定結果ビューを作成するSQL文を次に示す。
CREATE VIEW 測定結果ビュー( 年度, 学年, 性別, 生年月日, 身長, 体重 ) AS
SELECT 健診結果表.年度, 健診結果表.学年,
CASE 受診者情報表.性別
WHEN 0 THEN '男'
WHEN 1 THEN '女'
ELSE '−'
END,
受診者情報表.生年月日, 健診結果表.身長, 健診結果表.体重
FROM 健診結果表, 受診者情報表
WHERE 健診結果表.受診者ID = 受診者情報表.受診者ID
設問1:
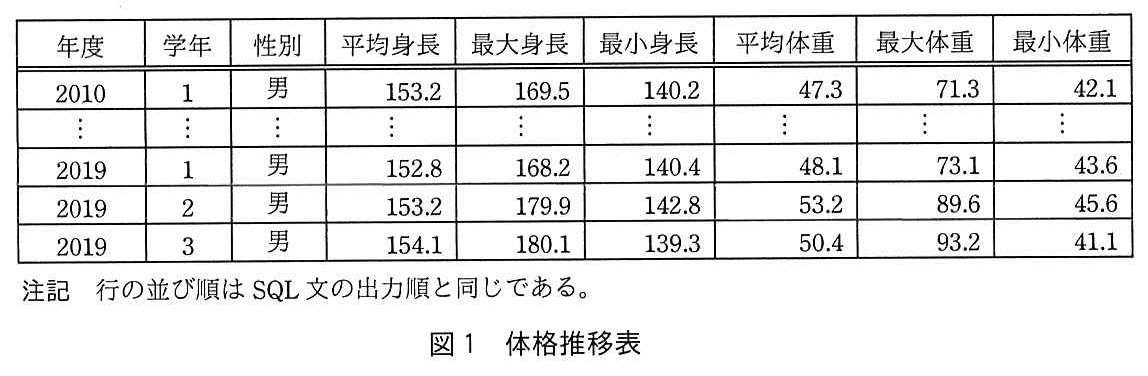
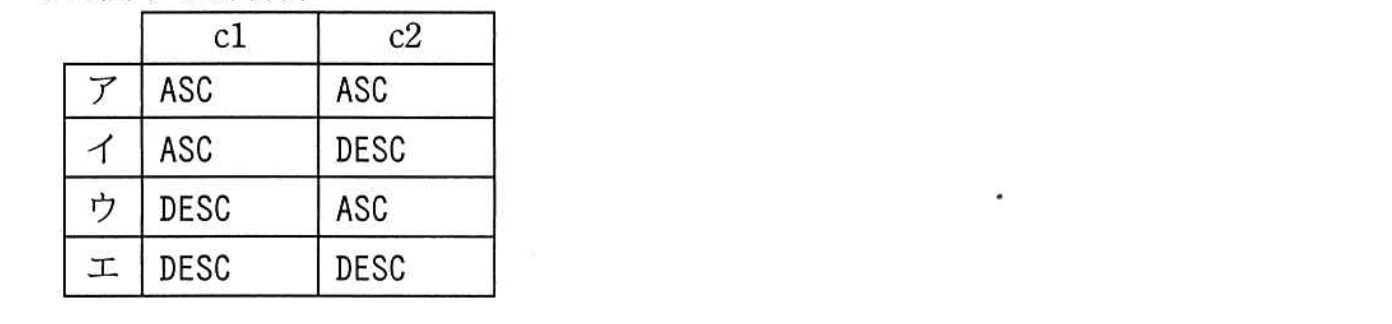
問題文を見る 2010年度から2019年度までの定期健康診断データを基に、男子生徒の体格の推移を見る。次のSQL文の実行結果を用いて、図1に示す体格推移表を作成した。平均身長と平均体重は小数第2位を四捨五入した値である。SQL文のに入れる正しい答えを、解答群の中から選べ。ここで、c1とc2に入れる答えは、cに関する解答群の中から組合せとして正しいものを選ぶものとする。
SELECT 年度, 学年, 性別,
AVG(身長) AS 平均身長, MAX(身長) AS 最大身長, MIN(身長) AS 最小身長,
AVG(体重) AS 平均体重, MAX(体重) AS 最大体重, MIN(体重) AS 最小体重
FROM 測定結果ビュー WHERE 年度 a AND 性別 = b
GROUP BY 年度, 学年, 性別
ORDER BY 年度 c1, 学年 c2
aに関する解答群
ア:LIKE '201_'
イ:LIKE '2010'
ウ:LIKE '2019'
エ:= '201%'
オ:= '201_'
カ:= '201*'
bに関する解答群
ア:0
イ:1
ウ:'男'
エ:'女'
オ:'−'
cに関する解答群
模範解答
a:ア、b:ウ、c:ア
解説
解答の導き方
このSQL文では、年度と性別で対象を絞り、年度・学年・性別ごとに身長と体重の統計値を求めています。SQL(Structured Query Language:データベースに問い合わせたり、データを操作したりするための言語)の条件指定と並べ替えを順に確認します。
まず、年度の条件です。問題文では対象が「2010年度から2019年度まで」とされています。年度はCHAR(4)型なので、4文字の文字列として扱われます。
LIKEは、文字列の一部をパターンで指定するときに使います。パターン中の「」は任意の1文字を表します。そのため、LIKE '201' は「201」の後に1文字が続く年度に一致します。この条件で2010年度から2019年度までを指定できるため、aはアです。
一方、LIKE '2010'やLIKE '2019'は、それぞれ特定の年度だけに一致します。また、「%」はLIKEと組み合わせて使う記号です。= '201%'のように書いても、「%」は任意の文字を表す記号としては働きません。
次に、性別の条件です。測定結果ビューでは、受診者情報表の性別の値をCASE式で文字に変換しています。性別が0なら「男」、1なら「女」となるため、ビューの性別を条件にするときは数値の0ではなく、文字列の「男」を指定します。文字列はSQLではシングルクォーテーションで囲むので、性別 = '男'となり、bはウです。
最後に、並べ替えです。図1では年度が2010から2019へ進み、同じ年度の学年も1、2、3の順に並んでいます。したがって、年度も学年も昇順にします。昇順はASCで指定するため、c1とc2の組合せはASC、ASCとなり、cはアです。
なお、GROUP BYは、指定した項目の組合せごとにデータをまとめる句です。このSQL文では年度・学年・性別ごとにまとめ、AVGで平均、MAXで最大、MINで最小を求めています。
誤りやすいポイント
- LIKEの「」と「%」を混同しないようにします。「」は任意の1文字、「%」は0文字以上の任意の文字列を表します。
- 「2010年度から2019年度まで」という範囲を、LIKE '2010'のように1年度だけの条件にしてしまわないようにします。
- ビューの性別は、元の表の数値をそのまま表示しているのではなく、CASE式で「男」や「女」に変換した結果です。条件に指定する値も、ビューの値に合わせます。
- ORDER BYを年度だけにすると、同じ年度の学年の並び順は指定されません。図1のように年度と学年の両方の順序をそろえるには、両方を指定します。
FAQ
Q: なぜ性別の条件を0ではなく'男'にするのですか?
A: このSQL文では、測定結果ビューの性別をCASE式で文字に変換しています。ビュー上の値は0ではなく「男」なので、条件も'男'にします。
A: このSQL文では、測定結果ビューの性別をCASE式で文字に変換しています。ビュー上の値は0ではなく「男」なので、条件も'男'にします。
Q: 年度の条件を= '201_'としてはいけませんか?
A: 「」を任意の1文字として扱うのはLIKEを使った場合です。=で比較すると、'201'という文字列そのものとの比較になります。
A: 「」を任意の1文字として扱うのはLIKEを使った場合です。=で比較すると、'201'という文字列そのものとの比較になります。
Q: ASCを省略しても同じ順番になりますか?
A: SQLでは昇順が既定の扱いになる場合がありますが、並べ替えの意図を明確にするにはASCを指定します。この問題では、選択肢の中から昇順を表すASCを選びます。
A: SQLでは昇順が既定の扱いになる場合がありますが、並べ替えの意図を明確にするにはASCを指定します。この問題では、選択肢の中から昇順を表すASCを選びます。
関連キーワード: SQL、LIKE述語、CASE式、集約関数、GROUP BY句、ORDER BY句

設問2:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
D中学校では、転入生を受け入れる場合、転出元の中学校から受領した定期健康診断の結果の情報をデータベースに登録する。健診結果表には、受診者IDと年度にd制約を設定し、受診者IDに受診者情報表の受診者IDへのe制約を設定している。この制約に従うと、転入生の定期健康診断の結果の情報の健診結果表への登録は、受診者情報表に転入生の情報を登録した後に行う必要がある。
d, eに関する解答群
ア:UNIQUE
イ:検査
ウ:参照
エ:主キー
オ:非NULL
模範解答
d:エ、e:ウ
解説
解答の導き方
この設問では、健診結果表に設定された二つの制約が何を表すかを考えます。
まず、健診結果表の定義には「PRIMARY KEY (年度, 受診者ID)」とあります。主キー(表の中で行を一つに決める項目、または項目の組合せ)を指定する記述です。ここでは「年度」と「受診者ID」の組合せが主キーです。したがって、同じ年度・同じ受診者IDの行を重複して登録できません。このことから、dには「主キー」が入ります。
次に、「FOREIGN KEY (受診者ID) REFERENCES 受診者情報表(受診者ID)」とあります。外部キー(別の表にある情報を参照する項目)を指定し、参照先の表と項目を示す記述です。この設定によって、健診結果表の受診者IDは、受診者情報表に存在する受診者IDを参照します。このような制約は参照制約と呼ばれるため、eには「参照」が入ります。
転入生の健診結果を登録する前に、受診者情報表へ転入生の情報を登録する必要があるのも、この参照制約があるためです。受診者情報表に該当する受診者IDがまだなければ、健診結果表から参照できず、登録できません。
誤りやすいポイント
- 「年度」と「受診者ID」は、それぞれ単独で主キーなのではなく、二つを組み合わせて主キーになります。
- UNIQUEは値の重複を防ぐ制約ですが、問題文の表定義にはPRIMARY KEYとあるため、dは「主キー」です。
- eは、別の表のデータを参照する制約を指しています。「検査」ではありません。参照先の受診者情報が先に登録されている必要があります。
FAQ
Q: 同じ受診者IDを、健診結果表に複数回登録できますか?
A: 年度が異なれば登録できます。主キーは「年度」と「受診者ID」の組合せなので、同じ組合せの行は登録できません。
A: 年度が異なれば登録できます。主キーは「年度」と「受診者ID」の組合せなので、同じ組合せの行は登録できません。
Q: 主キーと参照制約は、どのように役割が違いますか?
A: 主キーは表の中で行を区別します。参照制約は、別の表に存在するデータを参照できるようにします。
A: 主キーは表の中で行を区別します。参照制約は、別の表に存在するデータを参照できるようにします。
関連キーワード: 主キー、外部キー、参照制約、複合キー、データベース表
設問3:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
図2に示す身長階級表を作成し、これに対応させて、2019年度の男子生徒の定期健康診断データを基に、図3に示す身長度数分布表を作成したところ、“人数が相違している”との指摘があった。
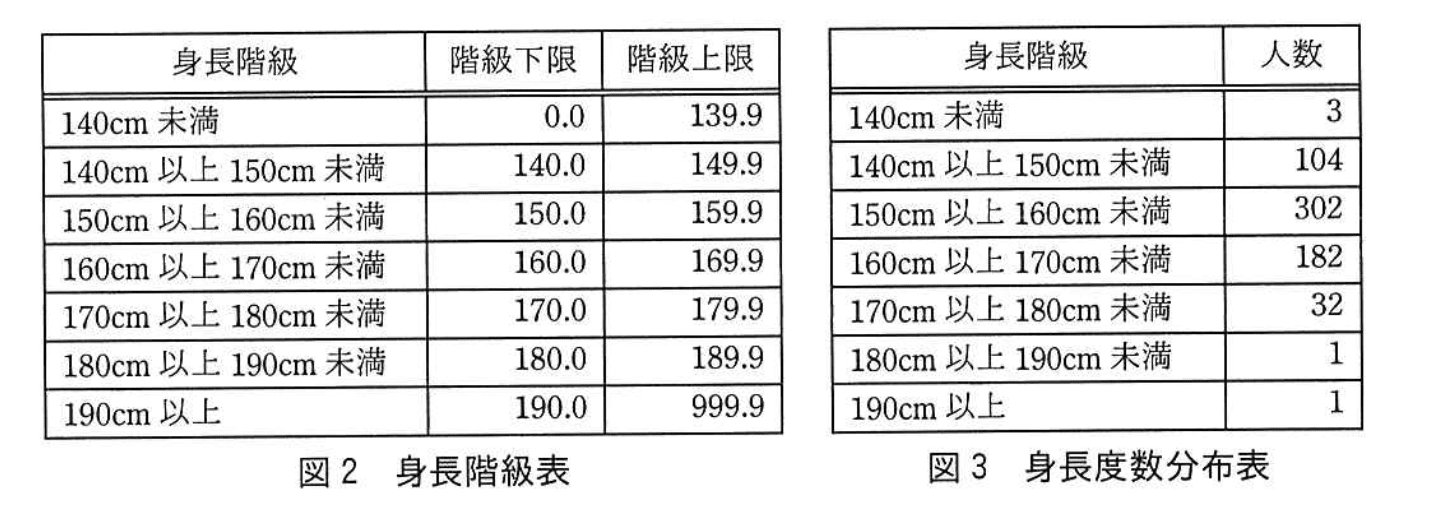
図3に示す身長度数分布表の作成は、次の(1)〜(3)の手順で行った。
(1) 図2に示す身長階級表をデータベースに作成した。
(2) 新たなSQL文を作成した。
(3) (2)で作成したSQL文の実行結果を用いて、図3に示す身長度数分布表を作成した。
調査の結果、(2)で作成したSQL文に誤りがあることが分かった。(2)で作成したSQL文は、次のとおりである。このSQL文は、対象とした全生徒を必ずいずれかの身長区分に分類して集計するために、身長階級表からは全レコードを、測定結果ビューからはON句に指定した結合条件に一致するレコードを抽出している。
SELECT 身長階級, 階級下限, COUNT() AS 人数
FROM 測定結果ビュー RIGHT OUTER JOIN 身長階級表 ON
身長 BETWEEN 階級下限 AND 階級上限
AND 年度 = '2019'
AND 性別 = '男'
GROUP BY 身長階級, 階級下限, 階級上限
ORDER BY 階級下限 ASC
図1を見ると、2019年度は男子全学年での最大身長が180.1cmであり、190cm以上の生徒は存在しないが、図3の身長度数分布表では、190cm以上の人数が1となっている。この原因は、(2)で作成したSQL文ではfとすべき箇所をCOUNT()としていることにある。その結果、測定結果ビューと身長階級表を結合した結果において、NULLとなっているレコードもカウントしているからである。
fに関する解答群
ア:COUNT(身長)
イ:COUNT(身長階級)
ウ:MAX(身長)
エ:MAX(身長階級)
オ:身長
カ:身長階級
模範解答
f:ア
解説
解答の導き方
この設問では、身長度数分布表の「人数」を数える項目として、COUNT(*)ではなく何を使うべきかを考えます。
まず、本文には「2019年度は男子全学年での最大身長が180.1cm」とあります。したがって、190cm以上の男子生徒はいません。それにもかかわらず、図3で190cm以上の人数が1になった理由は、実際の生徒を数えたのではなく、結合後に残ったレコードを数えているためです。
SQLでは、RIGHT OUTER JOIN(右外部結合:右側の表の行を、結合相手がなくても結果に残す結合方法)を使っています。右側にあるのは身長階級表です。そのため、190cm以上の階級に当てはまる測定結果がなくても、身長階級表のその階級の行は結果に残ります。一方、対応する測定結果はないので、測定結果ビュー側の項目はNULL(値がないことを表す状態)になります。
COUNT(*)は、項目の値がNULLかどうかに関係なく、結合後のレコード数を数えます。そのため、190cm以上の階級では、生徒がいなくても、残された階級表の行を1件として数えてしまいます。
ここで、COUNT(身長)にすると、身長の値がNULLの行は数えません。190cm以上の階級には該当する生徒の身長がないため、人数は0になります。生徒がいる階級では、身長の値がある行を数えられます。したがって、fに入るのはアのCOUNT(身長)です。
なお、COUNT(身長階級)では正しく数えられません。身長階級は右側の表にある項目なので、生徒がいない階級でも値が残り、COUNT(身長階級)もその行を数えてしまうためです。
誤りやすいポイント
- COUNT(*)は「生徒の人数」ではなく、結合後にできたレコードの数を数えます。外部結合で残された、生徒のいない階級の行も数えてしまいます。
- 外部結合で対応する行がないとき、NULLになるのは結合相手が見つからなかった側の項目です。このSQLでは測定結果ビュー側がNULLになります。
- COUNT(項目)は、その項目の値がNULLではない行だけを数えます。何の項目を指定するかによって、結果が変わります。
- COUNT(身長階級)は、階級表の行が残るため、測定結果がなくても数えてしまいます。生徒の有無を判定できる項目を指定する必要があります。
FAQ
Q: COUNT(*)は、どのようなときに使いますか?
A: 結果に含まれるレコードの総数を数えるときに使います。特定の項目がNULLかどうかは考慮しません。
A: 結果に含まれるレコードの総数を数えるときに使います。特定の項目がNULLかどうかは考慮しません。
Q: 身長階級表の行を、生徒がいなくても残すのはなぜですか?
A: 人数が0の階級も含めて、身長階級ごとの分布表を作るためです。階級表の全行を残す結合により、該当者のいない階級も出力できます。
A: 人数が0の階級も含めて、身長階級ごとの分布表を作るためです。階級表の全行を残す結合により、該当者のいない階級も出力できます。
Q: COUNT(身長)は、なぜNULLを数えないのですか?
A: COUNT(項目)は、その項目に値が入っている行を数える関数だからです。身長がNULLの行は、実際の測定値がないため人数に含まれません。
A: COUNT(項目)は、その項目に値が入っている行を数える関数だからです。身長がNULLの行は、実際の測定値がないため人数に含まれません。
関連キーワード: 外部結合、NULL、COUNT関数、GROUP BY句、結合条件

