
ネットワークスペシャリスト 2011年 午後1 問02
メールアーカイブシステム導入に関する次の記述を読んで、設問1~3に答えよ。
A社は、電子メール(以下、メールという)サーバを2年前に導入した。5,000名の社員が、本社、支社、支店に設置されたPCから、このサーバを利用している。メールは業務に不可欠であり、情報管理と事業継続の両面から重要な位置を占めている。
現在、A社の情報システム部では、来年度のIT予算を検討している。その中で、メールに関する次の二つの課題に対応するため、メールアーカイブシステム(以下、アーカイブという)の追加導入を計画している。
一つ目の課題は、メールデータの管理である。メールサーバが送受信する全てのメールデータを数年間保管し、必要な情報を即座に抽出できるようにする。二つ目の課題は、災害対策である。メールデータの保管場所を複数にし、片方が被災した場合にもメールデータが消失しないようにする。
A社のネットワークシステム構成図(抜粋)を図1に示す。
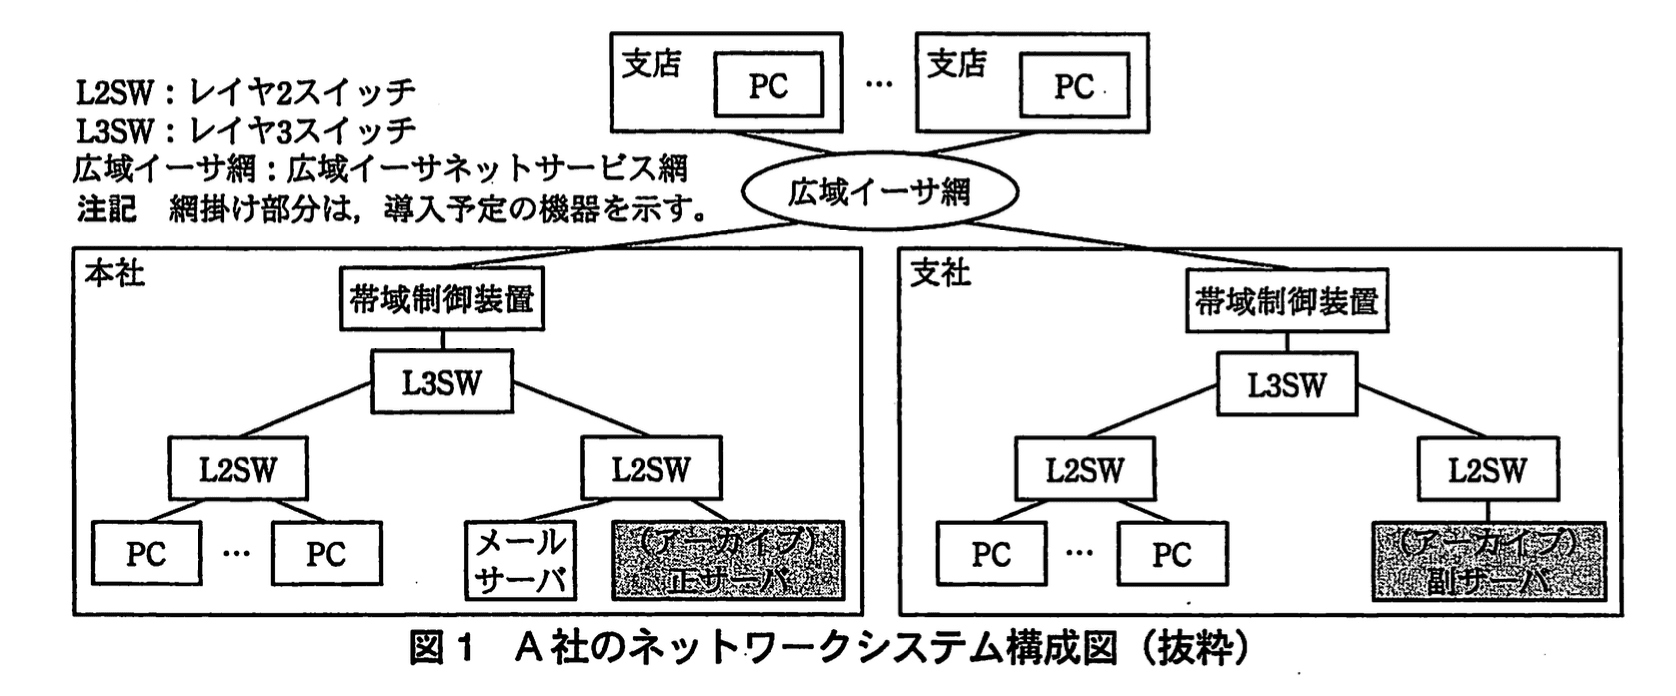
各拠点の接続には、広域イーサ網を用いている。大規模拠点である本社と支社には、帯域制御装置を設置し、広域イーサ網に送出する単位時間当たりのデータ量を通信の用途ごとに制御している。
アーカイブは、正サーバと副サーバで構成し、正サーバを本社に、副サーバを遠隔地の支社に設置する予定である。正サーバから副サーバへは大量のデータが転送されることから、帯域制御装置を使い、アーカイブに必要な帯域を割り当てる予定である。
アーカイブの処理時間には幾つか懸念事項がある。情報システム部長は、ネットワーク技術者のB君に、その検討を命じた。
〔システム要件と処理性能モデル〕
メール到着の都度、メールサーバは、全てのメールを、到着時刻順に1件ずつ正サーバへ転送する。正サーバは、受信したメールにディジタル署名を付加し、高速検索に用いるインデックス情報を作成し、データを圧縮した上で格納する。これらの処理を、保管プロセスと呼ぶ。
正サーバは、保管プロセスとは非同期に、格納されているメールを、保管時刻の古い順に、1件ずつ副サーバへ転送する。副サーバは、受信したメールを正サーバと同様に格納する。これらの処理を、複製プロセスと呼ぶ。
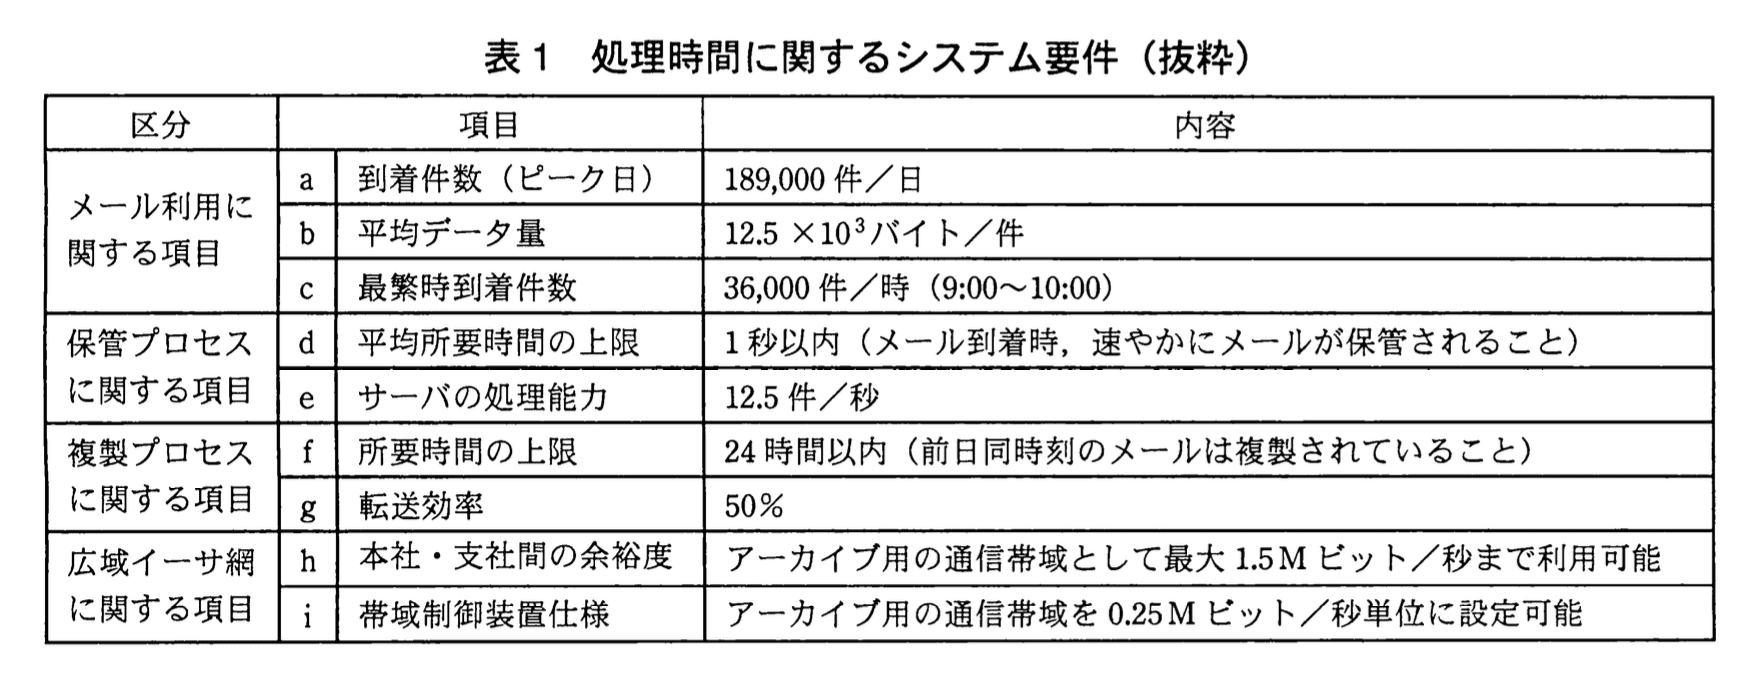
アーカイブのシステム要件を表1に示す。
B君は、アーカイブの所要時間に関する要件(表1中の項目d, f)を実現できるかどうかを検討するために、図2に示す処理性能モデルを作成した。
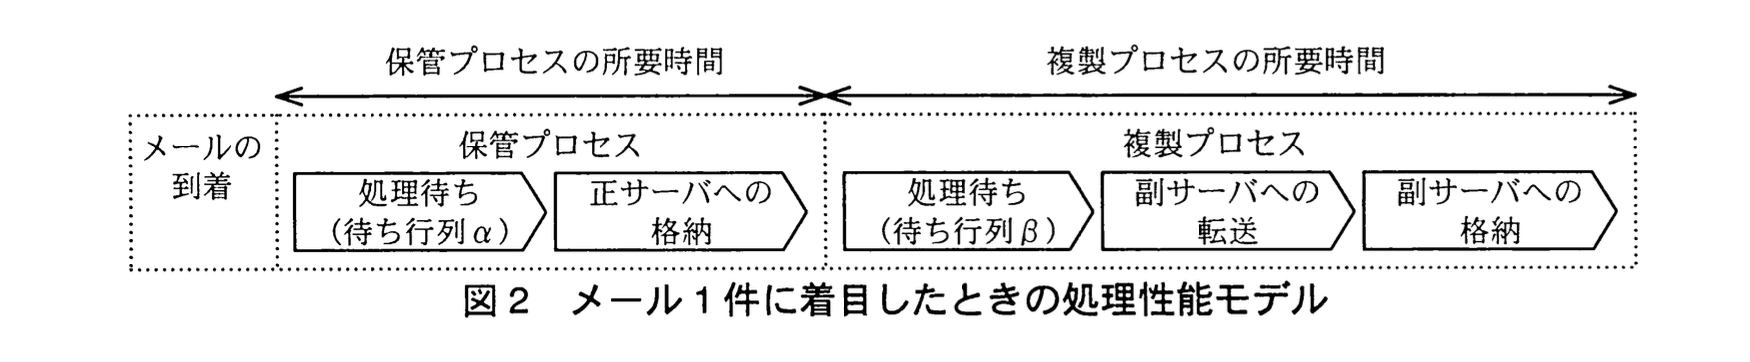
このモデルでは、メール1件に対する保管プロセスと複製プロセスを、二つの待ち行列と三つの処理に分解している。
B君は、各プロセスの所要時間を、次のように検討した。
〔保管プロセスに関する検討〕
図2中の待ち行列αについて考える。正サーバへの格納はメール到着の都度行われるので、①その到着はM/M/1の条件を満たすと仮定し、最繁時の平均待ち時間を算出する。最繁時には、ア件/秒の処理要求(λ)が発生する。また、単位時間の平均処理数(μ)は、サーバの処理能力からイ件/秒である。したがって、利用率(ρ)はウとなり、処理中のものを含めた待ち行列の長さの平均(平均系内数)は4.0、平均待ち時間はエ秒と算出できる。以上から、保管プロセスの平均所要時間は、1秒未満であるから、平均所要時間の上限(表1中の項目d)は超えていない。
〔複製プロセスに関する検討〕
図2中の待ち行列βには、M/M/1は適用できない。最繁時には、利用率(ρ)が1以上となり、大量のメールが正サーバに滞留する。そこで、処理性能モデルを見直し、滞留したメールが連続的に転送されると仮定する。その場合、1日に転送されるメールデータ量(189,000件/日×12.5×バイト/件)を、転送効率50%で24時間以内に転送することになる。B君は、②これらの条件で必要となる回線速度を算出し、アーカイブに0.5Mビット/秒の帯域を割り当てることとした。
次に、B君は、メールの到着時刻と転送時刻の関係を調べるため、図3を作成した。
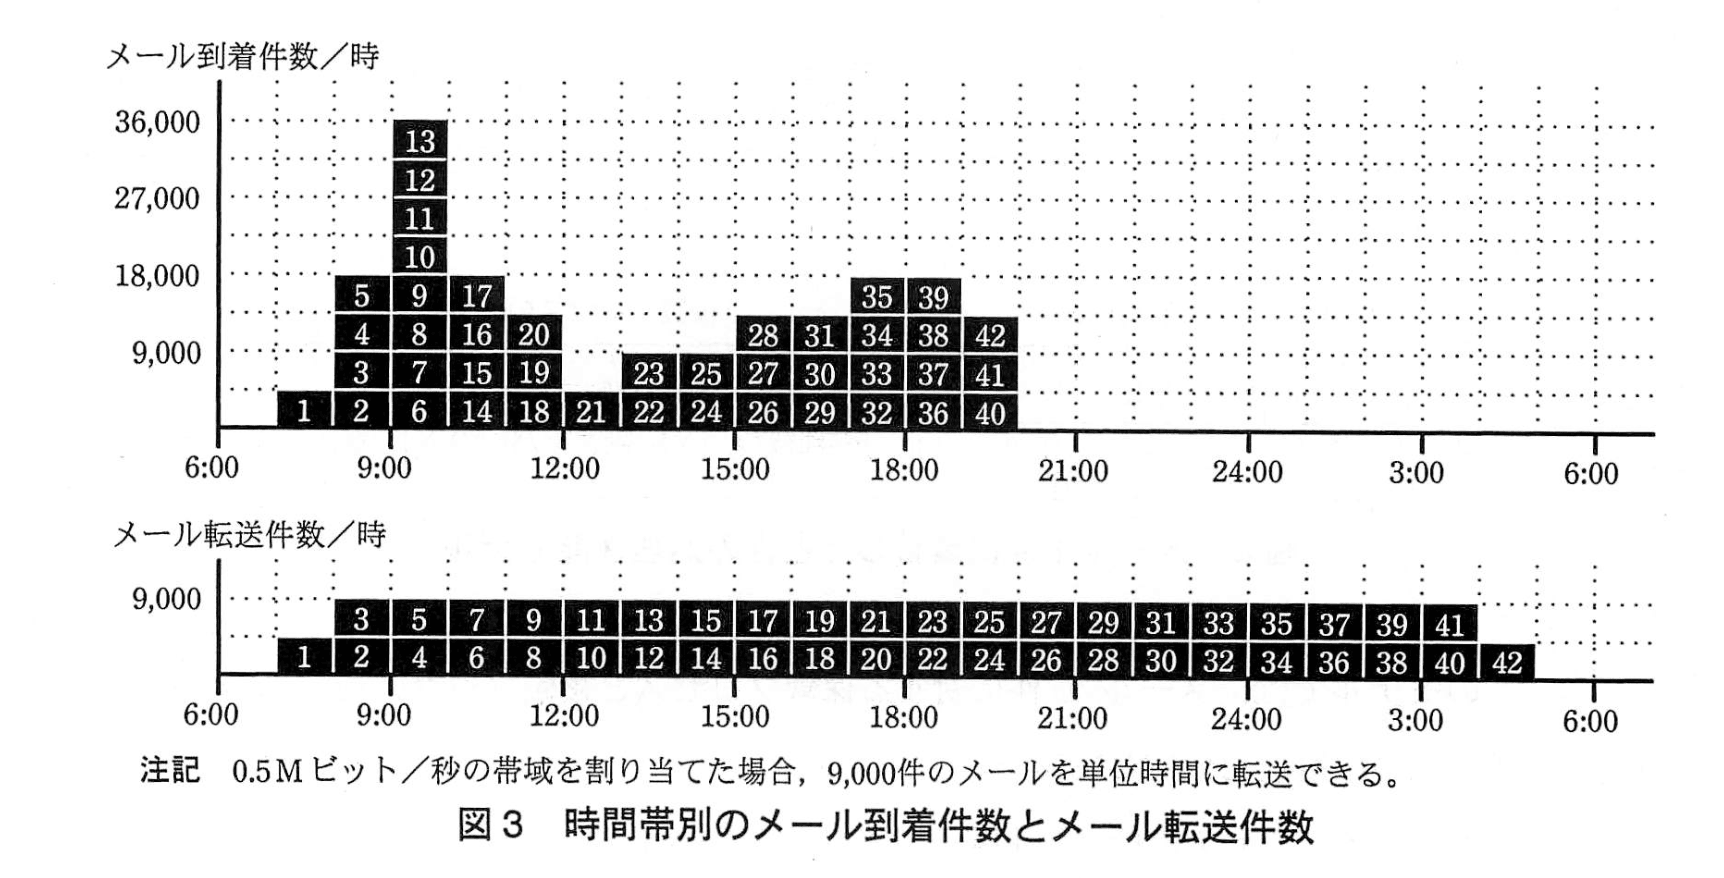
図3中の上段のグラフは、時間帯別のメールの到着数を示している。同じ時間帯に到着したメールは、到着順に4,500件を1グループとし、1~42のIDを付与している。
図3中の下段のグラフは、到着したメールが0.5Mビット/秒の帯域で順次転送される場合、どの時間帯に転送されるのかを示している。
図3によると、7:00~8:00に到着したID1のメール群は、同時間帯に転送される。一方、9:00~10:00に到着したID13のメール群の転送は、同時間帯ではなく、オ:00~カ:00に行われる。このことから、ID13のメール群の各メールに関する、複製プロセスの所要時間は、約キ時間とみなせる。
このようにして、B君は、図3から、複製プロセスの所要時間が最大となるのは、IDクのメール群であり、その所要時間は、約ケ時間になると推定し、所要時間の上限(表1中の項目f)は超えないと判断した。
以上の検討から、B君は、広域イーサ網の帯域1.5Mビット/秒(表1中の項目h)のうち、0.5Mビット/秒を割り当てることで、アーカイブの所要時間に関する要件(表1中の項目d, f)を実現できることを、情報システム部長に報告した。
設問1:〔システム要件と処理性能モデル〕について、(1)、(2)に答えよ。
問題文を見る(1)正サーバが、メールにディジタル署名を付加する目的を、20字以内で述べよ。
模範解答
メールデータの改ざん防止のため
解説
解答の論理構成
- 【問題文】には「正サーバは、受信したメールにディジタル署名を付加し、高速検索に用いるインデックス情報を作成し、データを圧縮した上で格納する。」とあります。
- ディジタル署名は公開鍵暗号方式を利用し、電子的な“封印”を施す技術です。
- この“封印”により、署名後のデータが途中で書き換えられると検証に失敗します。
- したがって、署名の主目的はメールデータの真正性・整合性を維持し、改ざんを防ぐことです。
- 上記を踏まえ「メールデータの改ざん防止のため」とまとめれば設問の意図を満たします。
誤りやすいポイント
- ディジタル署名=暗号化と誤解し「盗聴防止」と答えてしまう。署名は暗号化とは別で改ざん検知が主目的です。
- 「送信者認証」を主目的と断定してしまう。認証機能もありますが、設問は「メール⇔ディジタル署名を付加する目的」とし、データ保管フェーズの説明なので改ざん防止が核心です。
- 長文説明を書いてしまい減点される。キーワードを絞る必要があります。
FAQ
Q: 暗号化とディジタル署名は同じものですか?
A: 別物です。暗号化は内容を読めないようにし、ディジタル署名は改ざん検知と真正性証明を行います。
A: 別物です。暗号化は内容を読めないようにし、ディジタル署名は改ざん検知と真正性証明を行います。
Q: 設問はなぜ「送信時」ではなく「保管時」に署名を付加しているのですか?
A: 送信後のメールも長期間アーカイブに保管するため、保管中の改ざんリスクを排除して証拠能力を高める狙いがあります。
A: 送信後のメールも長期間アーカイブに保管するため、保管中の改ざんリスクを排除して証拠能力を高める狙いがあります。
Q: 署名鍵の管理はどこで行うのですか?
A: 一般的には正サーバ側で安全な鍵管理システムを用意し、秘密鍵を厳重に保護します。公開鍵は検証時に利用されます。
A: 一般的には正サーバ側で安全な鍵管理システムを用意し、秘密鍵を厳重に保護します。公開鍵は検証時に利用されます。
関連キーワード: ディジタル署名, 改ざん防止, データ真正性, 公開鍵暗号, メールアーカイブ

設問1:〔システム要件と処理性能モデル〕について、(1)、(2)に答えよ。
問題文を見る(2)表1の要件における、本社被災に関するメールデータのRPO(リカバリポイント目標)を答えよ。
模範解答
24時間
解説
解答の論理構成
- 災害対策に関する要件は、本社が被災してもメールデータを失わないようにすることです。
引用:「二つ目の課題は、災害対策である。メールデータの保管場所を複数にし、片方が被災した場合にもメールデータが消失しないようにする。」 - どの程度の最新データまで確保できればよいかを示す指標がRPO(Recovery Point Objective)です。
- 表1の「複製プロセスに関する項目」で、遠隔地(副サーバ)へのコピーが完了すべき期限が明示されています。
引用:「f 所要時間の上限 24時間以内(前日同時刻のメールは複製されていること)」 - この「24時間以内」が、最大でどこまでのデータを失ってよいか(=許容データ損失時間)を定義しているため、RPOは「24時間」となります。
誤りやすいポイント
- RPOとRTOを混同し、復旧完了までの時間(RTO)と勘違いする。
- 「24時間以内」を“最長1日遅延で良い”と読み流し、数値を答え忘れる。
- 「複製プロセス」の要件を見落とし、「保管プロセス」の1秒をRPOと誤解する。
FAQ
Q: RPOが「24時間」ということは、最悪1日分のメールが失われる可能性があるのですか?
A: はい。副サーバへの複製が最大24時間遅延する設計なので、本社が突然被災した場合、直近24時間以内に到着したメールは失われるリスクがあります。
A: はい。副サーバへの複製が最大24時間遅延する設計なので、本社が突然被災した場合、直近24時間以内に到着したメールは失われるリスクがあります。
Q: RTO(復旧時間目標)は問題文に示されていますか?
A: 本問ではRTOに相当する具体的な数値は示されておらず、設問もRPOのみを問うています。
A: 本問ではRTOに相当する具体的な数値は示されておらず、設問もRPOのみを問うています。
Q: 複製プロセスが24時間以内に終われば、帯域はどの程度でもよいのですか?
A: いいえ。表1の「転送効率」「広域イーサ網の余裕度」などを踏まえ、B君は0.5Mビット/秒を割り当てる設計としています。
A: いいえ。表1の「転送効率」「広域イーサ網の余裕度」などを踏まえ、B君は0.5Mビット/秒を割り当てる設計としています。
関連キーワード: RPO, ディザスタリカバリ, データ複製, 広域イーサ網, 帯域制御
設問2:〔保管プロセスに関する検討〕について、(1)、(2)に答えよ。
問題文を見る(1)本文中の下線①について、到着条件を20字以内で述べよ。
模範解答
メールがランダムに到着する
解説
解答の論理構成
- 本文の該当部分
「①その到着はM/M/1の条件を満たすと仮定」とあるように、待ち行列αを解析する前提としてメール到着過程を “M/M/1” 型とみなしています。 - “M/M/1” 型待ち行列の第一の前提は「到着がポアソン過程(マルコフ到着)=完全にランダムである」ことです。
- よって設問が求める「到着条件」は、メールが規則的でも一定間隔でもなく、“ランダムに到着する” という一文で表せます。
- 以上より解答は「メールがランダムに到着する」となります。
誤りやすいポイント
- 「M/M/1」を“サービスが1台”の意味だけと捉え、到着過程の仮定を回答し忘れる。
- ランダムの代わりに「一定平均間隔」などと書き、ポアソン到着を誤解する。
- 待ち行列αではなくβ側の条件(連続転送など)と混同してしまう。
- 「メールが次々に来る」など曖昧な表現で具体性を欠き、M/M/1の必須要件を示せていない。
FAQ
Q: M/M/1の「M」は何を表していますか?
A: 「Markovian(指数分布)」を意味し、到着間隔とサービス時間がともに指数分布であることを示します。
A: 「Markovian(指数分布)」を意味し、到着間隔とサービス時間がともに指数分布であることを示します。
Q: 到着がポアソン過程だとなぜ解析しやすいのですか?
A: メモリレス性(過去に依存しない)が成り立つため、利用率や平均待ち時間を簡潔な式で求められます。
A: メモリレス性(過去に依存しない)が成り立つため、利用率や平均待ち時間を簡潔な式で求められます。
Q: 本社と支社間の帯域設定(0.25Mビット/秒単位)と到着条件は関係しますか?
A: 直接は関係しません。到着条件は待ち行列理論上の仮定、帯域は複製プロセスの転送能力に影響します。
A: 直接は関係しません。到着条件は待ち行列理論上の仮定、帯域は複製プロセスの転送能力に影響します。
関連キーワード: ポアソン過程, 待ち行列理論, メモリレス性, 利用率
設問2:〔保管プロセスに関する検討〕について、(1)、(2)に答えよ。
問題文を見る(2)本文中のア~エに入れる適切な数値を答えよ。
模範解答
ア:10
イ:12.5
ウ:0.8
エ:0.32
解説
解答の論理構成
-
最繁時の到着件数を秒に換算
【問題文】「最繁時到着件数 36,000件/時(9:00~10:00)」
1時間は3,600秒なので
よって
ア:10 -
サーバの平均処理能力
【問題文】「サーバの処理能力 12.5件/秒」
これをそのまま μ とするので
イ:12.5 -
利用率 ρ の算出
よって
ウ:0.8 -
平均待ち時間 の算出
M/M/1待ち行列の平均待ち時間は
により
したがって
エ:0.32 -
要件との照合
【問題文】「平均所要時間の上限 1秒以内」
保管プロセスの待ち時間0.32秒は1秒未満であり、条件を満たすと判断できる。
誤りやすいポイント
- 件/時をそのまま λ にしてしまい、ρ が1を超えてしまう計算ミス。必ず秒単位に換算すること。
- 平均待ち時間にサービス時間を含めてしまい、 を使って0.4秒ではなく0.32秒になる理由を誤認するケース。
- 表中の「12.5件/秒」を12.5秒/件と読み違え、λ と μ を逆にしてしまう誤読。
FAQ
Q: ρ が1に近い場合でもM/M/1の式は使えますか?
A: ρ<1であれば理論上は適用可能です。本問では0.8と十分余裕があるため適用に問題はありません。
A: ρ<1であれば理論上は適用可能です。本問では0.8と十分余裕があるため適用に問題はありません。
Q: 平均待ち時間0.32秒はキュー待ちだけですか、処理時間も含みますか?
A: 0.32秒はキュー待ち時間 です。処理中の1/μ=0.08秒を加えた系全体の平均滞在時間は0.40秒になります。
A: 0.32秒はキュー待ち時間 です。処理中の1/μ=0.08秒を加えた系全体の平均滞在時間は0.40秒になります。
Q: サービス率 μ を件/秒で与える理由は?
A: M/M/1モデルでは到着率 λ、サービス率 μ の単位を合わせる必要があるためです。秒単位に統一するとスループットと待ち時間を直接比較できます。
A: M/M/1モデルでは到着率 λ、サービス率 μ の単位を合わせる必要があるためです。秒単位に統一するとスループットと待ち時間を直接比較できます。
関連キーワード: M/M/1, 利用率, 到着率, 平均待ち時間, 待ち行列理論
設問3:〔複製プロセスに関する検討〕について、(1)〜(3)に答えよ。
問題文を見る(1)本文中の下線②について、必要となる回線速度を求めよ。答えは小数第3位を四捨五入して、小数第2位まで求めよ。
模範解答
0.44
解説
解答の論理構成
-
1日に転送すべきメール量を算定
- 問題文の引用:
「189,000件/日×12.5×10^3バイト/件」 - 計算
- 問題文の引用:
-
ビット換算
- 1byte=8bitより
- 1byte=8bitより
-
24時間で送る場合の平均転送レート(ペイロード)
- 問題文の引用:
「24時間以内」 - 1日=
- 計算
- 問題文の引用:
-
回線効率を考慮
- 問題文の引用:
「転送効率50%」 - 実効帯域=物理帯域×効率 ⇒ 物理帯域=実効帯域/0.5
- 計算
- 問題文の引用:
-
指定の丸め
- 問題文の指示:
「小数第3位を四捨五入して、小数第2位まで」 - を四捨五入 → 0.44
- 問題文の指示:
誤りやすいポイント
- byteとbitの換算(×8)を忘れる。
- 「転送効率50%」を読み飛ばし、÷0.5をしない。
- 秒数換算で1日=86,400秒を取り違える(例:84,600秒など)。
- 最後の四捨五入を誤り0.43や0.45にしてしまう。
FAQ
Q: 転送効率が50% とは具体的に何を指しますか?
A: プロトコルヘッダや再送制御によるオーバヘッドで、回線帯域のうち実際にデータを運べる割合が半分という意味です。そのため計算では実効レート÷0.5を行います。
A: プロトコルヘッダや再送制御によるオーバヘッドで、回線帯域のうち実際にデータを運べる割合が半分という意味です。そのため計算では実効レート÷0.5を行います。
Q: ピーク時ではなく1日総量で計算して良いのはなぜですか?
A: 検討箇所は「24時間以内 に全件を複製」という要件であり、正サーバでの滞留を想定しているため、ピーク時の瞬時帯域ではなく1日総量を平均化した値で判断します。
A: 検討箇所は「24時間以内 に全件を複製」という要件であり、正サーバでの滞留を想定しているため、ピーク時の瞬時帯域ではなく1日総量を平均化した値で判断します。
Q: 計算結果が0.44Mbit/sでも、帯域制御装置の最小設定単位は0.25Mbit/sですが?
A: 0.44Mbit/sは0.25Mbit/sの倍数ではないため、実際の設定では切り上げて0.5Mbit/sを確保し、マージンを持たせています。
A: 0.44Mbit/sは0.25Mbit/sの倍数ではないため、実際の設定では切り上げて0.5Mbit/sを確保し、マージンを持たせています。
関連キーワード: M/M/1, 回線容量計算, 帯域利用率, データ転送効率, バイト/ビット換算
設問3:〔複製プロセスに関する検討〕について、(1)〜(3)に答えよ。
問題文を見る(2)本文中のオ~ケに入れる適切な整数を答えよ。
模範解答
オ:13
カ:14
キ:4
ク:42
ケ:9
解説
解答の導き方
- 帯域割当と転送能力の確認
- 図3の注記に「注記:0.5 Mビット/秒の帯域を割り当てた場合、9,000件のメールを単位時間に転送できる。」とあることから、まずこの数値が正しいか確認します。
- 平均データ量は「12.5×10^3バイト/件」ですから、1件あたりのビット数は
(bit/件)です。 - 0.5 Mビット/秒の回線が1時間に運べるビット数は
(bit/時)で、転送効率50%を適用すると実効で
(bit/時)になります。 - したがって1時間あたりに転送できる件数は
(件/時)となり、図3の注記と一致します。
- 1グループ当たりの転送時間算出
- 同じ時間帯に到着したメールを「到着順に4,500件を1グループとする」と明示されています。
- 1グループ(4,500件)を転送するのに要する時間は
(時間)=30分です。
- 転送スロットの割り当て(時刻割り当てのルール)
- 図3本文に「7:00~8:00に到着したID1のメール群は、同時間帯に転送される。」とあるため、転送は少なくともその時間帯内に開始されることがわかります。これと1グループの所要時間30分から、合理的な時刻割り当てとして「最初の転送スロットを7:00開始の30分刻み」と仮定します(7:00–7:30がID1、7:30–8:00がID2、…という並び)。この仮定は図3の説明と矛盾しませんし、以降の計算を一意にします。
- ID13の転送時刻と複製所要時間(オカ[ キ )
- k番目のグループの転送開始は (時間)、終了は (時間)となります。
- k=13のとき、転送開始は 、終了は です。したがってID13の転送は13:00~13:30の区間に含まれますから、時間帯表記では「13:00~14:00」に行われると表現できます。よって オ=13、カ=14。
- ID13の到着は問題文で「9:00~10:00に到着したID13」と明示されています。到着時刻帯の代表値として中央値(9:30)を採ると、到着(代表)9:30 → 転送完了13:30の差は (時間)です。よって キ=4。
(注)到着時刻帯の代表値として中央値を採るのは、到着がその時間帯に広く分布すると仮定して「おおよその所要時間」を見積もるための標準的な扱いです。
- 複製プロセスの最大所要時間となるグループとその時間(ク[ ケ )
- 全42グループを連続転送すると総所要時間は (時間)です。最初の転送開始を7:00とすると、最終(42番)グループの転送完了時刻は になります。つまりID42の転送完了は翌4:00です。
- 図3の上段を見ると、ID42はその日の夕方帯(19:00~20:00)に到着していることが読み取れます(図中のブロック配置によりID番号の横位置が到着時刻を示しています)。到着時刻の代表値に中央値19:30を採ると、到着19:30 → 転送完了翌4:00の差は (時間)で、四捨五入して約9時間となります。したがって最長となるのはID42で、その所要時間は約9時間です。よって ク=42、ケ=9。
(補足)以上の計算で採用した代表値(到着時刻の中央値)と「最初の転送スロットを7:00開始とする」仮定は、図3の記述「7:00~8:00に到着したID1は同時間帯に転送される」と矛盾しない一意的な時刻配置を与えるための合理的な選び方です。
誤りやすいポイント
- 帯域から「件/時」を求める際にバイト→ビットの換算(×8)を忘れる。
- 転送効率50%を適用し忘れてしまい、転送能力を2倍に見積もるミス。
- 1グループを4,500件とすることを見落とし、1グループ=9,000件で計算してしまう。
- 転送スロットの起点(7:00か7:30か)でオフバイワンを起こす。問題文の「ID1は7:00~8:00に到着し同時間帯に転送される」を基に開始時刻を決める必要があります。
- 到着時刻帯(例:9:00~10:00)の代表値を「開始時刻」「終了時刻」「中央値」のどれで取るかで所要時間が変わるため、どの方式を採ったかを明示しないと減点される可能性がある。
FAQ
Q: 到着時刻帯の代表値を中央値にしたのはなぜですか?
A: 図3では到着は時間帯(例9:00~10:00)で与えられており、個々のメールの到着分布は示されていません。到着がその時間帯に概ね分布していると仮定する場合、中央値(9:30)を代表値として使うのが標準的で、一貫した近似値が得られます。問題文の「約○時間」を答える趣旨にも合致します。
A: 図3では到着は時間帯(例9:00~10:00)で与えられており、個々のメールの到着分布は示されていません。到着がその時間帯に概ね分布していると仮定する場合、中央値(9:30)を代表値として使うのが標準的で、一貫した近似値が得られます。問題文の「約○時間」を答える趣旨にも合致します。
Q: 最初の転送スロットを7:00開始とした根拠は?
A: 問題文に「7:00~8:00に到着したID1のメール群は、同時間帯に転送される」と明記されています。転送が同時間帯に行われるということから、転送が7:00台に開始されたと見なすのが自然であり、30分刻みのスロット(4,500件で0.5時間)に合わせると7:00開始とするのが最も単純で一意的な配置になります。
A: 問題文に「7:00~8:00に到着したID1のメール群は、同時間帯に転送される」と明記されています。転送が同時間帯に行われるということから、転送が7:00台に開始されたと見なすのが自然であり、30分刻みのスロット(4,500件で0.5時間)に合わせると7:00開始とするのが最も単純で一意的な配置になります。
Q: 切り上げ・切り捨て・四捨五入はどう扱うべきですか?
A: 設問が「約○時間」と問うている場合は、代表値から得られる小数は四捨五入して整数で示すのが通常です。計算の前提(中央値を採用する等)を説明しておけば採点側に意図が伝わります。
A: 設問が「約○時間」と問うている場合は、代表値から得られる小数は四捨五入して整数で示すのが通常です。計算の前提(中央値を採用する等)を説明しておけば採点側に意図が伝わります。
関連キーワード: 帯域制御、転送効率、M/M/1キュー、平均待ち時間、単位変換(バイト⇔ビット)
設問3:〔複製プロセスに関する検討〕について、(1)〜(3)に答えよ。
問題文を見る(3)割り当てる帯域を0.5Mビット/秒から1.5Mビット/秒に増やした場合、複製プロセスの所要時間は最長何時間となるかを整数で答えよ。また、その根拠を50字以内で具体的に述べよ。
模範解答
所要時間:1
根拠:到着件数が転送可能件数を上回るのはピーク時間帯だけで、次の時間帯には滞留が解消するため
解説
解答の導き方
設問は「割り当て帯域を0.5Mビット/秒から1.5Mビット/秒に増やしたとき、複製プロセスの所要時間の最長が何時間か」を求める問題です。解くために使う【問題文】の要点は次の通りです:平均データ量「12.5×10^3バイト/件」、転送効率「50%」(表1)、図3の注記「0.5 Mビット/秒の帯域を割り当てた場合、9,000件のメールを単位時間に転送できる。」および最繁時到着「36,000件/時(9:00~10:00)」。これらを順に使って計算します。
-
1.5Mビット/秒での単位時間当たり転送可能件数を求める
図3の注記に「0.5 Mビット/秒 … 9,000件/単位時間」とあるので、帯域を3倍にすれば転送能力も3倍になります。従って
1.5Mビット/秒での転送能力 = 9,000件/時 × 3 = 27,000件/時。
(確認のために式で示すと、1件あたりのビット数は 、有効帯域は bit/sなので、件/時は 件/時になります。) -
グループ単位への変換と処理能力(グループ/時)
図3では「同じ時間帯に到着したメールは、到着順に4,500件を1グループ」としているので、1グループは4,500件です。よって
27,000件/時 ÷ 4,500件/グループ = 6グループ/時。 -
最繁時(9:00~10:00)の状況と残滞量
表1に「最繁時到着件数36,000件/時(9:00~10:00)」とあるので、この時間帯の到着は36,000件=8グループです。1.5Mビット割当てで同時間帯に転送できるのは6グループなので、この時間帯終了時点で未転送の滞留は8 − 6 = 2グループ = 9,000件 となります。 -
次時間帯での解消可否(図3での確認)
図3の上段を見ると、9:00~10:00に到着したのはID13であり、その次(10:00~11:00)の到着群はID14で、ID14は「0–9,000件」の区間に入っています。したがって10:00~11:00の到着は最大9,000件(=2グループ)です。よって10:00~11:00に処理すべき合計量は滞留9,000件+新着≤9,000件=≤18,000件であり、1時間当たりの処理能力27,000件で十分に転送できます。つまりID13に含まれる各メールは遅くとも到着の翌時間帯内に複製が完了します。
以上より、割り当て帯域を0.5Mビット/秒から1.5Mビット/秒に増やした場合の複製プロセスの所要時間の最長は「1時間」です。
誤りやすいポイント
- 転送効率「50%」を忘れてビット→件の換算を行い、転送可能件数を過大評価する。
- バイトとビットを混同して計算ミスをする(12.5×10^3バイト=100,000ビット/件)。
- 図3の実際の到着分布を確認せずに「次の時間帯の到着は必ず小さい」と仮定する(論理の飛躍)。今回の判断では図3のID配置でID14が「0–9,000件」であることを根拠にしている点が重要です。
- 単位時間が何を指すか(秒・分・時)を確認しないで計算する。図中の縦軸は「件/時」です。
- グループサイズ(4,500件)を使わずにグループ単位での増減を扱うと誤解しやすい。
FAQ
Q: 図3の「単位時間」は何を指しますか?
A: 図3の縦軸ラベルが「件/時」になっているので、単位時間は1時間です。
A: 図3の縦軸ラベルが「件/時」になっているので、単位時間は1時間です。
Q: 0.5Mビット/秒で9,000件/時という数値はどう得られますか?
A: 1件あたりは「12.5×10^3バイト/件」=100,000ビット/件で、0.5Mビット/秒の有効転送は転送効率「50%」を掛けるため実効帯域は bit/s。よって1秒あたり 件/秒、1時間で 件/時 になります。図3の注記と一致します。
A: 1件あたりは「12.5×10^3バイト/件」=100,000ビット/件で、0.5Mビット/秒の有効転送は転送効率「50%」を掛けるため実効帯域は bit/s。よって1秒あたり 件/秒、1時間で 件/時 になります。図3の注記と一致します。
Q: なぜID13を検討対象にしたのですか?他にもっと長く滞留する時間帯はありませんか?
A: 図3で「最繁時到着件数36,000件/時(9:00~10:00)」がID13に対応しており、その直後のID14が「0–9,000件」帯であることが明示されています。1.5Mビット/秒では1時間で27,000件処理でき、9:00~10:00の残滞9,000件と次時刻の最大9,000件を合わせても27,000件以下となるため、ID13が代表的な最悪ケースとして扱え、遅延は翌時間内に解消されます。
A: 図3で「最繁時到着件数36,000件/時(9:00~10:00)」がID13に対応しており、その直後のID14が「0–9,000件」帯であることが明示されています。1.5Mビット/秒では1時間で27,000件処理でき、9:00~10:00の残滞9,000件と次時刻の最大9,000件を合わせても27,000件以下となるため、ID13が代表的な最悪ケースとして扱え、遅延は翌時間内に解消されます。
関連キーワード: 待ち行列理論、帯域幅、転送効率、データサイズ、単位変換

