
応用情報技術者 2011年 春期 午後 問02
集計表をHTMLに変換して出力するプログラムに関する次の記述を読んで、設問1〜4に答えよ。
図1に示すような、都道府県及び支店ごとに整理された売上高一覧のCSVファイルを入力し、表1のような都道府県ごとの売上高の集計表をHTMLで出力するプログラムがある。ここで、一つの都道府県における支店数は500未満とする。
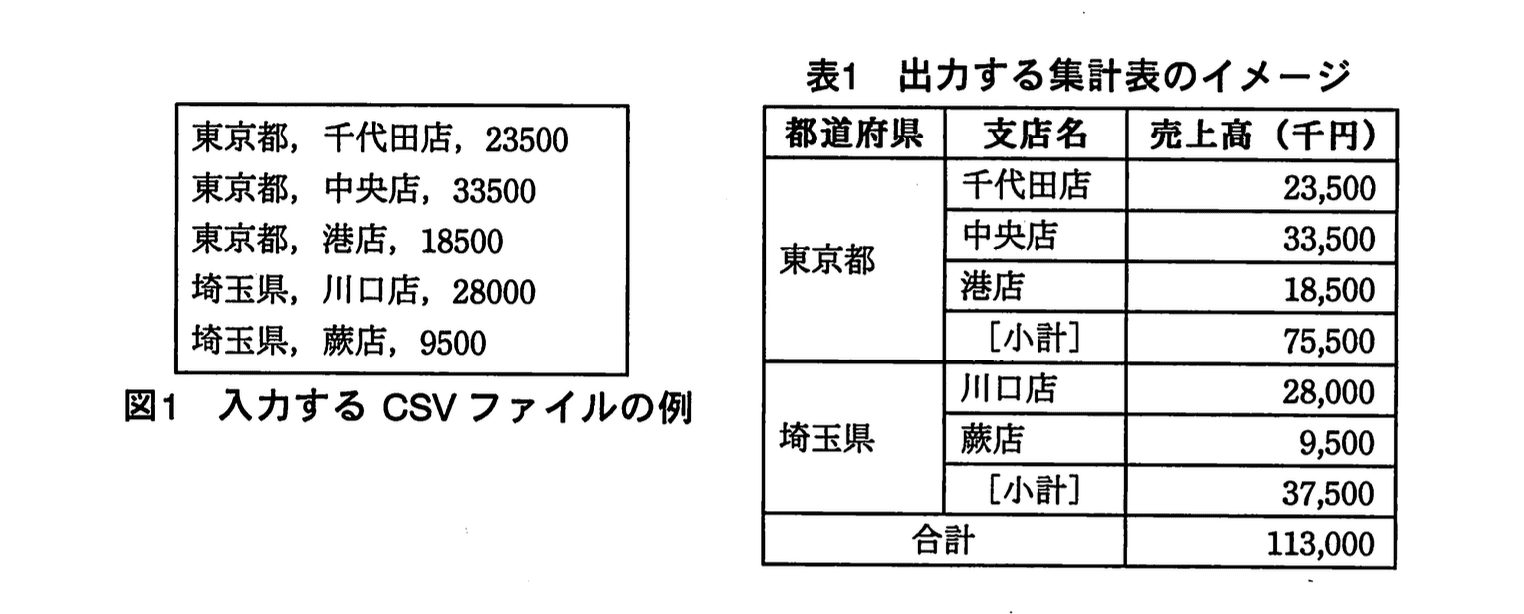
〔使用するHTMLについて〕
使用するHTMLタグ及びその属性を表2に示す。
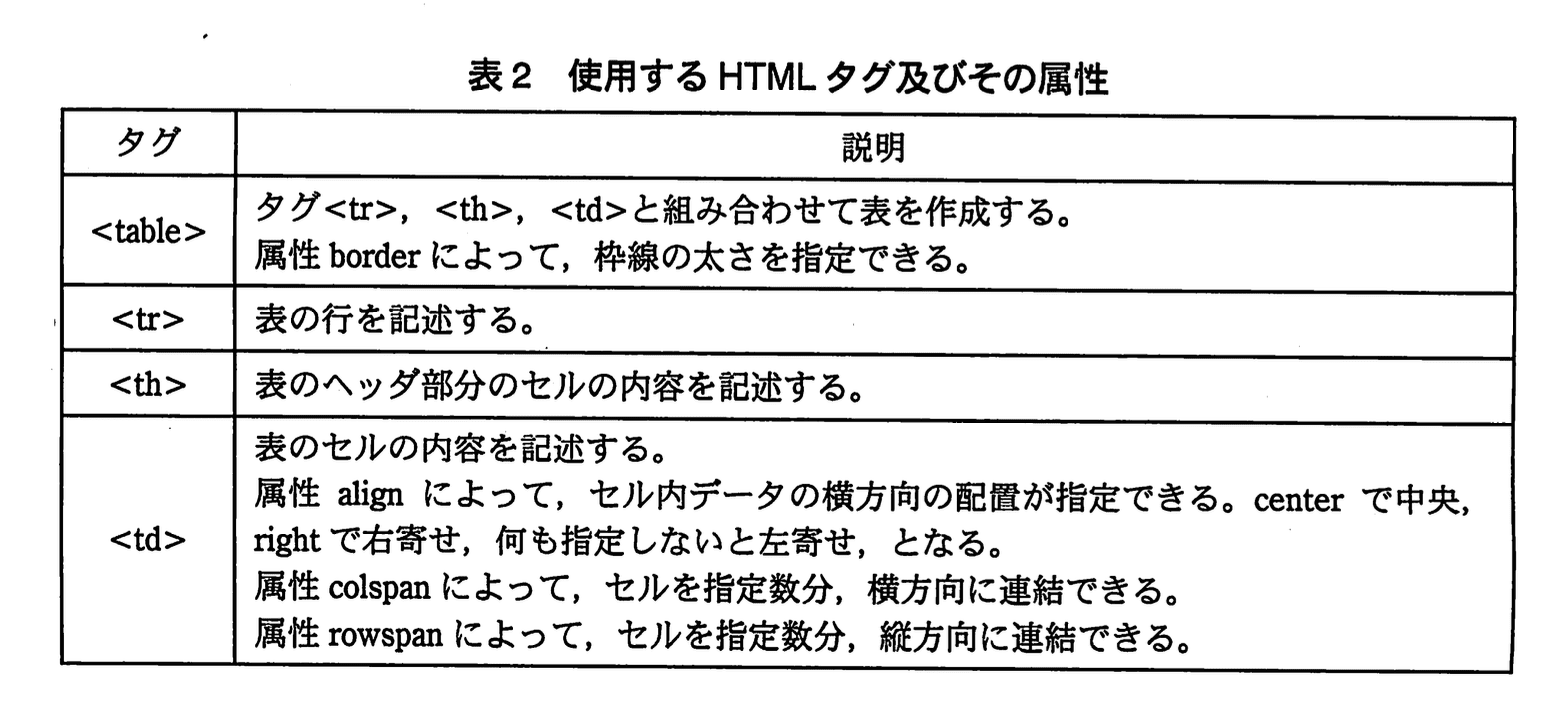
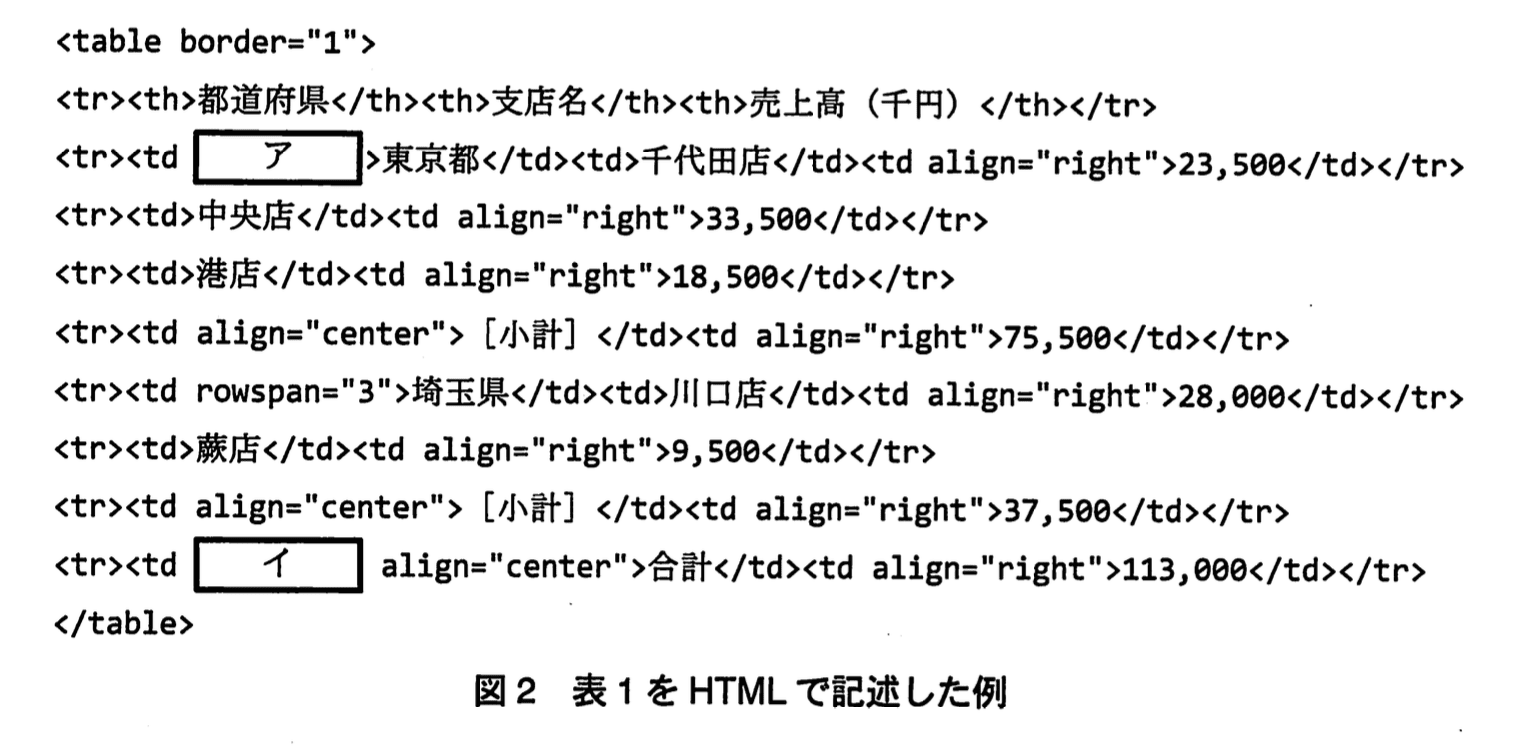
表1をHTMLで記述した例を図2に示す。
〔プログラムの概要〕
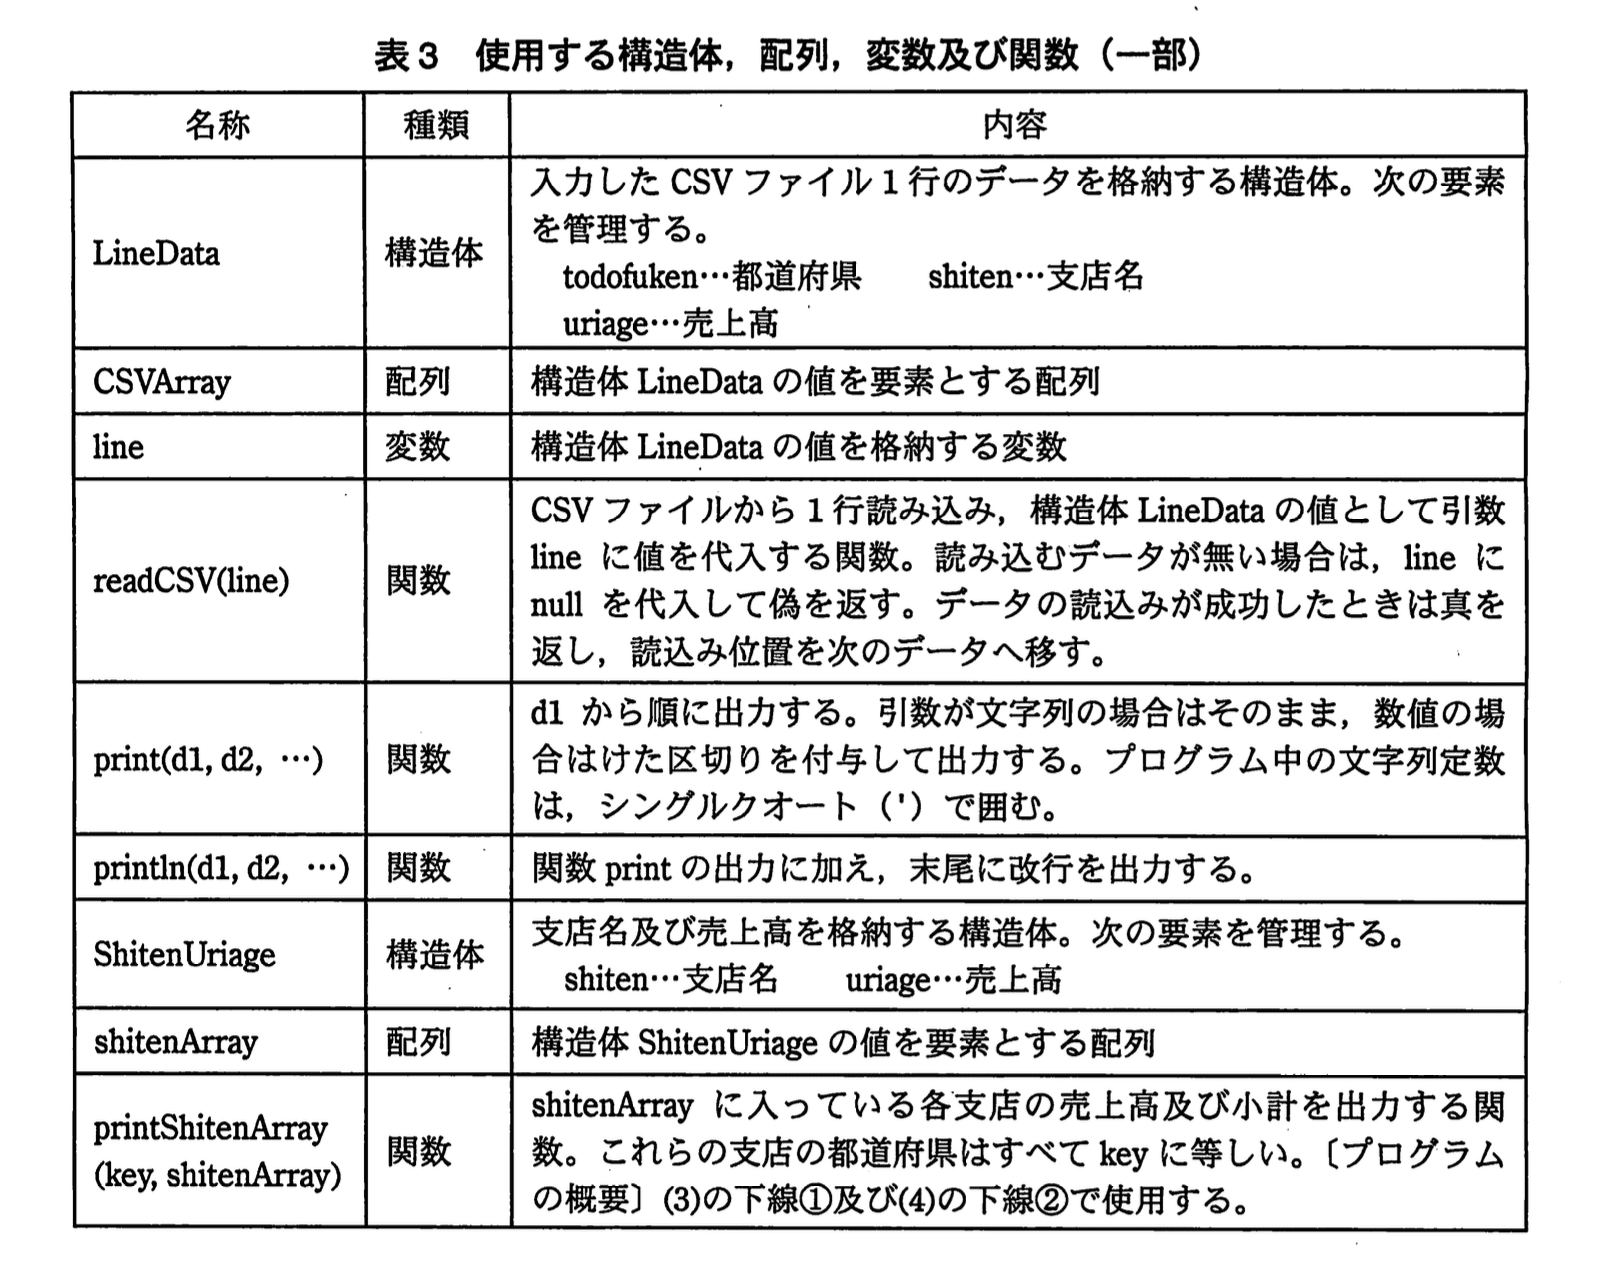
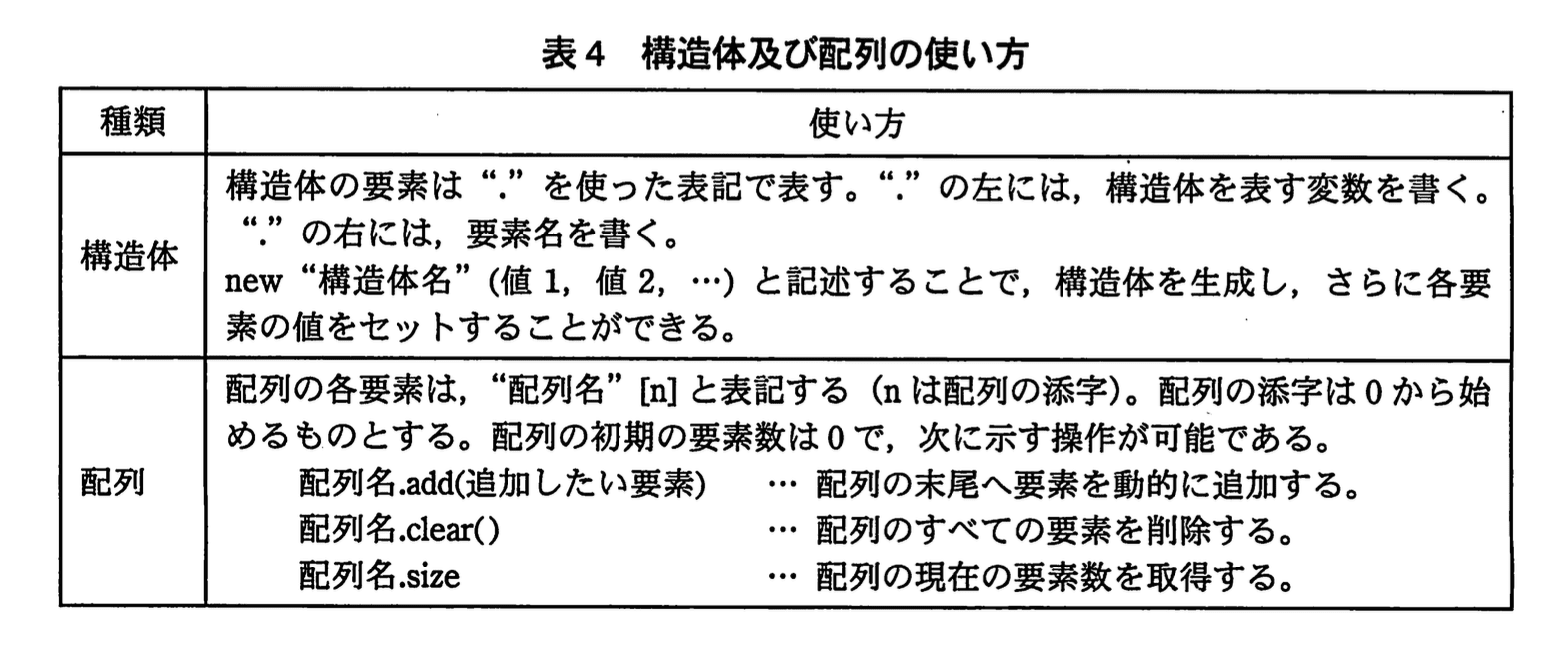
プログラムの処理手順の概要を次の(1)〜(5)に、使用する構造体、配列、変数及び関数の一部を表3に、構造体及び配列の使い方を表4に示す。
(1) CSVファイルを配列CSVArrayに読み込む。
(2) <table>の開始タグ及び集計表のヘッダ行を出力する。
(3) 配列CSVArrayの先頭要素から末尾まで1件ずつ読み、配列shitenArrayに支店名と売上高を追加していく。途中で都道府県が変わった場合、支店名と売上高を追加する前に、①都道府県、支店名、売上高、小計のHTMLタグ及びデータを出力し、配列shitenArrayの全要素を削除する。
(4) ②都道府県、支店名、売上高、小計のHTMLタグ及びデータを出力する。
(5) 合計及び<table>の終了タグを出力する。
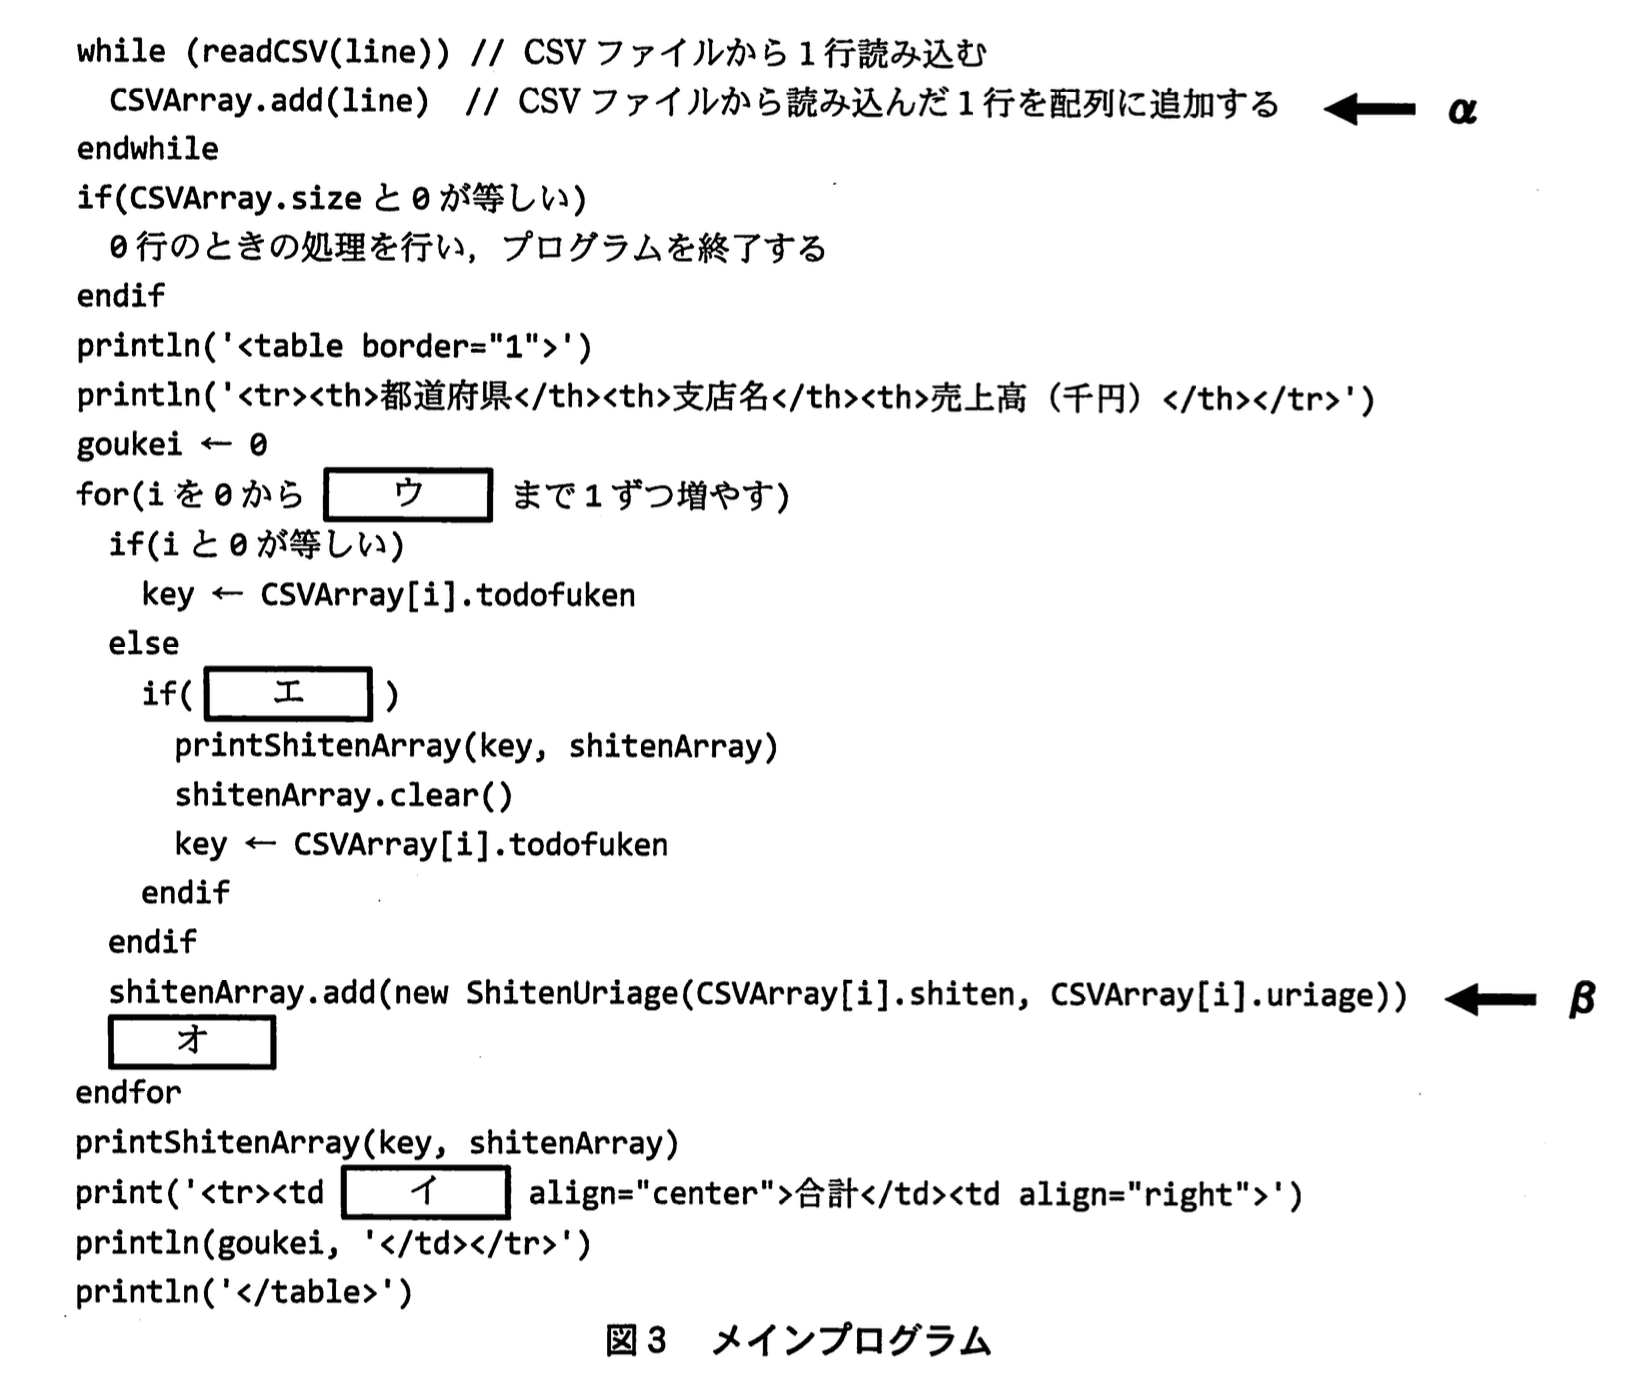
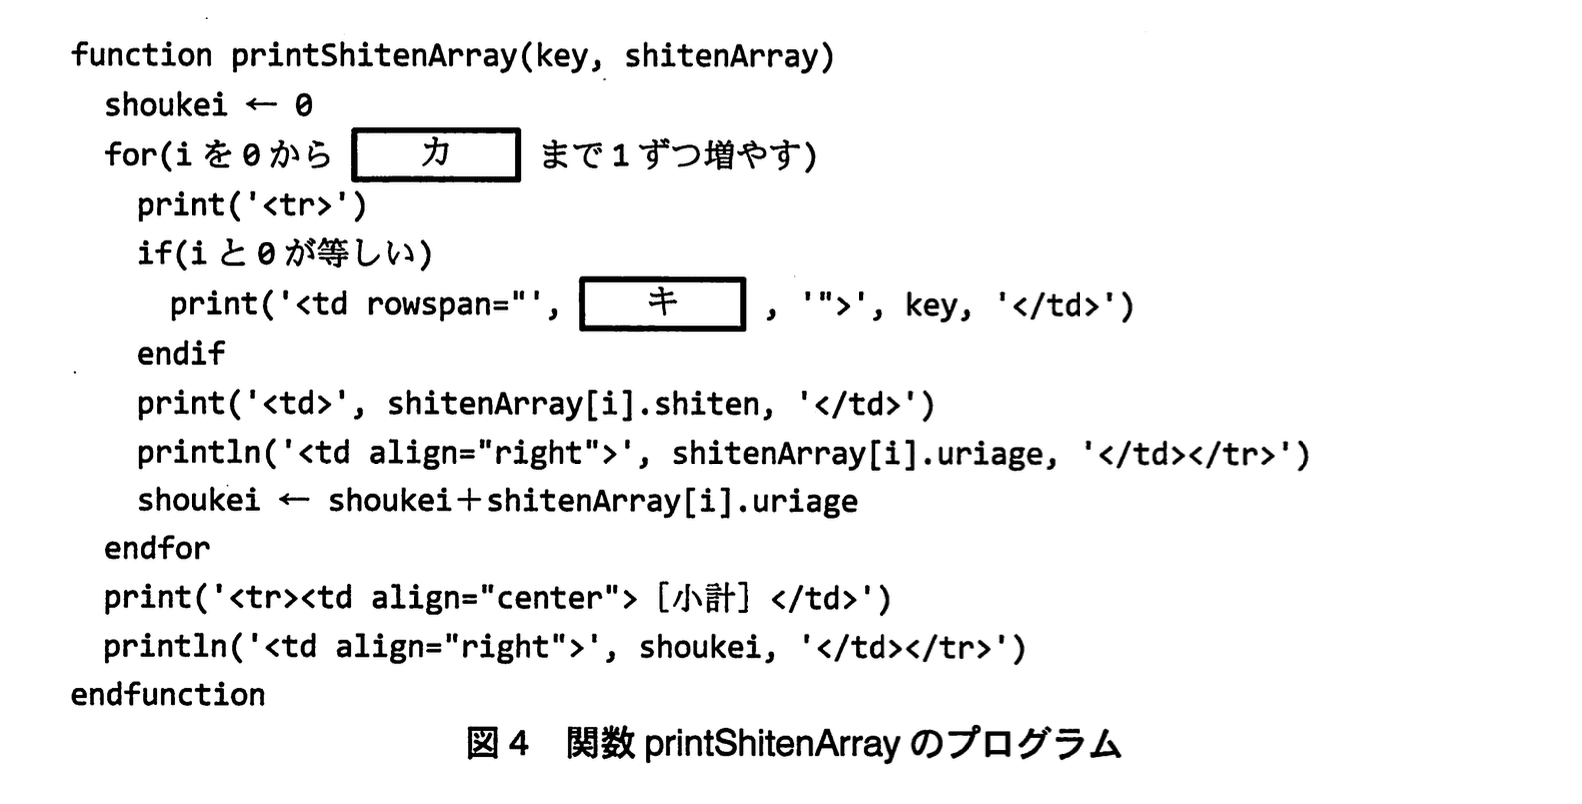
メインプログラムを図3に、関数printShitenArrayのプログラムを図4に示す。ここで、図3の イ には、図2の イ と同じ字句が入る。
〔プログラムに関する考察〕
・図3のαでは、CSVファイルのデータを1行ずつ全行を配列に読み込んでいる。その結果、読み込むデータ量が多いほど、時間だけでなく ク を多く消費してしまう、という問題がある。
・図3のβでは、③都道府県のセルを出力するために、同一都道府県の各支店の情報をその都度出力するのではなく、順次配列shitenArrayに追加している。
設問1:
問題文を見る模範解答
ア:rowspan="4"
イ:colspan="2"
解説
解答の論理構成
-
表1の「東京都」ブロックを確認すると、データ行は
“千代田店”、“中央店”、“港店”、“[小計]” の4行です。
【問題文】では「<td ア>東京都</td>」と示し、同一都道府県で4行を縦に結合する必要があります。HTMLでは縦結合にrowspanを用いるので、ア には
rowspan="4"
が入ります。数字“4”は行数そのものを表しています。 -
「合計」行は、見出し3列(都道府県/支店名/売上高)のうち、最初の2列を横に結合して1セルにまとめています。プログラムの該当部分は
print('<tr><td イ align="center">合計</td><td align="right">')
であり、このあと売上高セルを1つだけ出力しているため、残りの2列を1セルにする必要があります。横結合はcolspanを使うので、イ には
colspan="2"
が入ります。
以上より
ア:rowspan="4"
イ:colspan="2"
ア:rowspan="4"
イ:colspan="2"
誤りやすいポイント
- [小計] 行を数え忘れて「3」としてしまう。rowspanに含める行はデータ行だけでなく小計行も対象です。
- rowspanとcolspanを取り違える。縦結合はrowspan、横結合はcolspanです。
- 「合計」行でcolspan="3" と書いてしまう。実際には売上高列を残すので2列分だけ結合します。
FAQ
Q: 小計行を別の色や太字にしたい場合はどうすればよいですか?
A: <td> にstyle属性やclassを追加し、CSSで装飾します。今回の設問は装飾が要件外なのでalignのみです。
A: <td> にstyle属性やclassを追加し、CSSで装飾します。今回の設問は装飾が要件外なのでalignのみです。
Q: rowspanやcolspanに0を指定できると聞きましたが?
A: HTML5ではrowspan="0" は非推奨です。本設問のように具体的な結合数を明示してください。
A: HTML5ではrowspan="0" は非推奨です。本設問のように具体的な結合数を明示してください。
Q: データ行が500行を超える場合の対策は?
A: 問題設定では「一つの都道府県における支店数は500未満」と明示されています。超えるケースではメモリ使用量やrowspanの数値上限を考慮した分割出力が必要です。
A: 問題設定では「一つの都道府県における支店数は500未満」と明示されています。超えるケースではメモリ使用量やrowspanの数値上限を考慮した分割出力が必要です。
関連キーワード: HTMLテーブル, rowspan, colspan, CSV, 集計処理

設問2:
問題文を見る模範解答
ウ:CSVArray.size - 1
エ:CSVArray[i].todofukenとkeyが等しくない
オ:goukei ← goukei + CSVArray[i].uriage
解説
解答の論理構成
- ループ回数の決定([ウ])
- 原文では「配列 CSVArray の先頭要素から末尾まで1件ずつ読み」とあります。配列の添字は0から始まるので、末尾の添字はCSVArray.size - 1です。したがってforループの上限は 「CSVArray.size - 1」 となります。
- 都道府県が変わったかの判定([エ])
- プログラム概要(3) に「途中で都道府県が変わった場合…」と記されており、現在行のtodofukenと直前に保持しているkeyを比較します。よって条件式は 「CSVArray[i].todofukenとkeyが等しくない」 です。
- 合計値の更新([オ])
- (5) に「合計及び<table>の終了タグを出力する」とあるため、ループ内で売上高を累積する必要があります。売上高は CSVArray[i].uriage に格納されているので、合計変数 goukei に加算する文は 「goukei ← goukei + CSVArray[i].uriage」 です。
以上より、
[ウ] CSVArray.size - 1
[エ] CSVArray[i].todofukenとkeyが等しくない
[オ] goukei ← goukei + CSVArray[i].uriage
[ウ] CSVArray.size - 1
[エ] CSVArray[i].todofukenとkeyが等しくない
[オ] goukei ← goukei + CSVArray[i].uriage
誤りやすいポイント
- 末尾添字の取り違え
sizeとsize - 1を混同し、1件読み飛ばすケースが頻出です。 - 判定対象の変数ミス
keyを更新するタイミングを誤り、同一都道府県内でもprintShitenArrayを呼び出してしまう失敗が見られます。 - 合計計算の位置
小計出力後にgoukeiを加算してしまい、都道府県ごとの小計が二重計上になるミスが起こりやすいです。
FAQ
Q: 都道府県が1つしかない場合でもprintShitenArrayを2回呼び出しますか?
A: 最後の1回だけです。ループ中に都道府県が変わらなければ条件式が偽のままなので、終了後の呼び出し1回で済みます。
A: 最後の1回だけです。ループ中に都道府県が変わらなければ条件式が偽のままなので、終了後の呼び出し1回で済みます。
Q: rowspanの値はどこで決まりますか?
A: printShitenArray内でshitenArray.sizeを利用し、「<td rowspan=...>」 を生成します。これにより支店数に応じて自動的に行結合が行われます。
A: printShitenArray内でshitenArray.sizeを利用し、「<td rowspan=...>」 を生成します。これにより支店数に応じて自動的に行結合が行われます。
Q: メモリ使用量を減らすにはどうすれば良いですか?
A: 考察にある α 部分で全行を保持せず、読み込んだ行を即座に処理・破棄するストリーム方式に変更することで、配列CSVArrayによるメモリ消費を抑制できます。
A: 考察にある α 部分で全行を保持せず、読み込んだ行を即座に処理・破棄するストリーム方式に変更することで、配列CSVArrayによるメモリ消費を抑制できます。
関連キーワード: 配列操作, ループ制御, 条件分岐, HTMLテーブル, メモリ効率
設問3:
問題文を見る模範解答
カ:shitenArray.size - 1
キ:shitenArray.size + 1
解説
解答の論理構成
-
ループ回数の決定
-
rowspan値の決定
- 都道府県セルは「支店行+小計行」の行数分だけ縦方向に連結します。
- 支店行の数は shitenArray.size、小計行は常に1行なので、総行数は
shitenArray.size + 1。 - 図4の
print('<td rowspan=" キ ">', key, '</td>')
にはこの総行数を設定する必要があるため、キ = shitenArray.size + 1 となります。
誤りやすいポイント
- カ をshitenArray.sizeとしてしまい、配列の範囲外アクセスを起こす。
- キ をshitenArray.sizeとしてしまい、小計行で都道府県セルが欠落する。
- 行数計算で「小計行」を忘れ、+ 1を付け忘れる。
- .sizeをメソッド呼び出し風に書いてしまい、問題の記法と不一致となる。
FAQ
Q: shitenArray.size - 1と <= を併用しても良いですか?
A: 図4の構文は「から カ まで」と明示されており、境界値を直接指定する形式です。そのためshitenArray.size - 1が最適です。
A: 図4の構文は「から カ まで」と明示されており、境界値を直接指定する形式です。そのためshitenArray.size - 1が最適です。
Q: 都道府県セルを小計行に含めない実装でも正しいのでは?
A: 表1・図2のHTMLでは都道府県セルが小計行にも及んでおり、問題文の要件でも同様です。従ってrowspanは 支店行 + 1が必須となります。
A: 表1・図2のHTMLでは都道府県セルが小計行にも及んでおり、問題文の要件でも同様です。従ってrowspanは 支店行 + 1が必須となります。
Q: rowspanにゼロを指定しても自動調整されませんか?
A: HTML仕様ではrowspan="0" は「残りの行すべてに及ぶ」という意味ですが、問題文は固定値を求めています。設問の意図に沿いshitenArray.size + 1を明示する必要があります。
A: HTML仕様ではrowspan="0" は「残りの行すべてに及ぶ」という意味ですが、問題文は固定値を求めています。設問の意図に沿いshitenArray.size + 1を明示する必要があります。
関連キーワード: rowspan, 配列添字, ループ制御, 動的配列, HTMLテーブル
設問4:〔プログラムに関する考察〕について、(1)、(2)に答えよ。
問題文を見る(1)本文中のクに入れる適切な字句を答えよ。
模範解答
ク:記憶領域 又は メモリ
解説
解答の導き方
- 問題文の該当箇所を確認します。問題文には「図3のαでは、CSVファイルのデータを1行ずつ全行を配列に読み込んでいる。…読み込むデータ量が多いほど、時間だけでなく ク を多く消費してしまう、という問題がある。」とあります。ここで「全行を配列に読み込んでいる」ことがポイントです。
- 図3中の処理を見ると、実際に「CSVArray.add(line) // CSVファイルから読み込んだ1行を配列に追加する ← α」となっており、読み込んだ各行を逐次CSVArrayに蓄えていることが明示されています。
- 配列の動作仕様も参照します。表4には「配列名.add(追加したい要素) … 配列の末尾へ要素を動的に追加する」とあります。配列に要素を追加し続けると、その分だけ実行中のプログラムが保持する記憶量が増えます。
- したがって「時間だけでなく」の後に入る語は、プログラムが大量データを読み込むことで増大する「保持する記憶量」を指す語であるのが自然です。表現としては「記憶領域」または「メモリ」が適切です。
- 補足(誤解しやすい点の明確化):読み込むデータ量が増えれば読み取りバイト数(ディスクからのI/O)も増加しますが、この設問で問題にしているのは「全データを配列に入れて保持することで消費される資源」であり、ここでは主に主記憶(メモリ)が増える点が問われています。
結論(解答):ク:記憶領域 又は メモリ
誤りやすいポイント
- 「ディスク容量」や「外部記憶領域」を入れてしまう:ファイルのサイズが大きくなるとディスクI/Oや保存容量に影響しますが、図3のαは読み込んだデータを配列に保持している点が焦点です。
- 「CPU(処理能力)」を入れてしまう:時間(実行時間)とは別に問われている資源は「保持する量」であり、CPUは該当しにくいです。
- CSVArrayとshitenArrayを混同する:shitenArrayは都道府県ごとにクリアしているので小さく保てますが、CSVArrayは全行を貯めるためメモリ消費が問題になります。
- 問題文の「時間だけでなく」を見落として「時間=CPU」とだけ考えてしまう点。時間以外のリソース(ここでは記憶領域)を問う設問です。
FAQ
Q: 「記憶領域」と「メモリ」はどちらを書けばよいですか?
A: 両方とも許容されます。出題意図は「プログラム実行中に保持するデータ量が増える」ことなので、「記憶領域」または「メモリ(主記憶)」が適切です。
A: 両方とも許容されます。出題意図は「プログラム実行中に保持するデータ量が増える」ことなので、「記憶領域」または「メモリ(主記憶)」が適切です。
Q: ファイルを全部読み込むとディスクI/Oは増えませんか?
A: 増えます。読み込むバイト数が増えればディスクから読む回数や量は増えます。ただし設問は「時間だけでなく○○を多く消費する」として、CSVArrayに全行を保持することで増大する資源を問うており、ここでは主に主記憶(メモリ)を指します。
A: 増えます。読み込むバイト数が増えればディスクから読む回数や量は増えます。ただし設問は「時間だけでなく○○を多く消費する」として、CSVArrayに全行を保持することで増大する資源を問うており、ここでは主に主記憶(メモリ)を指します。
Q: メモリ消費を抑える実装上の対策は?
A: 全行を保持せず、都道府県ごとに読みながら処理して出力する(ストリーミング処理)か、図3→図3のβのようにshitenArrayだけを都道府県単位で保持して都道府県切替時に出力・クリアする方法が有効です。
A: 全行を保持せず、都道府県ごとに読みながら処理して出力する(ストリーミング処理)か、図3→図3のβのようにshitenArrayだけを都道府県単位で保持して都道府県切替時に出力・クリアする方法が有効です。
関連キーワード: 主記憶、メモリ使用量、配列、外部記憶装置、入出力
設問4:〔プログラムに関する考察〕について、(1)、(2)に答えよ。
問題文を見る(2)本文中の下線③のように処理する理由を、HTMLタグ及びその属性を用いて、40字以内で述べよ。
模範解答
HTMLタグ<td>のrowspan属性の値を決める必要があるから
解説
解答の論理構成
- プログラムは「③都道府県のセルを出力するために、同一都道府県の各支店の情報をその都度出力するのではなく、順次配列shitenArrayに追加している」と記述されています。
- その理由は、図2の都道府県セルが複数行にまたがる設計だからです。HTMLではセル結合を行う際、<td>タグのrowspan属性にまたがる行数を指定する必要があります。
- 行数は「一つの都道府県における支店数は500未満」と問題文にあるように可変であり、CSVを読み終えるまで確定できません。
- したがって、まず支店レコードをshitenArrayへ蓄積し、総件数を把握したうえで<td rowspan="n">都道府県</td>を出力する――これが下線③の処理方針です。
- 以上より、模範解答「HTMLタグ<td>のrowspan属性の値を決める必要があるから」となります。
誤りやすいポイント
- <td>ではなく<th>のrowspanと誤記する。
- colspanと混同し、横方向の結合と勘違いする。
- 先に都道府県セルを出力してしまい、後から正しいrowspan値に修正できなくなるロジックを組む。
- 「支店数が500未満だから固定値でよい」と早合点して配列蓄積を省略する。
FAQ
Q: rowspan値は必ず支店数と一致させないといけませんか?
A: はい。同一都道府県内で何行分の支店情報が続くかを正確に指定しないと、HTMLテーブルの構造が崩れます。
A: はい。同一都道府県内で何行分の支店情報が続くかを正確に指定しないと、HTMLテーブルの構造が崩れます。
Q: rowspanを動的に計算せずに最大値で埋めても表示されますか?
A: 非表示セルも生成されるため見た目は乱れ、空行が増えるなど可読性が損なわれます。仕様上も誤りです。
A: 非表示セルも生成されるため見た目は乱れ、空行が増えるなど可読性が損なわれます。仕様上も誤りです。
Q: shitenArray.clear()はいつ呼ばれますか?
A: 都道府県が変わった瞬間に小計行を含めて出力し終えた後、次の都道府県の支店情報を格納するために呼ばれます。
A: 都道府県が変わった瞬間に小計行を含めて出力し終えた後、次の都道府県の支店情報を格納するために呼ばれます。
関連キーワード: HTMLテーブル, rowspan, 動的行結合, 配列バッファリング, セル結合

