
応用情報技術者 2012年 春期 午後 問02
文字列を圧縮するアルゴリズムに関する次の記述を読んで、設問1~4に答えよ。
データを圧縮するアルゴリズムの一つにランレングス法がある。ランレングス法とは、同じデータが連続して現れる箇所を、そのデータと連続している回数との組に変換する方法である。文字 "a"~"z" だけから成る文字列を圧縮する方法として、圧縮の表現形式の違う二つのプログラムを比較検討する。
圧縮前と圧縮後のデータを管理する方法として配列を用いる。配列の各要素には、文字データの場合は8ビット表現の文字コードが、数値データの場合は0〜255の整数が格納される。圧縮前の配列をin、圧縮後の配列をoutとする。配列inの大きさは文字列の長さと等しく、2以上、255以下である。配列outには圧縮後のデータを格納する十分な領域が確保されている。配列の添字は0から始まる。
〔圧縮方法その1〕
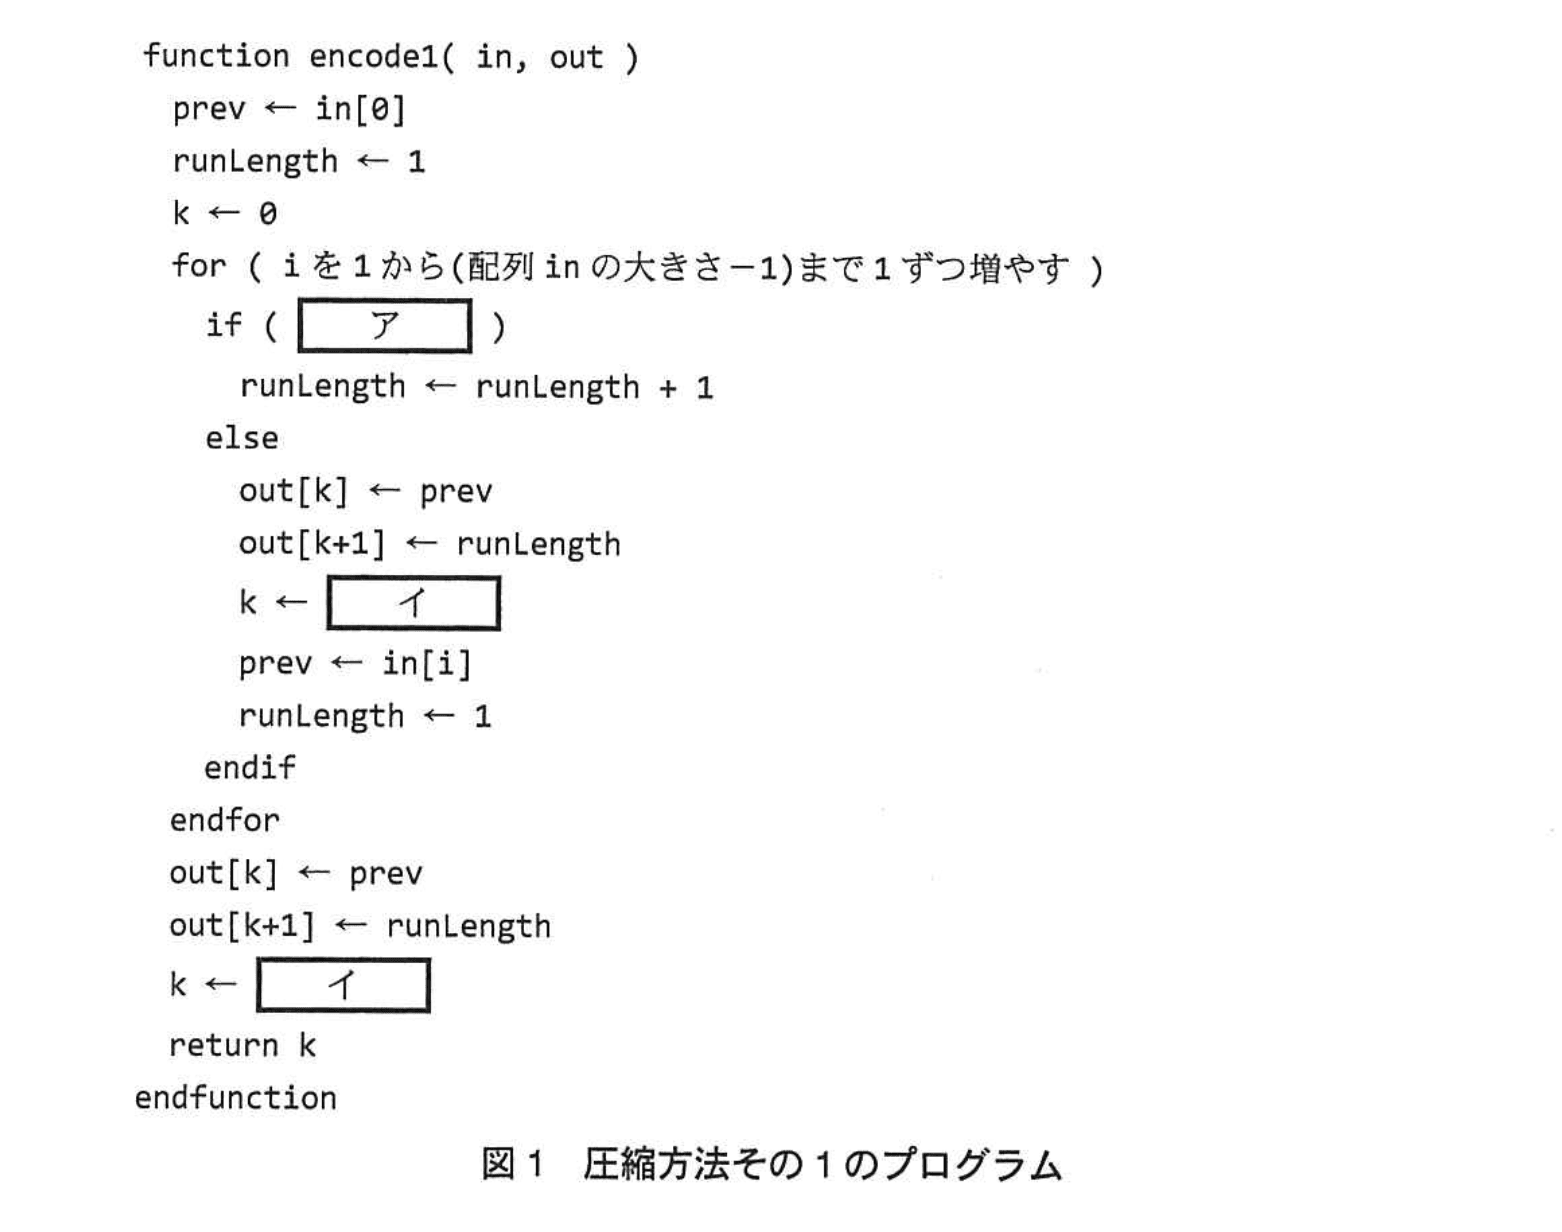
圧縮の表現形式として、[圧縮対象文字][連続回数]を用いる方法の処理手順を次の(1)~(5)に、そのプログラムを図1に示す。例えば、文字列“abbcccddddeeeee”を圧縮すると、a1b2c3d4e5となる。ここで、a~zは文字データを表し、数字は対応する数値データを表す。
(1) 配列inの初めの1文字を変数prevに取り出す。連続回数を1にする。
(2) 配列inから次の1文字を取り出し、変数prevと比較する。配列inから取り出す文字がない場合、処理手順(5)へ進む。
(3) 比較した二つの文字が等しい場合、連続回数に1を加える。等しくない場合、変数prevと連続回数を配列outに追加し、(2)で取り出した文字を変数prevにコピーして、連続回数を1に戻す。
(4) 処理手順(2)に戻る。
(5) 変数prevと連続回数を配列outに追加する。
図1中の関数encode1はプログラムのメイン処理であり、配列outに追加されたデータの大きさを返す。
〔圧縮方法その2〕
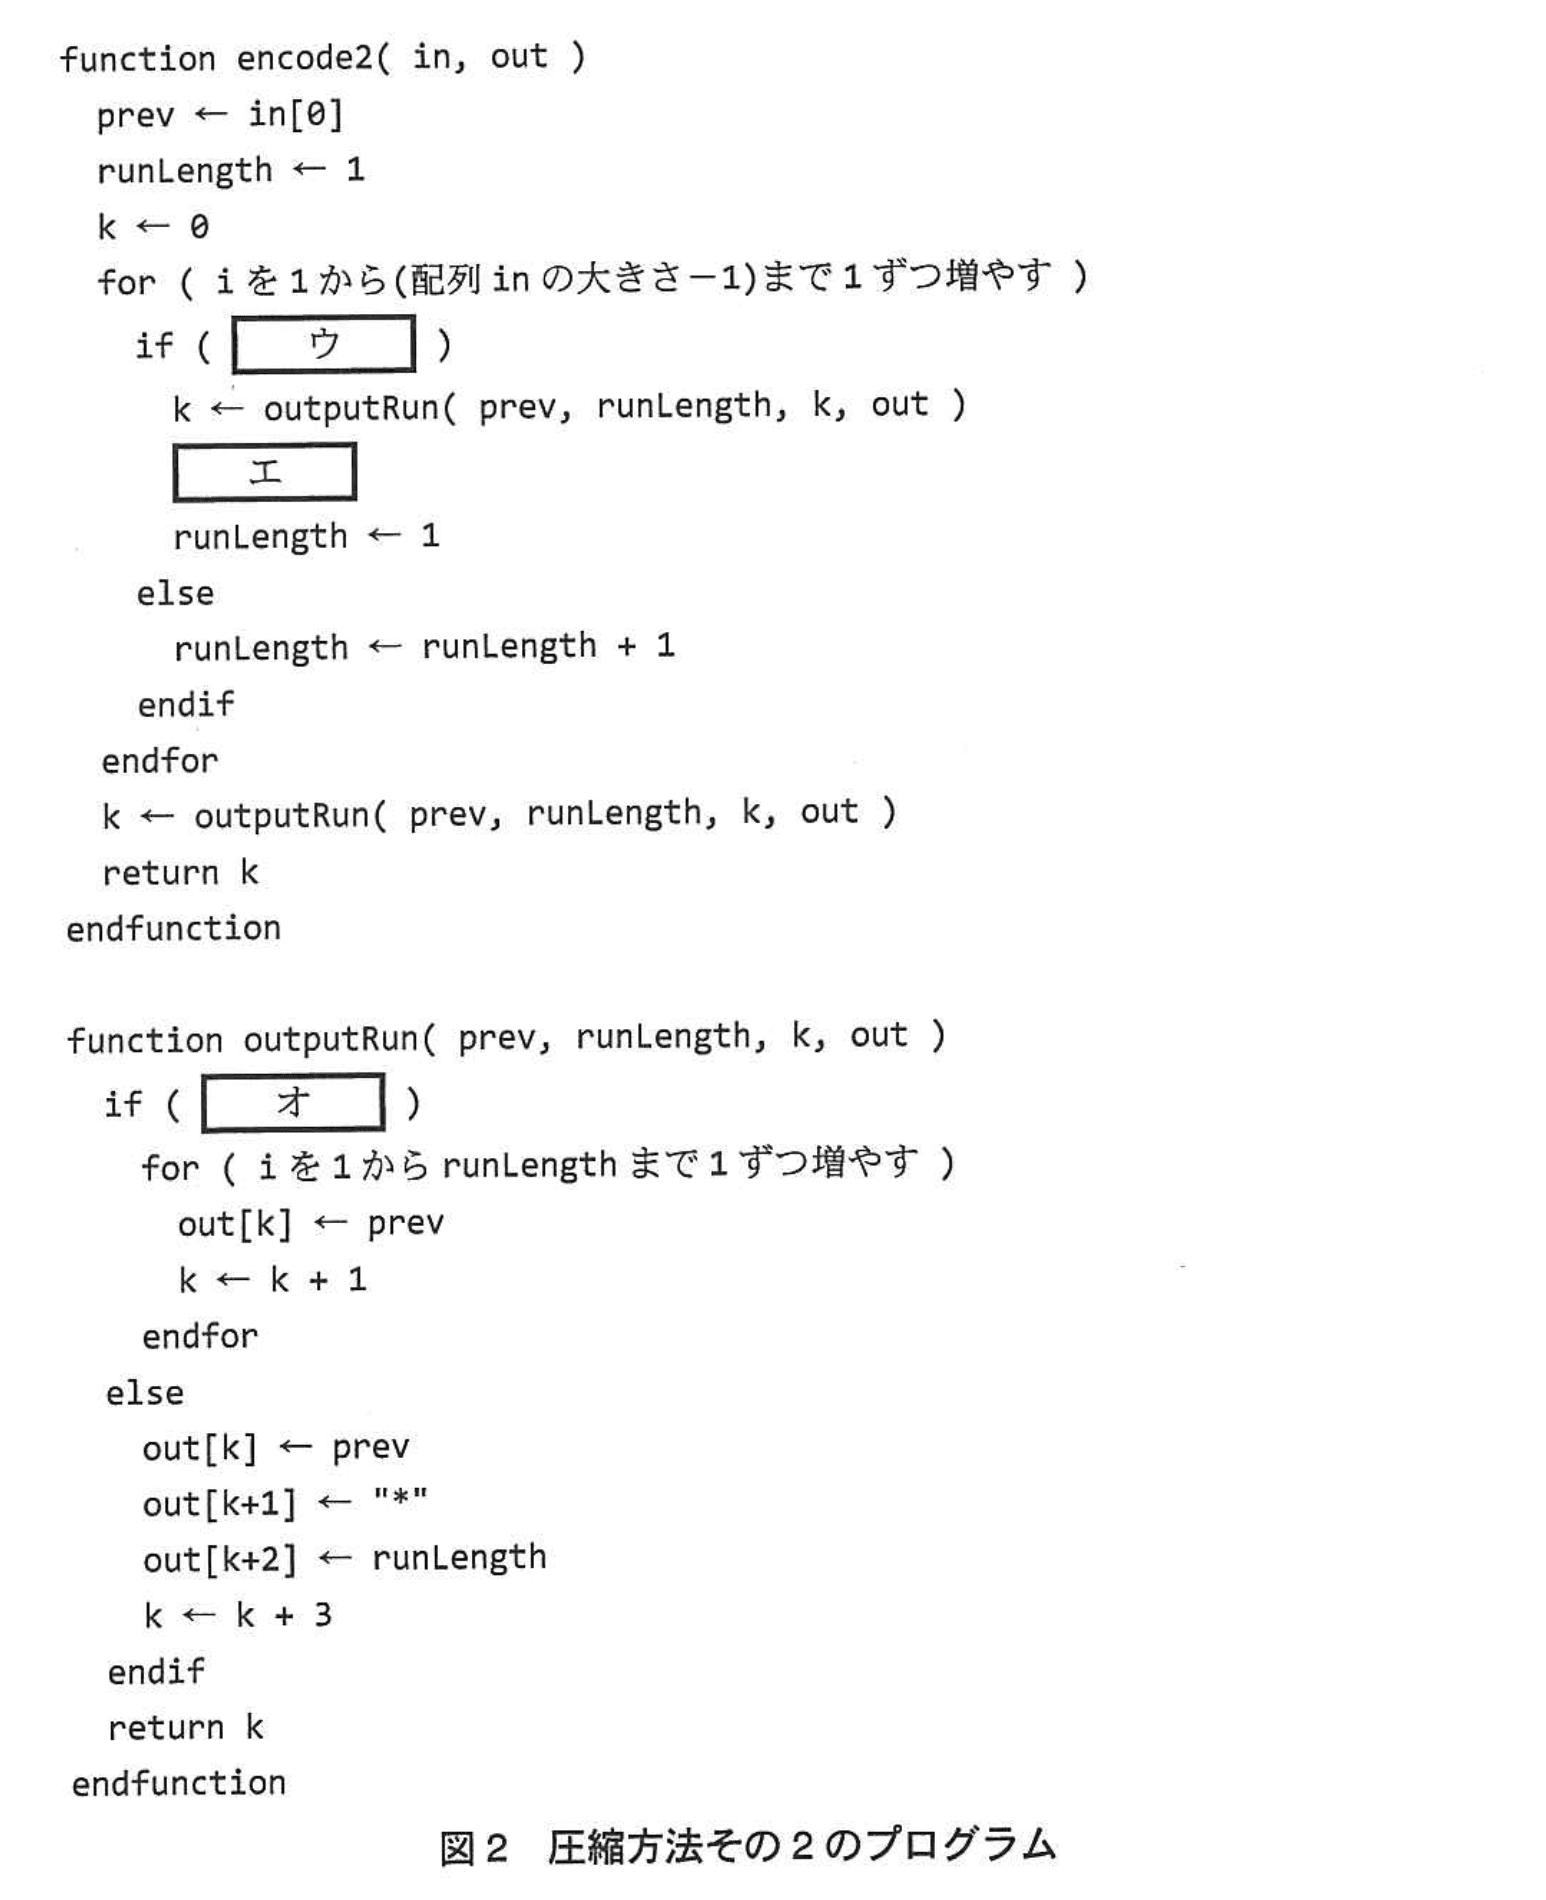
圧縮の表現形式として、同じ文字が4回以上連続する場合に[圧縮対象文字][圧縮表現文字][連続回数]を用い、3回以下の場合はそのままとする方法の処理手順を次の(1)〜(5)に、そのプログラムを図2に示す。圧縮表現文字には、圧縮対象文字と区別するために、圧縮対象文字として使用されない文字を使う。ここでは“*”を圧縮表現文字とする。例えば、文字列“abbcccddddeeeee”を圧縮すると、abbcccd*4e*5となる。
(1) 配列inの初めの1文字を変数prevに取り出す。連続回数を1にする。
(2) 配列inから次の1文字を取り出し、変数prevと比較する。配列inから取り出す文字がない場合、処理手順(5)へ進む。
(3) 比較した二つの文字が等しくない場合、変数prevの連続回数だけの繰返しを表す圧縮表現を配列outに追加し、(2)で取り出した文字を変数prevにコピーして、連続回数を1に戻す。等しい場合、連続回数に1を加える。
(4) 処理手順(2)に戻る。
(5) 変数prevの連続回数だけの繰返しを表す圧縮表現を配列outに追加する。
図2中の関数encode2はプログラムのメイン処理であり、配列outに追加されたデータの大きさを返す。関数outputRunは、prevがrunLength回繰り返すことを表す圧縮表現を配列outの添字kの位置に追加し、次の追加位置を返す。
〔プログラムに関する考察〕
二つの圧縮方法におけるデータ圧縮の効果について考える。
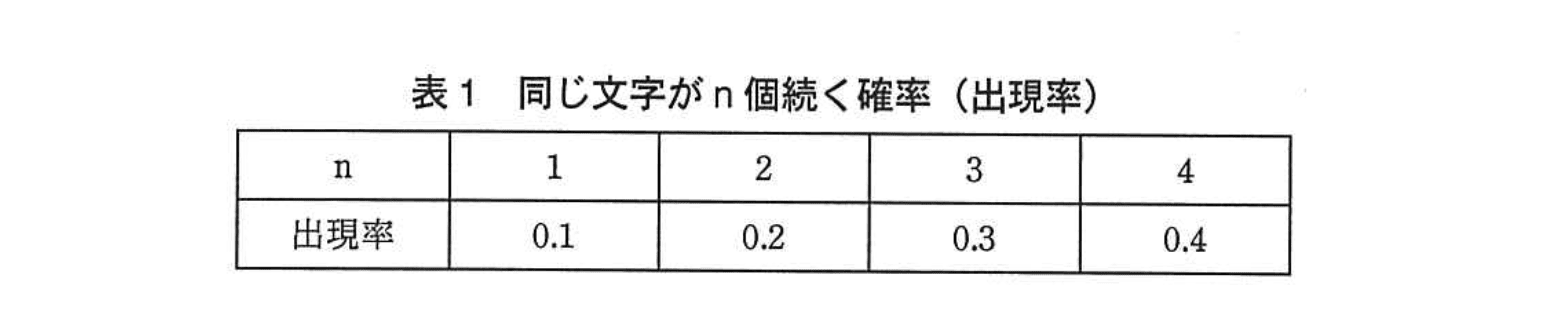
いま、同じ文字がn個続く確率(出現率)を表1のとおり仮定する。例えば、配列inの大きさが100の場合、1割の10文字が連続しない一つの文字として存在する。また、4割の40文字が4個連続する文字の割合である。このとき、4個連続している文字列は10組となる。
圧縮後のデータの大きさを圧縮前のデータの大きさで割った値を圧縮比と定義すると、この表1の場合、〔圧縮方法その1〕での圧縮比は カ 、〔圧縮方法その2〕での圧縮比は キ と算出できる。
〔圧縮方法その1〕の場合、圧縮対象のデータによっては、圧縮後のデータが圧縮前より大きくなってしまうことがある。①最悪の場合には、圧縮比は ク となってしまう。
設問1:文字列“xyyyzzzzxxyzzzzz”の圧縮について、(1)、(2)に答えよ。
問題文を見る(1)〔圧縮方法その1〕によって圧縮した結果を答えよ。
模範解答
x1y3z4x2y1z5
解説
解答の論理構成
- まず圧縮アルゴリズムは、問題文の〔圧縮方法その1〕で示された
「同じデータが連続して現れる箇所を、そのデータと連続回数との組に変換する方法」です。具体的な手順は次の引用どおりです。
・「(1) 配列inの初めの1文字を変数prevに取り出す。連続回数を1にする。」
・「(2) 配列inから次の1文字を取り出し、変数prevと比較する。」
・「(3) …等しくない場合、変数prevと連続回数を配列outに追加し、…連続回数を1に戻す。」
・「(5) 変数prevと連続回数を配列outに追加する。」 - 文字列“xyyyzzzzxxyzzzzz”に上記手順を適用し、左から順に調べます。
- 末尾まで走査したので手順(5)に従い最後のz5を追加します。
- 以上より、圧縮結果は「x1y3z4x2y1z5」です。
誤りやすいポイント
- 「連続回数が1でも必ず数字を付ける」規則を忘れ、xやyを単体で出力してしまう。
- 途中で連続回数をリセットし忘れ、x2y1のような境目で桁を混同する。
- 末尾処理(手順(5))を抜かし、最後のz5をoutputしない。
FAQ
Q: 連続回数は何ビットで保持しているのですか?
A: 問題文には「数値データの場合は0〜255の整数が格納される」とあるので、1バイト(8ビット)で管理します。
A: 問題文には「数値データの場合は0〜255の整数が格納される」とあるので、1バイト(8ビット)で管理します。
Q: 連続回数が255を超えるケースはどうしますか?
A: 本試験の前提では配列inの大きさが「2以上、255以下」であり、255を超える連続回数は発生しません。
A: 本試験の前提では配列inの大きさが「2以上、255以下」であり、255を超える連続回数は発生しません。
Q: 英小文字以外の文字が来たらどうなりますか?
A: 「文字 'a'~'z' だけから成る文字列を圧縮する」と明示されているため、他の文字は入力されない想定です。
A: 「文字 'a'~'z' だけから成る文字列を圧縮する」と明示されているため、他の文字は入力されない想定です。
関連キーワード: ランレングス法, 可逆圧縮, 連続回数

設問1:文字列“xyyyzzzzxxyzzzzz”の圧縮について、(1)、(2)に答えよ。
問題文を見る(2)〔圧縮方法その2〕によって圧縮した結果を答えよ。
模範解答
xyyyz*4xxyz*5
解説
解答の論理構成
- 圧縮ルールの確認
【問題文】では、〔圧縮方法その2〕を
「同じ文字が 4回以上 連続する場合に 圧縮対象文字、圧縮表現文字“*”、連続回数 を用い、3回以下の場合はそのまま とする」と定義しています。
したがって
• runLength ≥ 4 → 文字 * runLength形式
• runLength ≤ 3 → そのまま出力 - 入力文字列の連続数 (run) を抽出
文字列 “xyyyzzzzxxyzzzzz” を左から確認します。 - 圧縮後文字列の連結
表の出力内容を順に連結すると
“x” + “yyy” + “z*4” + “xx” + “y” + “z*5” = “xyyyz*4xxyz*5” - 以上より、模範解答「xyyyz*4xxyz*5」と一致します。
誤りやすいポイント
- 連続回数 3と4の境界を取り違える
3回連続は非圧縮、4回連続は圧縮です。 - “*”の位置
圧縮時は 圧縮対象文字の直後に“*”を置きます。
(例:zzzz → z*4、×*4zは誤り) - 圧縮後の並び順
生文字と圧縮表現を 出現順にそのまま 連結します。
グループごとに並べ替えてはいけません。
FAQ
Q: “*” 以外の記号は使えますか?
A: 【問題文】に「ここでは“*”を圧縮表現文字とする」と明記されているため、本問では“*”固定です。
A: 【問題文】に「ここでは“*”を圧縮表現文字とする」と明記されているため、本問では“*”固定です。
Q: 連続回数が10を超える場合、2桁の数値はどう書きますか?
A: 〔圧縮方法その2〕では「連続回数」を1バイト整数(0〜255)のままout配列へ格納します。表記上もそのまま2桁以上の数値を後ろに続ければよいです。
A: 〔圧縮方法その2〕では「連続回数」を1バイト整数(0〜255)のままout配列へ格納します。表記上もそのまま2桁以上の数値を後ろに続ければよいです。
Q: 「xxy」と「xx」「y」は結果が違いますか?
A: いいえ。同一ランの区切りは 文字が変わった瞬間 で自動的に決まるため、“xxy”は「xx」と「y」に分割されます。
A: いいえ。同一ランの区切りは 文字が変わった瞬間 で自動的に決まるため、“xxy”は「xx」と「y」に分割されます。
関連キーワード: ランレングス圧縮, 可逆圧縮, 出現頻度, 連続データ, 圧縮比
設問2:
問題文を見る模範解答
ア:in[i]とprevが等しい
イ:k+2
解説
解答の論理構成
-
手続き(2)には「配列inから次の1文字を取り出し、変数prevと比較する。」とあります。比較の結果が“等しい”かどうかで処理が分岐するので、図1の判定条件アは
in[i] とprevが等しい
となります。 -
手続き(3)では「変数prevと連続回数を配列outに追加し」とあるので、文字1バイトと回数1バイトの合計2要素を書き込みます。次に追加する位置kは現在位置に2を加えた値になります。したがってイは
k+2
となります。 -
以上より、ア=「in[i]とprevが等しい」、イ=「k+2」と確定します。
誤りやすいポイント
- アを「in[i] ≠ prev」と誤って否定形で書くミス。アルゴリズム説明(2)は“比較”ですが、runLengthを増やすのは一致時です。
- runLengthをoutに書き込む際のデータ数を勘違いし、イを「k+1」や「k+runLength」としてしまうミス。文字と回数は常に2バイト固定です。
- kの更新位置をループの最後でまとめて行うと考え、コードの流れを取り違えるケース。
FAQ
Q: runLengthが256以上になることはありますか?
A: 問題設定では「配列inの大きさは…255以下」と明記されているため、最大でも255で1バイトに収まります。
A: 問題設定では「配列inの大きさは…255以下」と明記されているため、最大でも255で1バイトに収まります。
Q: 文字列がまったく圧縮できない場合でもencode1は正しく動きますか?
A: はい。すべてのrunLengthが1でも、各文字+1の2バイトを書き込むだけなので処理は可能です。
A: はい。すべてのrunLengthが1でも、各文字+1の2バイトを書き込むだけなので処理は可能です。
Q: kを2増やす理由をもう一度教えてください。
A: out配列には「文字コード」と「連続回数」の2要素を連続して格納するため、書き込んだ直後の次の空き位置はk+2となります。
A: out配列には「文字コード」と「連続回数」の2要素を連続して格納するため、書き込んだ直後の次の空き位置はk+2となります。
関連キーワード: ランレングス法, 連長圧縮, 配列操作, インデックス更新, 条件分岐
設問3:
問題文を見る模範解答
ウ:in[i]とprevが等しくない
エ:prev ← in[i]
オ:runLengthが3以下
解説
解答の論理構成
-
圧縮方法その2の処理手順(3)には
“比較した二つの文字が等しくない場合、変数prevの連続回数だけの繰返しを表す圧縮表現を配列outに追加し、(2)で取り出した文字を変数prevにコピーして、連続回数を1に戻す”
とあります。「等しくない場合」に処理を行うので、forループの判定 ウ は
“in[i]とprevが等しくない”
となります。 -
同じ手順(3)の後半に “(2)で取り出した文字を変数prevにコピー” とあるため、エ には
“prev ← in[i]”
が入ります。 -
関数outputRunの仕様は “prevがrunLength回繰り返すことを表す圧縮表現を配列outの添字kの位置に追加し、次の追加位置を返す” です。
圧縮方式の説明では “同じ文字が4回以上連続する場合に圧縮対象文字、圧縮表現文字、連続回数を用い、3回以下の場合はそのままとする” と明記されています。したがって オ は
“runLengthが3以下”
のとき元のまま出力し、それ以外(4以上)のときに “圧縮対象文字, ‘*’, 連続回数” の3バイトで出力すれば仕様と一致します。
よって模範解答
ウ:in[i]とprevが等しくない
エ:prev ← in[i]
オ:runLengthが3以下
が成立します。
ウ:in[i]とprevが等しくない
エ:prev ← in[i]
オ:runLengthが3以下
が成立します。
誤りやすいポイント
- “圧縮対象文字, ‘*’, 連続回数” という3バイト形式は “4回以上” のみで採用されることを見落とし、オ を “runLengthが4以上” と逆にしてしまう。
- encode1の “[ア]” と同じ感覚でencode2も “等しい場合” にifブロックへ入ると誤解し、ウ を “in[i]とprevが等しい” と書いてしまう。
- runLengthをリセットする位置を誤り、エ をforループの先頭や末尾に書いてしまう。
FAQ
Q: encode1とencode2のif条件が逆転しているのはなぜですか?
A: encode1は “連続回数の増加” をifブロックにまとめているのに対し、encode2は “runを確定させて出力する” 動作をifブロックに置いているためです。この設計に合わせて条件式も逆になります。
A: encode1は “連続回数の増加” をifブロックにまとめているのに対し、encode2は “runを確定させて出力する” 動作をifブロックに置いているためです。この設計に合わせて条件式も逆になります。
Q: なぜ “3回以下” をそのまま出力した方が良いのですか?
A: 圧縮形式にすると “圧縮対象文字+‘*’+連続回数” の3バイトが必要です。3回なら元のデータ量も3バイトで同じ、1~2回ならむしろ増えるため、効率の観点で4回以上のみ圧縮します。
A: 圧縮形式にすると “圧縮対象文字+‘*’+連続回数” の3バイトが必要です。3回なら元のデータ量も3バイトで同じ、1~2回ならむしろ増えるため、効率の観点で4回以上のみ圧縮します。
Q: 出力時に文字コードと数字を同じ配列に入れていますが衝突しませんか?
A: 問題文に “配列の各要素には、文字データの場合は8ビット表現の文字コードが、数値データの場合は0〜255の整数が格納される” とある通り、要素はバイト単位で管理されており、文字コードと数値は同じ1バイト領域に格納できる想定です。
A: 問題文に “配列の各要素には、文字データの場合は8ビット表現の文字コードが、数値データの場合は0〜255の整数が格納される” とある通り、要素はバイト単位で管理されており、文字コードと数値は同じ1バイト領域に格納できる想定です。
関連キーワード: ランレングス法, 可逆圧縮, 連続データ, 圧縮比
設問4:〔プログラムに関する考察〕について、(1)、(2)に答えよ。
問題文を見る(1)カ~クに入れる適切な数値を答えよ。
模範解答
カ:0.8
キ:0.9
ク:2
解説
解答の論理構成
-
圧縮比の定義を確認
【問題文】に「圧縮後のデータの大きさを圧縮前のデータの大きさで割った値を圧縮比と定義」とある。したがって、各ラン長nについて
圧縮比 = 圧縮後サイズ ÷ 圧縮前サイズ
と置き、表1の出現率を重みとして期待値を取れば全体の圧縮比が得られる。 -
〔圧縮方法その1〕の圧縮後サイズ
同じ文字がn個続くデータをこの方式で表すと、
・圧縮対象文字:1バイト
・連続回数 :1バイト
の合計2バイトになる。
圧縮前サイズはnバイトなので、
圧縮比( n ) = 2 / n -
表1の重み付け平均
表1には「n=1:0.1, n=2:0.2, n=3:0.3, n=4:0.4」とある。
よって
0.1×2/1 + 0.2×2/2 + 0.3×2/3 + 0.4×2/4
= 0.2 + 0.2 + 0.2 + 0.2 = 0.8
したがって カ = 0.8。 -
〔圧縮方法その2〕の圧縮後サイズ
【問題文】に「同じ文字が4回以上連続する場合に…圧縮対象文字、圧縮表現文字、連続回数を用い、3回以下の場合はそのまま」とある。
・n = 1, 2, 3のとき:圧縮後サイズ = n
・n ≥ 4のとき(今回n = 4のみ):圧縮後サイズ = 3バイト
よって
圧縮比(1) = 1/1 = 1
圧縮比(2) = 2/2 = 1
圧縮比(3) = 3/3 = 1
圧縮比(4) = 3/4 = 0.75 -
再び重み付け平均
0.1×1 + 0.2×1 + 0.3×1 + 0.4×0.75
= 0.1 + 0.2 + 0.3 + 0.3 = 0.9
したがって キ = 0.9。 -
〔圧縮方法その1〕の最悪の場合
圧縮後サイズは常に2バイト、圧縮前サイズはnバイトなので
圧縮比 = 2 / n
が最大になるのはn = 1(すべてがバラバラの文字列)であり、
最大圧縮比 = 2 / 1 = 2
したがって ク = 2。
誤りやすいポイント
- 出現率を「個数」ではなく「確率」として扱う計算を忘れ、単純に足し算してしまう。
- 〔圧縮方法その2〕でn = 4を4バイトと勘違いし、「文字+'*'+回数」を4バイトと誤認する。
- 最悪ケース解析でn = 0やn = 255など現実に現れない値を当てはめてしまう。
FAQ
Q: 出現率がn > 4にもある場合はどう計算しますか?
A: 各nごとに「圧縮後サイズ/n」を求め、表と同じように確率を掛けて総和を取るだけです。圧縮式が変わらない範囲なら計算手順は同じです。
A: 各nごとに「圧縮後サイズ/n」を求め、表と同じように確率を掛けて総和を取るだけです。圧縮式が変わらない範囲なら計算手順は同じです。
Q: 〔圧縮方法その2〕で '*' 以外の記号を使ったら圧縮比は変わりますか?
A: 文字コード1バイトで表せる記号であればサイズは1バイトなので圧縮比は変わりません。重要なのは「圧縮表現文字が1バイトである」点です。
A: 文字コード1バイトで表せる記号であればサイズは1バイトなので圧縮比は変わりません。重要なのは「圧縮表現文字が1バイトである」点です。
Q: ランレングス法は必ず圧縮率が1未満になりますか?
A: いいえ。同じ文字の連続が短いデータ(今回の最悪ケースn = 1など)では逆にデータが増え、圧縮比が1より大きくなることがあります。
A: いいえ。同じ文字の連続が短いデータ(今回の最悪ケースn = 1など)では逆にデータが増え、圧縮比が1より大きくなることがあります。
関連キーワード: ランレングス圧縮, 圧縮比, 期待値計算, 最悪ケース解析, 可逆圧縮
設問4:〔プログラムに関する考察〕について、(1)、(2)に答えよ。
問題文を見る(2)本文中の下線①とは、どのような場合か、20字以内で答えよ。
模範解答
同じ文字が連続することがない場合
解説
解答の論理構成
- 問題文では、〔圧縮方法その1〕が「[圧縮対象文字][連続回数]」という2バイト固定フォーマットであると説明しています。
引用:
「圧縮の表現形式として、[圧縮対象文字][連続回数]を用いる方法」 - 1文字しか連続しない場合でも必ず2バイトを出力します。
つまり、元データ1バイト → 圧縮後2バイトとなり、データ量が倍増します。 - 問題文の下線付き記述
「〔圧縮方法その1〕の場合、圧縮対象のデータによっては、圧縮後のデータが圧縮前より大きくなってしまうことがある。①最悪の場合」
では、最もデータが増えるケースを尋ねています。 - 圧縮効果が最も悪いのは「同じ文字が一切続かない」=“全て1個ずつ”のケースです。
このとき配列inの各要素はすべて別文字として扱われ、2バイト×文字数となり圧縮比は最大になります。 - 以上より、下線①が示すケースは
「同じ文字が連続することがない場合」
が妥当です。
誤りやすいポイント
- 「出現率0.1」の行だけに着目し、1個連続するケースと誤って限定する。実際には100%が1個連続になる極端例が最悪。
- 〔圧縮方法その2〕と混同し、“4個未満で展開される”条件を引用してしまう。
- 「最悪=圧縮率が最低(最も小さい)」と勘違いし、逆に完全一致の長いランを答えてしまう。
FAQ
Q: なぜ2個続く場合は最悪ではないのですか?
A: 2個続くと2文字が2バイトで表現されるため、元の2バイトと同じサイズになります。1個続くと1→2バイトとなり、データが増える分だけより悪化します。
A: 2個続くと2文字が2バイトで表現されるため、元の2バイトと同じサイズになります。1個続くと1→2バイトとなり、データが増える分だけより悪化します。
Q: 〔圧縮方法その1〕でラン長を1バイトにした理由は?
A: 問題文に「数値データの場合は0〜255の整数が格納される」とあるため、1〜255回まで1バイトで表せるという前提で設計されています。
A: 問題文に「数値データの場合は0〜255の整数が格納される」とあるため、1〜255回まで1バイトで表せるという前提で設計されています。
Q: この最悪ケースは実運用でも問題になりますか?
A: ランレングス法は同一データが長く続くほど効果を発揮し、散在データでは逆効果になるため、画像の単色領域やログなど用途を選んで使うのが一般的です。
A: ランレングス法は同一データが長く続くほど効果を発揮し、散在データでは逆効果になるため、画像の単色領域やログなど用途を選んで使うのが一般的です。
関連キーワード: ランレングス圧縮, 圧縮比, ワーストケース, データ冗長性, 出現確率

