
応用情報技術者 2022年 春期 午後 問03
パズルの解答を求めるプログラムに関する次の記述を読んで、設問1~3に答えよ。
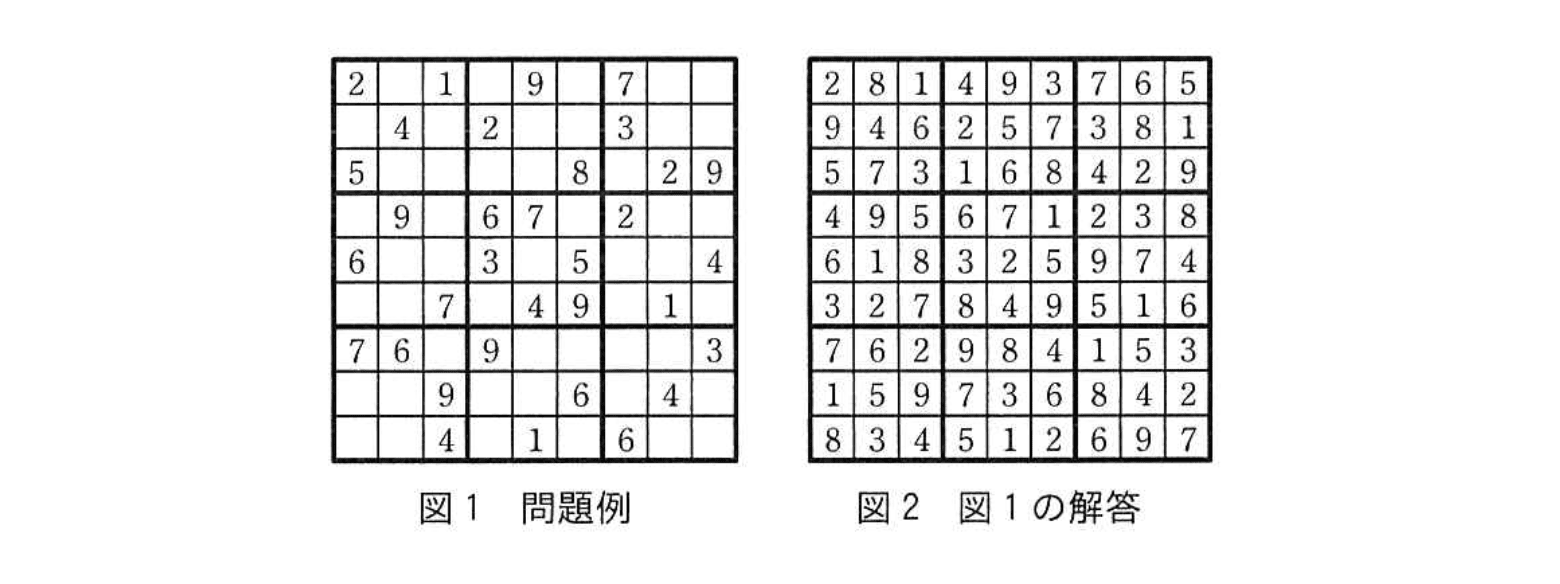
太線で3×3の枠に区切られた9×9のマスから成る正方形の盤面に、1~9の数字を入れるパズルの解答を求めるプログラムを考える。このパズルは、図1に示すように幾つかのマスに数字が入れられている状態から、数字の入っていない各マスに、1~9のうちのどれか一つの数字を入れていく。このとき、盤面の横1行、縦1列、及び太線で囲まれた3×3の枠内の全てにおいて、1~9の数字が一つずつ入ることが、このパズルのルールである。パズルの問題例を図1に、図1の解答を図2に示す。
このパズルを解くための方針を次に示す。
この方針に沿ってパズルを解く手順を考える。
〔パズルを解く手順〕
(1) 盤面の左上端から探索を開始する。マスは左端から順に右方向に探索し、右端に達したら一行下がり、左端から順に探索する。
(2) 空白のマスを見つける。
(3) (2) で見つけた空白のマスに、1~9の数字を順番に入れる。
(4) 数字を入れたときに、その状態がパズルのルールにのっとっているかどうかをチェックする。
(4-1) ルールにのっとっている場合は、(2)に進んで次の空白のマスを見つける。
(4-2) ルールにのっとっていない場合は、(3)に戻って次の数字を入れる。このとき、入れる数字がない場合には、マスを空白に戻して一つ前に数字を入れたマスに戻り、(3)から再開する。
(5) 最後のマスまで数字が入り、空白のマスがなくなったら、それが解答となる。
〔盤面の表現〕
この手順をプログラムに実装するために、9×9の盤面を次のデータ構造で表現することにした。
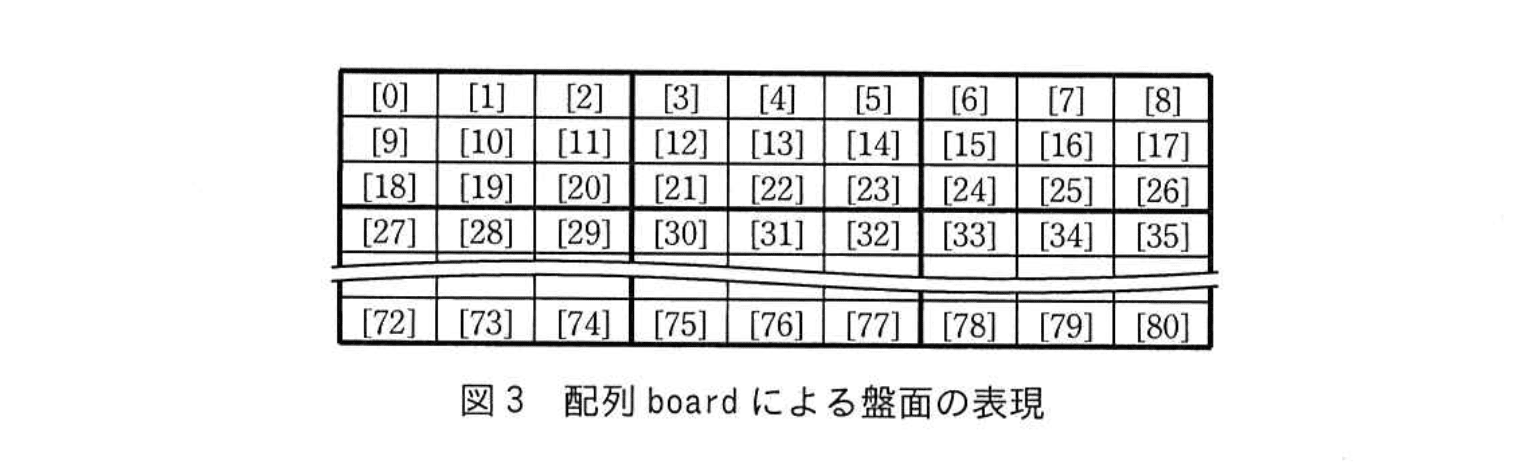
・9×9の盤面を81個の要素をもつ1次元配列boardで表現する。添字は0から始まる。各要素にはマスに入れられた数字が格納され、空白の場合は0を格納する。
配列boardによる盤面の表現を図3に示す。ここで括弧内の数字は配列boardの添字を表す。
〔ルールのチェック方法〕
パズルのルールにのっとっているかどうかのチェックでは、数字を入れたマスが含まれる横1行の左端のマス、縦1列の上端のマス、3×3の枠内の左上端のマスを特定し、行、列、枠内のマスに既に格納されている数字と、入れた数字がそれぞれ重複していないことを確認する。このチェックを“重複チェック”という。
〔解法のプログラム〕
プログラムで使用する配列、関数、変数及び定数の一部を表1に示す。なお、表1の配列及び変数は大域変数とする。
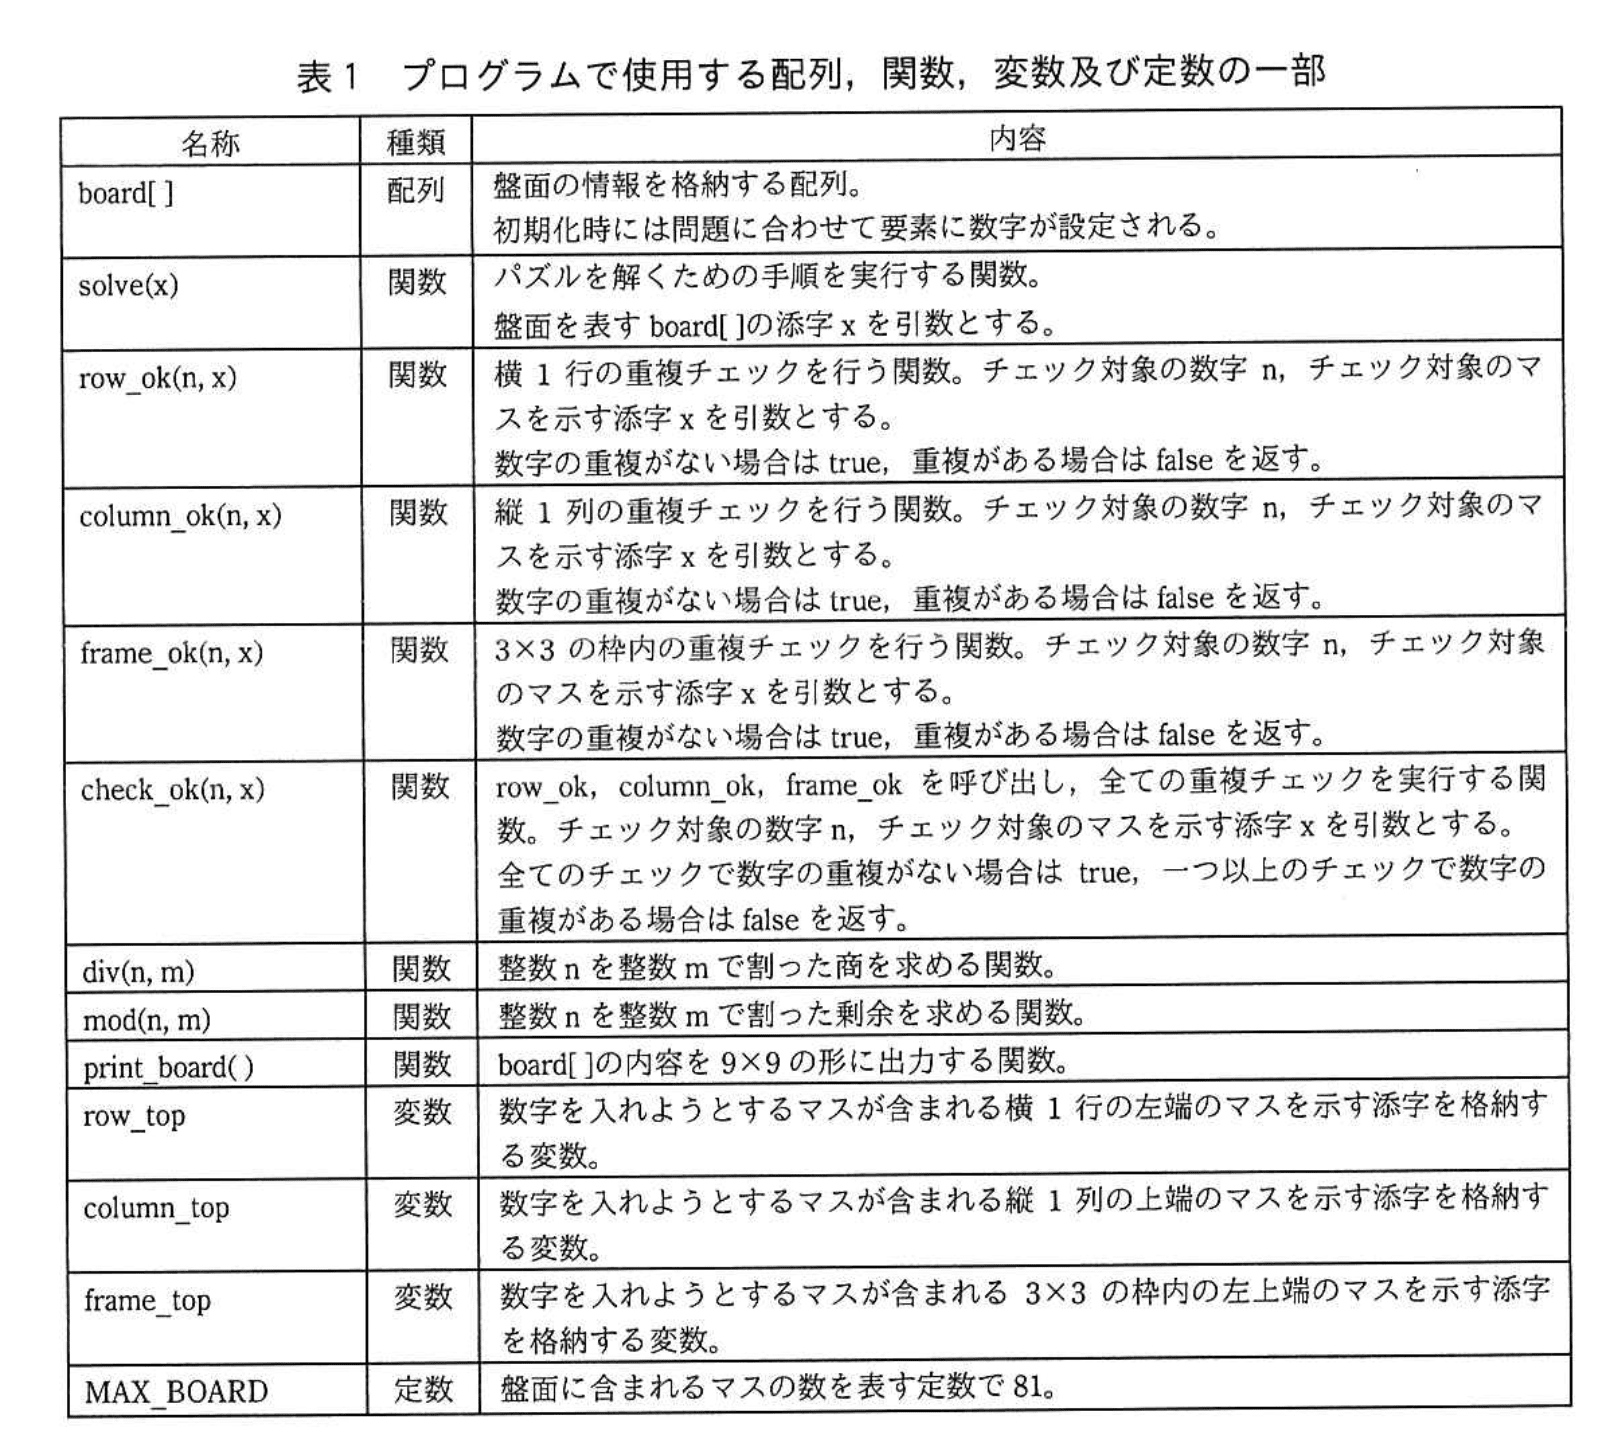
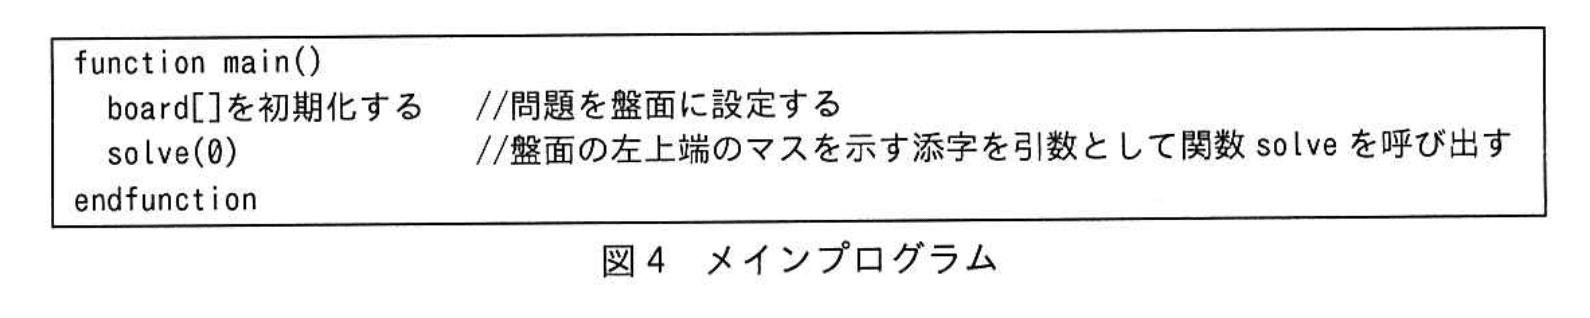
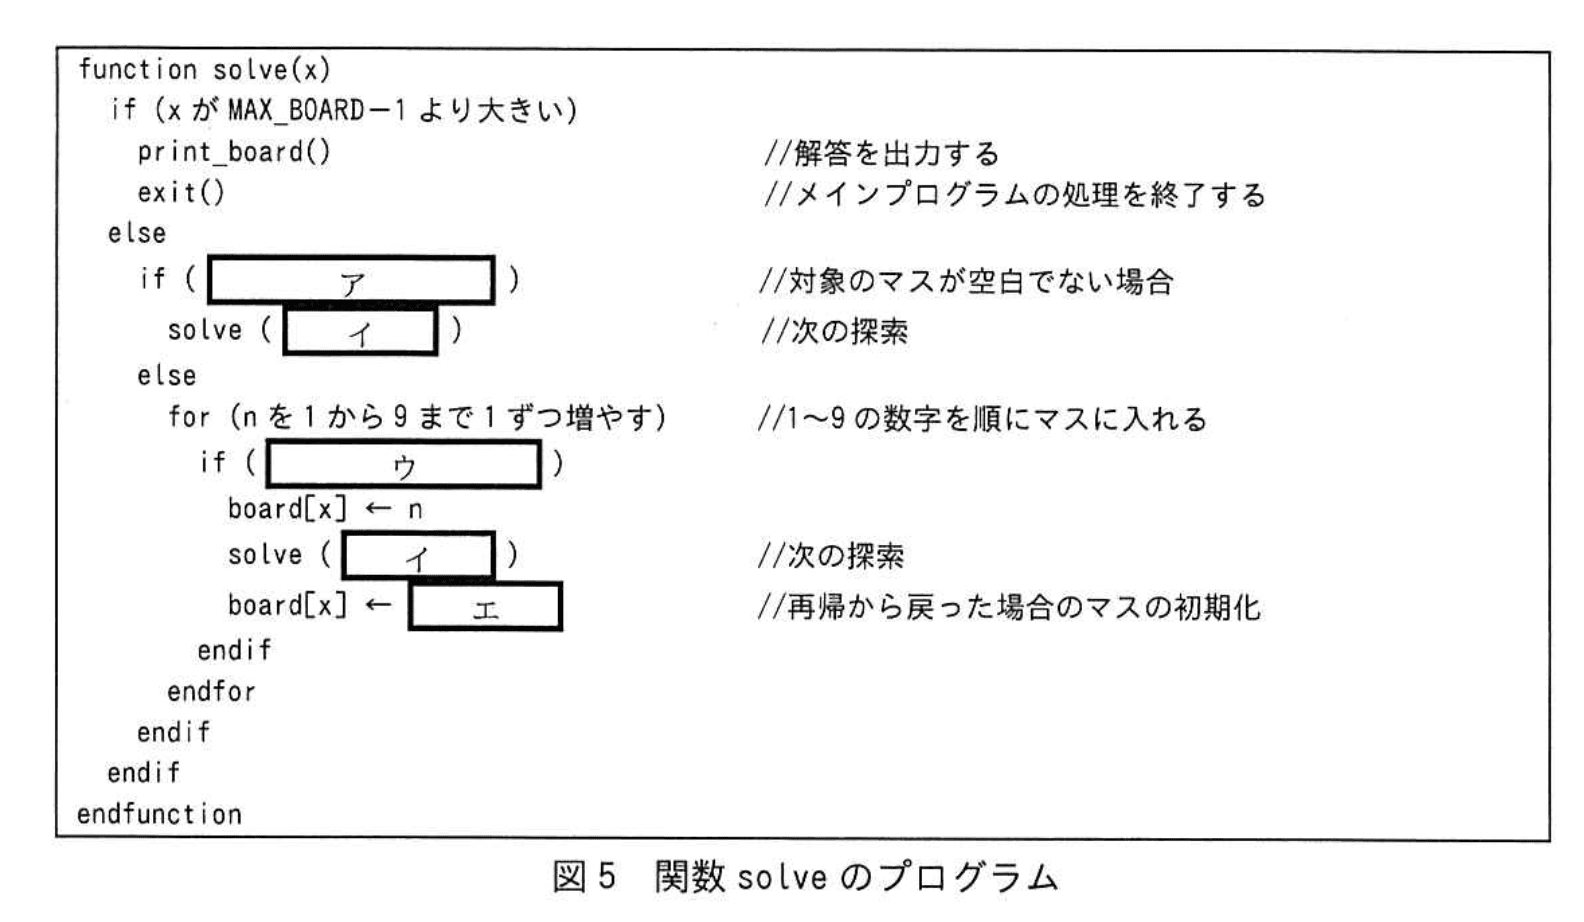
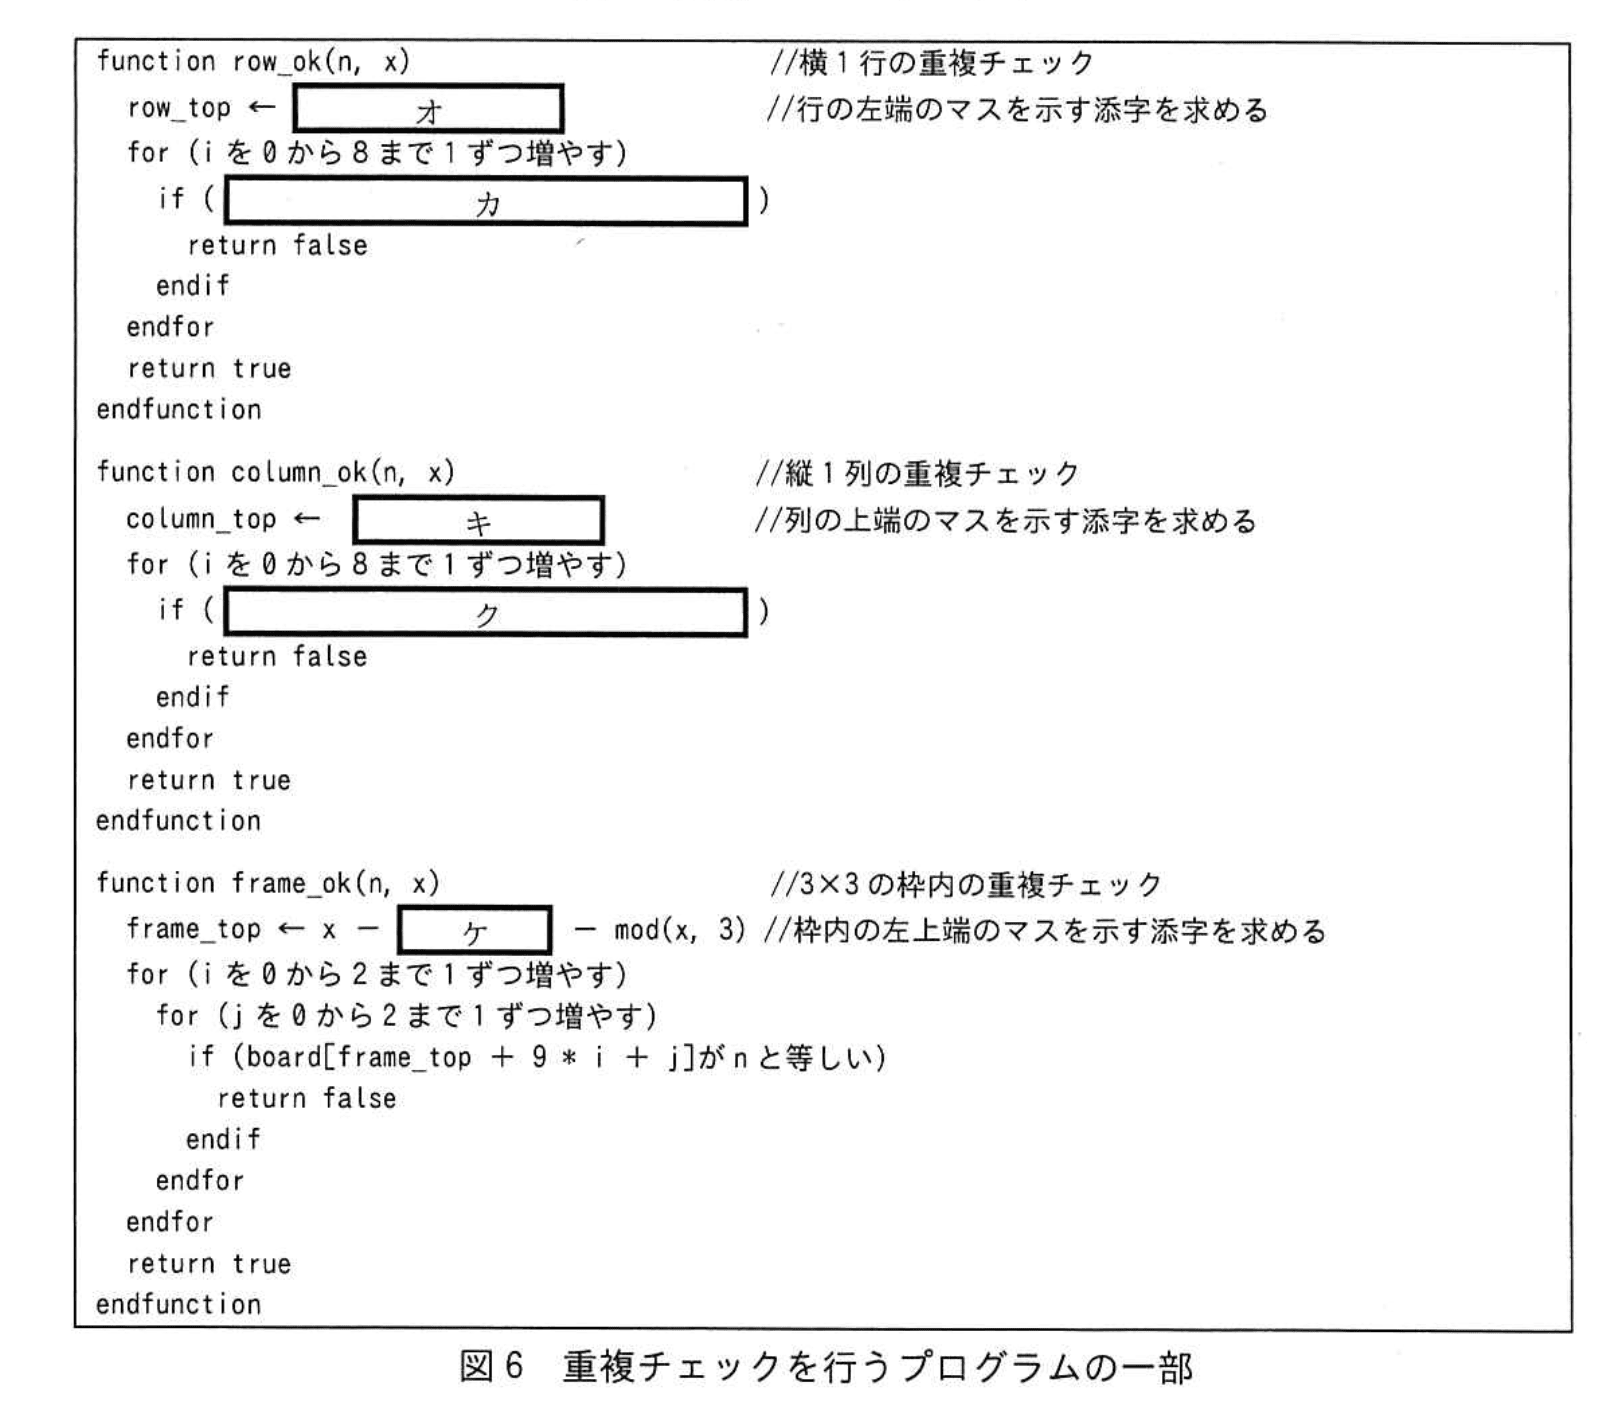
解法のプログラムのメインプログラムを図4に、関数solveのプログラムを図5に、重複チェックを行うプログラムの一部を図6に示す。
〔プログラムの改善〕
解法のプログラムは深さ優先探索であり、探索の範囲が広くなるほど、再帰呼出しの回数が指数関数的に増加し、重複チェックの実行回数も増加する。
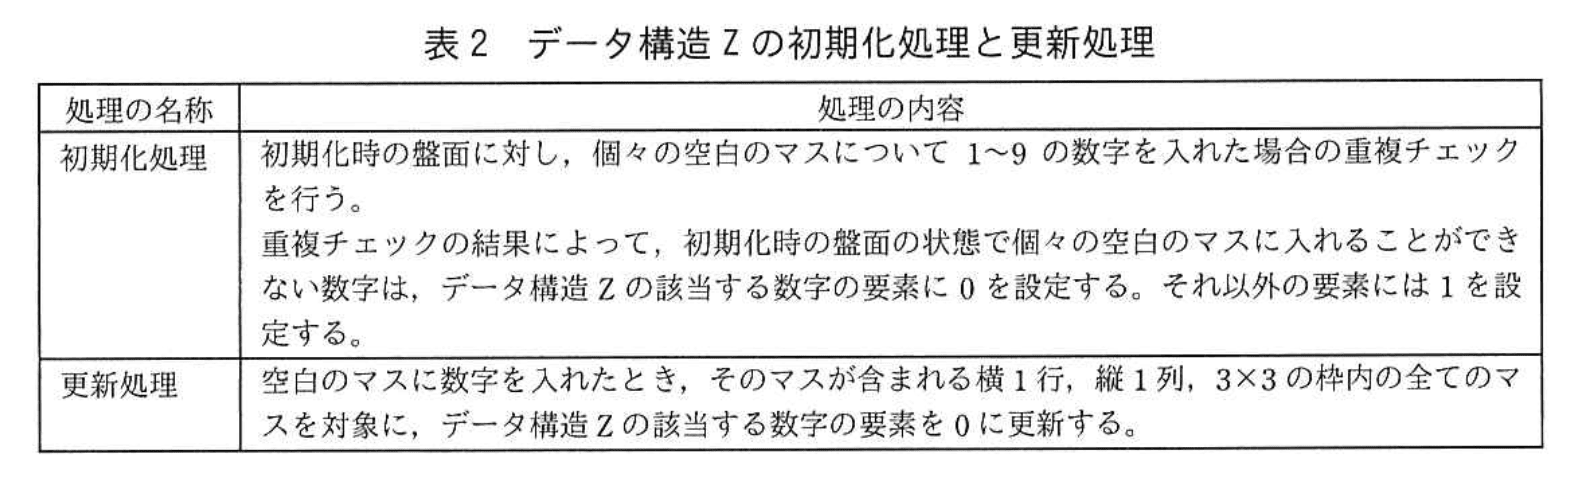
そこで、重複チェックの実行回数を少なくするために、各マスに入れることができる数字を保持するためのデータ構造Zを考える。データ構造Zは盤面のマスの数×9の要素をもち、添字xは0から、添字nは1から始まる2次元配列とする。Z[x][n]は、ゲームのルールにのっとってboard[x] に数字nを入れることができる場合は要素に1を、できない場合は要素に0を格納する。データ構造Zの初期化処理と更新処理を表2のように定義した。
なお、データ構造Zは大域変数として導入する。
〔パズルを解く手順〕の (1) の前にデータ構造Zの初期化処理を追加し、〔パズルを解く手順〕の (2)~(5) を次の (2)~(4) のように変更した。
(2) 空白のマスを見つける。
(3) データ構造Zを参照し、(2) で見つけた空白のマスに入れることができる数字のリストを取得し、リストの数字を順番に入れる。
(3-1) 入れる数字がある場合、①処理A を行った後、マスに数字を入れる。その後、データ構造Zの更新処理を行い、(2) に進んで次の空白のマスを見つける。
(3-2) 入れる数字がない場合、マスを空白に戻し、②処理Bを行った後、一つ前に数字を入れたマスに戻り、戻ったマスで取得したリストの次の数字から再開する。
(4) 最後のマスまで数字が入り、空白のマスがなくなったら、それが解答となる。
設問1:
問題文を見る模範解答
ア:board[x]が0でない
イ:x+1
ウ:check_ok(n, x)がtrueと等しい
エ:0
解説
解答の論理構成
-
[ア] の判断基準
- 盤面の配列について【問題文】には「各要素にはマスに入れられた数字が格納され、空白の場合は0を格納する。」とあります。
- したがって “対象のマスが空白でない” とはboard[x] に0以外の値が入っている場合であり、条件式は「board[x]が0でない」となります。
-
[イ] の添字計算
- 探索順序は〔パズルを解く手順〕(1) にある通り「左端から順に右方向に探索し、右端に達したら一行下がり…」ですが、1次元配列で実装しているため右隣のマスはインデックスを1増やすだけで得られます。
- よって次に処理すべきマスはx+1です。
-
[ウ] の成立条件
- 1~9の数字を試すforループの中では「数字を入れたときに、その状態がパズルのルールにのっとっているかどうかをチェックする。」とあり、チェック用関数は【表1】で示されたcheck_ok(n, x) です。
- trueが返れば「ルールにのっとっている」と解釈し再帰に進むため、判定式は「check_ok(n, x)がtrueと等しい」。
-
[エ] の巻き戻し処理
- 再帰から戻ったときには「マスを空白に戻して…」という 〔パズルを解く手順〕(4-2) の指示があります。空白は 0 で表現されるので board[x] ← 0 が必要です。
誤りやすいポイント
- 1行9列を1次元配列で表す際、右端から次の行頭に移る計算(x + 1ではなく (x+1) mod 9など)と混同する。
- [ウ] でrow_ok・column_ok・frame_okを個別に呼び出してしまい、記述が長くなる。実際にはcheck_ok(n, x) が包括している。
- 「空白に戻す」処理を忘れ、バックトラック時に盤面が汚れたままになる。
FAQ
Q: x+1ではなく、行末処理を意識した複雑な式が必要では?
A: 盤面全体をsolveが再帰で探索するため、行末・列末の切り替えは再帰のレベルで解決されます。したがって単純にx+1で問題ありません。
A: 盤面全体をsolveが再帰で探索するため、行末・列末の切り替えは再帰のレベルで解決されます。したがって単純にx+1で問題ありません。
Q: check_okがtrueになる確率を高める工夫はありますか?
A: 本問後半で紹介されるデータ構造Zのように事前に候補数字を絞り込むことで、check_ok呼び出し回数を削減できます。
A: 本問後半で紹介されるデータ構造Zのように事前に候補数字を絞り込むことで、check_ok呼び出し回数を削減できます。
Q: 0を空白とする実装の利点は?
A: 配列を整数型で統一できるため追加フラグが不要です。また「0はパズルの合法数字1~9とは重複しない」という性質を利用し、条件判定が簡潔になります。
A: 配列を整数型で統一できるため追加フラグが不要です。また「0はパズルの合法数字1~9とは重複しない」という性質を利用し、条件判定が簡潔になります。
関連キーワード: バックトラック, 深さ優先探索, 再帰呼出し, ブール評価, 1次元配列

設問2:
問題文を見る模範解答
オ:div(x, 9)*9
カ:board[row_top+i]がnと等しい
キ:mod(x, 9)
ク:board[column_top+9*i]がnと等しい
ケ:mod(div(x, 9)*9, 27)
解説
解答の導き方
まず添字の並び方と用語の定義を問題文から確認します。図3に「1行目(最上段・左から右へ):[0] [1] [2] [3] [4] [5] [6] [7] [8]」とあるので、添字は行優先(row-major)で上から下へ、各行は左から右へ0から80の順に割り当てられていることがわかります。また表1に「div(n, m) は整数nを整数mで割った商を求める関数」「mod(n, m) は整数nを整数mで割った剰余を求める関数」とあるため、添字から行番号・列番号を整数除算と剰余で求められます。
以下、図6の空欄ごとに理由を段階的に示します。
- [オ](row_topの式)
- row_topの説明に「数字を入れようとするマスが含まれる横1行の左端のマスを示す添字を格納する変数」とあります。行番号を とすると です。行の先頭添字はその行番号に9を掛けた値なので、row_topは を表します。したがって [オ] = div(x, 9)*9 例: のとき なので行先頭は であり、これは添字9が正しい行先頭です。
- 図6の行チェック内の条件(forループ中の判定、力)
- for (iを0から8まで) で行内の9マスを順に参照するので、参照添字はrow_top + iです。これらのマスの値が既に入れようとする数字 と等しいかを調べればよく、条件は 力 = board[row_top+i]がnと等しい となります。
- [キ](column_topの式)
- column_topの説明に「数字を入れようとするマスが含まれる縦1列の上端のマスを示す添字」とあるので、列番号を とすると です。列の上端添字はその列番号そのものなので [キ] = mod(x, 9) 例: のとき であり、列上端は添字1(各行の同じ列の最上行)です。
- 列チェック内の条件(forループ中の判定、ク)
- 列方向に1行下がると添字は されるため、列内を順に参照する添字はcolumn_top + 9*iです。これらが と等しいかを判定する条件は ク = board[column_top+9*i]がnと等しい となります。
- [ケ](frame_topを求める式の中の項)
-
図6 に frame_top を求める式として frame_top ← x − ケ − mod(x, 3) とあるため、[ケ] は行方向のブロック内オフセットに関係する式であることが分かります。ここで行番号を 、列番号を と置きます。行の先頭添字は です。3×3ブロックは「縦に3行、横に3列」から成るため、行方向に3行下がると添字は 増えます。したがって を で剰余を取ると、その行が属する「3行ブロック内での行先頭からのオフセット」を のいずれかで得られます。r の値ごとの具体例を列挙します(分かりやすさのため):
-
→ →
-
→ →
-
→ →
-
→ →
-
→ →
-
→ →
-
→ →
-
→ →
-
→ →
この結果から、行方向のブロック内オフセットを表す式は であることが直感的に分かります。次に数式で整然と示します。まず です。また 、 が成り立ちます。これらを用いると
これが3×3ブロックの左上端の添字(ブロック行番号 に を、ブロック列番号 に を掛けて合成した値)と一致します。したがって [ケ] に入る式は
[ケ] = mod(div(x, 9)*9, 27)
となります。
以上をまとめると、図6の空欄への適切な字句は次の通りです(表記は問題文の語句をそのまま用いています)。
- [オ]:div(x, 9)*9
- 力:board[row_top+i]がnと等しい
- [キ]:mod(x, 9)
- [ク]:board[column_top+9*i]がnと等しい
- [ケ]:mod(div(x, 9)*9, 27)
誤りやすいポイント
- row_topを求める際にdiv(x,9) だけにしてしまい、さらに9を掛けるべきことを忘れる。例:x=10の行先頭は9である。
- column_topにdiv(x,9) を使ってしまう(列はmodを使う)。行と列の計算を取り違えると致命的。
- 3×3ブロックを一次元配列上で「連続した27個」と誤解する。実際は列方向に間隔(+1)と行方向に間隔(+9)が混在している。3行下がると +27になる性質を利用する。
- 行チェックと列チェックで増分を逆にする(行は +1、列は +9)。ループ内の添字計算を紙に書いて確かめる。
- modとdivの使い方混同(剰余か商かを明確にする)。特にブロック番号はdiv、ブロック内オフセットはmodを使う。
- 添字が0始まりであることを忘れる(1始まりの感覚だとオフバイワンになる)。
FAQ
Q: frame_topを求める式をもっと直感的に書く方法はありますか?
A: はい。 は直感的です。これは「行方向のブロック番号に を掛け、列方向のブロック番号に を掛けて足す」式で、先に示した式と同値です。
A: はい。 は直感的です。これは「行方向のブロック番号に を掛け、列方向のブロック番号に を掛けて足す」式で、先に示した式と同値です。
Q: なぜ列方向のループで添字に を使うのですか?
A: boardは行優先で1行あたり9要素並んでいるため、同じ列の次の行は添字が になります。列全体を参照するには を使います。
A: boardは行優先で1行あたり9要素並んでいるため、同じ列の次の行は添字が になります。列全体を参照するには を使います。
Q: 実装上の確認方法はありますか?
A: 小さな例で の値をいくつか取り、 と を計算して行先頭・列上端・ブロック左上が正しいかを手で確かめるとミスが見つかりやすいです。特に の場合にmod(div(x,9)*9,27) が を繰り返すことを確認してください。
A: 小さな例で の値をいくつか取り、 と を計算して行先頭・列上端・ブロック左上が正しいかを手で確かめるとミスが見つかりやすいです。特に の場合にmod(div(x,9)*9,27) が を繰り返すことを確認してください。
関連キーワード: 深さ優先探索、バックトラッキング、配列インデックス計算、剰余演算、行優先配置
設問3:
問題文を見る模範解答
処理A:データ構造Zを退避する
処理B:退避したデータ構造Zを取り出す
解説
解答の論理構成
- 問題文は、従来の深さ優先探索に対し「重複チェックの実行回数を少なくするために、各マスに入れることができる数字を保持するためのデータ構造Zを考える」と述べています。この “データ構造Z” は探索のたびに内容が書き換わります。
- 新しい手順の説明では
「(3-1) 入れる数字がある場合、①処理Aを行った後、マスに数字を入れる。その後、データ構造Zの更新処理を行い…」
「(3-2) 入れる数字がない場合、マスを空白に戻し、②処理Bを行った後、一つ前に数字を入れたマスに戻り…」
と明記され、処理A は“数字を入れる前”、処理B は“数字を取り消した後”に呼ばれます。 - 数字を試すたびに “データ構造Zの更新処理” が走るため、バックトラック時には更新前のZを取り戻す必要があります。
- よって
・処理A=更新前の “データ構造Z” をどこかに保存する(退避)
・処理B=保存していた “データ構造Z” を元に戻す(復元)
が唯一破綻なく探索木をたどる方法です。 - 以上より模範解答どおり
「処理A:データ構造Zを退避する」
「処理B:退避したデータ構造Zを取り出す」
が導かれます。
誤りやすいポイント
- 処理A/処理Bを「board の退避・復元」と勘違いする。board は再帰から戻る直前に board[x] ← 0 としてリセットされるので別途保存は不要です。
- 「データ構造Zの更新処理=処理A」と読み違える。処理Aはあくまで更新“前”に呼び出される点に注意します。
- 「処理Bで再度更新処理を呼ぶ」と考える誤解。更新処理は数字を書き込むときだけ行うので、取り消し時は保存したZを復元するだけで十分です。
FAQ
Q: 処理Aはコピーではなく差分保存でも良いですか?
A: 問題文は具体的な実装方式を指定していませんが、探索木の復元性が保証できれば差分方式でも正解の趣旨を満たします。
A: 問題文は具体的な実装方式を指定していませんが、探索木の復元性が保証できれば差分方式でも正解の趣旨を満たします。
Q: boardとZの両方をスタックに積む実装は過剰ですか?
A: boardは再帰から抜けると同時に自動的に元に戻るため、Zだけをスタックに積むほうが効率的です。
A: boardは再帰から抜けると同時に自動的に元に戻るため、Zだけをスタックに積むほうが効率的です。
Q: データ構造Zのサイズは81×9要素ですが、メモリ的に問題ありませんか?
A: 1要素を1バイトで持てば約729バイトなので実用上問題ありません。探索効率向上のほうがメリットは大きいです。
A: 1要素を1バイトで持てば約729バイトなので実用上問題ありません。探索効率向上のほうがメリットは大きいです。
関連キーワード: 深さ優先探索, バックトラック, 状態空間, スタック, 再帰

