
基本情報技術者 2013年 秋期 午後 問09
次のCプログラムの説明及びプログラムを読んで、設問1~3に答えよ。
二つの英単語を辞書順で比較する関数diccmpを作成した。
一般に、英大文字、英小文字、記号文字を含む英単語を一定の順に並べる方法として、次の例のように、文字列中の文字コード順に並べる方法の他に、英和辞典や書籍の欧文索引のような順序で並べる方法(以下、辞書順という)がある。
例 4個の単語“A.M.”、“CPU”、“all”及び“best”を並べる方法
文字コード順:“A.M.” < “CPU” < “all” < “best”
辞書順: “all” < “A.M.” < “best” < “CPU”
検索などの場合は、英単語を辞書順に整列しておくと検索の効率がよく、精度も向上する。
関数diccmpは、英大文字、英小文字、“-”及び“.”を含む二つの英単語の大小を辞書順で比較する。
〔プログラムの説明〕
関数diccmpは、二つの英単語の大小を辞書順で比較する。その引数と返却値は、次のとおりである。
引数: word1, word2 英単語を格納した文字列
返却値: 負の値 word1<word2 (例:“map”<“May”)
0 word1=word2 (例:“Mr.”=“Mr.”)
正の値 word1>word2 (例:“U.S.”>“US”)
(1) 引数word1とword2は、いずれも次の条件を満たしている。
① 各文字は、英大文字(“A”~“Z”)、英小文字(“a”~“z”)、“-”又は“.”のいずれかである。英大文字と英小文字を合わせて、英字という。
② 文字列の長さは、1以上30以下である。
③ 文字列の先頭の文字は、英字である。
④ 文字列中の“-”及び“.”の直前の文字は、英字である。
(2) 辞書順での比較の方法は、次のとおりである。
① 各引数の文字列から、基本文字列と文字情報列を生成する。基本文字列とは、引数の文字列から英字だけを順に取り出して、大文字を小文字に変換した文字列である。文字情報列とは、基本文字列中の各文字に対応する6種類の文字情報(大文字、小文字、大文字“-”付き、小文字“-”付き、大文字“.”付き、小文字“.”付き)を表す情報の列である。ここで、“-”及び“.”は、直前の英字に属する文字情報とみなす。
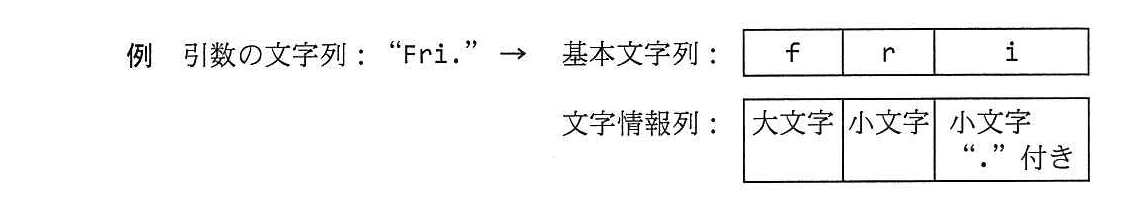
② 各引数の基本文字列同士を関数strcmpで比較し、異なっていれば、その返却値(負の値又は正の値)を返す。一致していれば、各引数の文字情報列同士を関数strcmpで比較し、その返却値(0、負の値又は正の値)を返す。
③ 6種類の文字情報について、その値の大小関係はプログラム中で定めている。
(3) プログラム中で使用しているライブラリ関数の概要は、次のとおりである。
isalpha(c): cが英字のとき0以外の値を返し、それ以外のとき0を返す。
islower(c): cが英小文字のとき0以外の値を返し、それ以外のとき0を返す。
strcmp(s1, s2): 文字列s1とs2を比較し、s1 < s2のとき負の値を、s1 = s2のとき0を、s1 > s2のとき正の値を、それぞれ返す。
tolower(c): cが英大文字のときその文字に対応する英小文字を返し、それ以外のときcを返す。
設問1:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
引数word1の内容を“A.D.”、word2の内容を“ad-”として、関数diccmpを実行した。関数diccmp中のreturn文を実行する時点で、attr1の内容は“a”、attr2の内容は“b”、rcの内容はcとなる。
a, bに関する解答群
ア:01
イ:02
ウ:11
エ:22
オ:41
カ:42
キ:55
ク:66
cに関する解答群
ア:0
イ:正の値
ウ:負の値
模範解答
a:ク、b:ア、c:イ
解説
解答の導き方
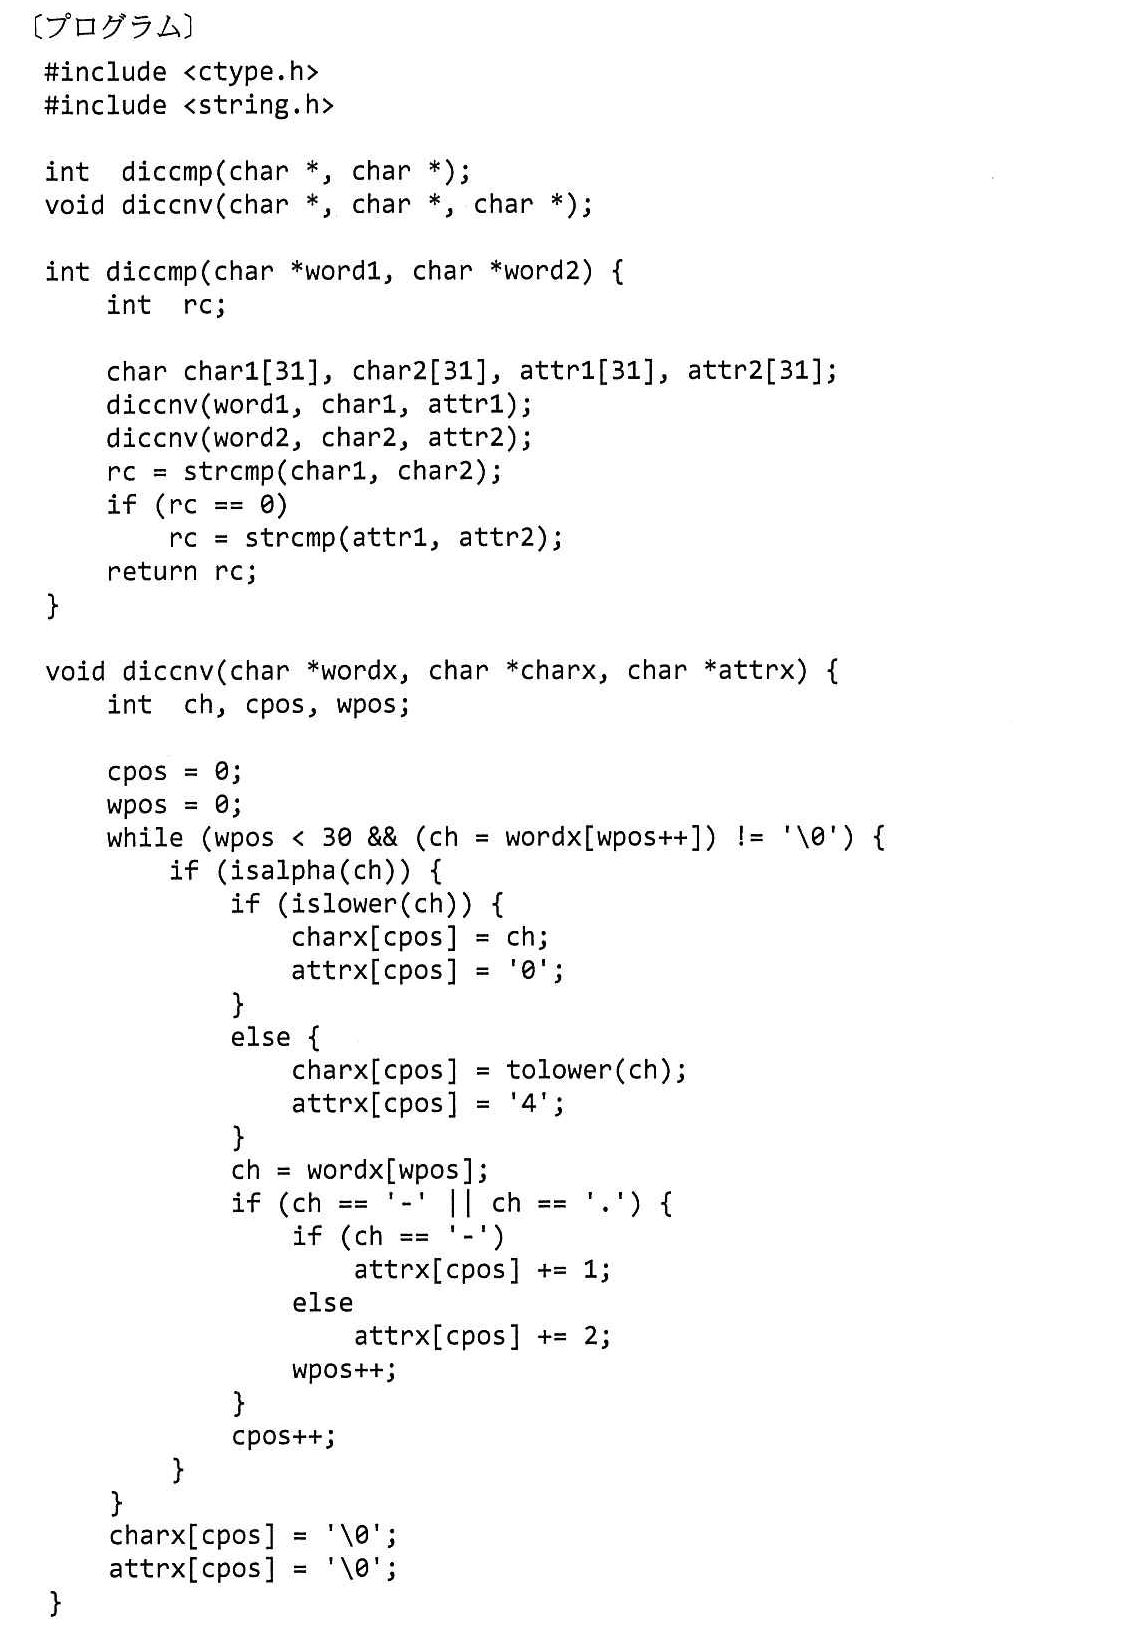
問われているのは、word1とword2を変換した後の文字情報列と、関数diccmpが最後に返す値です。まず、文字列から基本文字列と文字情報列を作る処理を追います。
問題文には、基本文字列は「英字だけを順に取り出して、大文字を小文字に変換した文字列」とあります。また、文字情報は大文字・小文字の違いや、直後に「-」または「.」が付くかどうかを表します。
word1の内容が「A.D.」の場合
1文字ずつ処理すると、次のようになります。
プログラムでは、大文字の文字情報を文字「4」とし、直後が「.」なら2を加えます。そのため、各文字情報は「6」になります。「.」は単独の文字情報にはならず、直前の英字に付いた情報として扱われます。
したがって、attr1の内容は「66」です。
word2の内容が「ad-」の場合
小文字の文字情報は文字「0」です。直後に「-」があると1を加えるため、dに対応する情報は「1」になります。
したがって、attr2の内容は「01」です。
次に、関数diccmpが比較する順番を確認します。プログラムでは、まず基本文字列をstrcmpで比較します。strcmpは、2つの文字列を比べて、左側が小さければ負の値、同じなら0、大きければ正の値を返す関数です。
今回、基本文字列はどちらも「ad」なので、最初の比較結果は0です。そのため、プログラムは続けて文字情報列を比較します。attr1の先頭文字「6」は、attr2の先頭文字「0」より大きいので、文字情報列の比較結果は正の値です。この結果がrcに入り、return文で返されます。
誤りやすいポイント
- 「.」や「-」を、基本文字列に含めると考えないようにします。基本文字列には英字だけが入ります。
- 「.」や「-」は直前の英字に付く情報です。記号だけで文字情報列の別の1文字を使うわけではありません。
- 大文字の情報の初期値は「4」、小文字の情報の初期値は「0」です。直後の記号に応じて、そこに値を加えます。
- 基本文字列の比較結果が0のときだけ、文字情報列を比較します。今回は基本文字列が同じなので、文字情報列の比較結果が最終的なrcになります。
- strcmpが返す正の値は、具体的にどの数値かを表しているわけではありません。大小関係が「大きい」ことを示します。
FAQ
Q: word1の最後の「.」も文字情報列に入りますか?
A: 別の文字としては入りません。直前の英字Dに付いた情報として扱われるため、Dの文字情報が「6」になります。
A: 別の文字としては入りません。直前の英字Dに付いた情報として扱われるため、Dの文字情報が「6」になります。
Q: 基本文字列が同じなら、いつも関数diccmpの返却値は0ですか?
A: いいえ。基本文字列が同じ場合は、文字情報列を続けて比較します。文字情報列も同じときに、返却値が0になります。
A: いいえ。基本文字列が同じ場合は、文字情報列を続けて比較します。文字情報列も同じときに、返却値が0になります。
Q: rcの正確な数値まで求める必要がありますか?
A: この設問では、rcが負の値、0、正の値のどれになるかを判定します。strcmpの返却値について、正確な数値ではなく大小関係を見ます。
A: この設問では、rcが負の値、0、正の値のどれになるかを判定します。strcmpの返却値について、正確な数値ではなく大小関係を見ます。
関連キーワード: 文字列、配列、文字コード、strcmp、辞書順比較

設問2:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
関数diccmpを用いて、4個の単語“CO”、“Co.”、“co-”及び“co.”を相互に比較したとき、その大小関係は、dとなる。
dに関する解答群
ア:“CO” < “Co.” < “co-” < “co.”
イ:“CO” < “Co.” < “co.” < “co-”
ウ:“Co.” < “CO” < “co-” < “co.”
エ:“co-” < “co.” < “Co.” < “CO”
オ:“co.” < “co-” < “CO” < “Co.”
カ:“co.” < “co-” < “Co.” < “CO”
模範解答
d:エ
解説
解答の導き方
この問題では、4個の単語をそのまま比べるのではなく、問題文の手順に従って「基本文字列」と「文字情報列」を作って比較します。
まず、基本文字列は、記号を除いて英字だけを取り出し、大文字を小文字に変換して作ります。そのため、どの単語からも基本文字列「co」ができます。
次に、文字情報列を作ります。プログラムでは、文字情報を表す値は次のようになります。
「-」や「.」は、直前の英字に属します。各単語の文字情報列は、次のとおりです。
4個の単語は基本文字列がすべて「co」で一致します。したがって、問題文のとおり、文字情報列をstrcmpで比較します。strcmpは文字列を先頭から順に比べ、最初に異なる文字の大小で順序を決めるC言語の関数です。
文字情報列は「01」「02」「42」「44」の順になります。最初の2つは先頭の「0」が同じで、次の文字が「1」より「2」のほうが後です。また、「02」は先頭の「0」が「42」の「4」より前になり、「42」は2文字目の「2」が「44」の「4」より前になります。
したがって、単語の順序は「co-」<「co.」<「Co.」<「CO」となり、解答群ではエです。
誤りやすいポイント
- 「Co.」の「.」は、直前の「o」に属します。「C」に付くものではありません。
- 大文字・小文字は基本文字列を作る段階で小文字にそろえます。大文字か小文字かの違いは、文字情報列で比較します。
- 「-」や「.」を基本文字列に残して比べるのではありません。記号は文字情報列に反映されます。
- 文字情報列の「01」などは数値ではなく、文字を並べた列です。strcmpで先頭から文字ごとに比べます。
FAQ
Q: 「co-」の文字情報列が「11」ではなく「01」なのはなぜですか。
A: 「-」は直前の「o」にだけ属するためです。「c」は記号が付かない小文字なので「0」、記号付きの「o」は「1」となり、「01」です。
A: 「-」は直前の「o」にだけ属するためです。「c」は記号が付かない小文字なので「0」、記号付きの「o」は「1」となり、「01」です。
Q: 「Co.」が「CO」より前になるのはなぜですか。
A: どちらも基本文字列は同じです。文字情報列は「Co.」が「42」、「CO」が「44」です。最初の「4」は同じで、次の文字は「2」のほうが「4」より前になるため、「Co.」が先です。
A: どちらも基本文字列は同じです。文字情報列は「Co.」が「42」、「CO」が「44」です。最初の「4」は同じで、次の文字は「2」のほうが「4」より前になるため、「Co.」が先です。
Q: 基本文字列が異なる場合も、文字情報列を比べますか。
A: 比べません。基本文字列をstrcmpで比較し、違いがあればその結果で順序が決まります。文字情報列を比べるのは、基本文字列が一致した場合です。
A: 比べません。基本文字列をstrcmpで比較し、違いがあればその結果で順序が決まります。文字情報列を比べるのは、基本文字列が一致した場合です。
関連キーワード: 辞書順、文字列比較、文字情報列、文字列変換、strcmp
設問3:
問題文を見る 次の表1中のに入れる正しい答えを、解答群の中から選べ。
このプログラムは、引数word1及びword2がプログラムの説明中の(1)に示した条件①〜④を満たしているものとして作成している。しかし、引数が条件を満たさない場合のプログラムの動作についても確認しておきたい。そこで、引数が条件を満たさない場合のプログラムの動作を、表1にまとめた。なお、文字列中の文字は、全て1バイト文字とする。
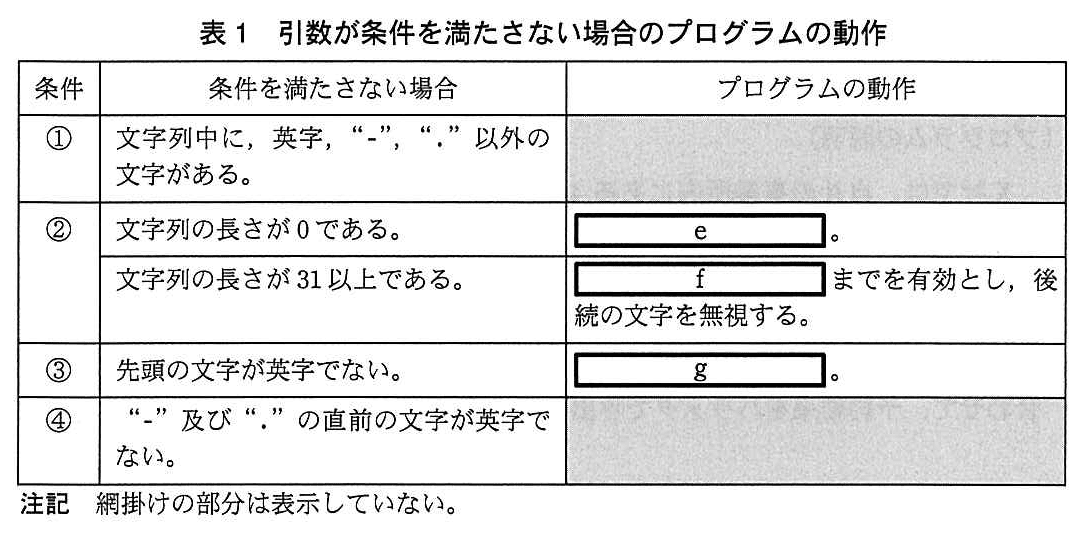
eに関する解答群
ア:空文字列として扱い、プログラムは正常に終了する
イ:配列に何も値を設定せずに比較をするので、予期できない結果となる
ウ:配列の定義範囲外への書込みが発生するので、予期できない結果となる
エ:プログラムが終了しない
fに関する解答群
ア:30個目の英字
イ:30個目の英字(直後の文字が“-”又は“.”の場合はその文字)
ウ:30文字目
エ:30文字目(30文字目が英字で31文字目が“-”又は“.”の場合は31文字目)
gに関する解答群
ア:その文字が“-”、“.”以外の場合はその文字を無視するが、“-”又は“.”の場合は配列の定義範囲外への書込みが発生するので、予期できない結果となる
イ:その文字を無視する
ウ:配列の定義範囲外への書込みが発生するので、予期できない結果となる
エ:プログラムが終了しない
模範解答
e:ア、f:エ、g:イ
解説
解答の導き方
関数diccnvは、引数の英単語から英字を取り出して、比較用の二つの文字列を作ります。charxには小文字にそろえた英字を、attrxには大文字・小文字や直後の記号を表す情報を入れます。
ここで、配列(値を順番に入れておく領域)の添字は0から始まります。charxとattrxは、それぞれ31個分の領域があります。また、strcmpは二つの文字列を比較する関数です。文字列の終わりを示す特別な文字「'\0'」が入っていると、そこで文字列の終わりとして扱います。
e:文字列の長さが0の場合
文字列が空なら、while文の条件で最初に読み込まれる文字は「'\0'」です。そのため、while文の中は一度も実行されません。
その後、cposは0のままなので、charx[0]とattrx[0]に「'\0'」が設定されます。どちらも空文字列として完成するため、strcmpによる比較は正常に行われます。したがって、プログラムは正常に終了します。
f:文字列の長さが31以上の場合
while文には「wpos < 30」という条件があります。wposは読み込む位置を表すので、通常は先頭から30文字目までが処理の対象です。
ただし、英字を処理した直後に、次の文字が「-」又は「.」かどうかを調べています。30文字目が英字の場合は、その直後にある31文字目も調べます。31文字目が「-」又は「.」なら、その記号を文字情報に加え、読み込む位置も進めます。
つまり、基本的には30文字目までが有効ですが、30文字目が英字で、その直後の31文字目が「-」又は「.」の場合は、31文字目の記号も処理されます。この動作に当てはまるのはエです。
g:先頭の文字が英字でない場合
文字を読み込んだ後、文字が英字かどうかをisalphaで調べています。英字でなければ、その後の処理には進みません。したがって、その文字はcharxにもattrxにも入らず、読み飛ばされます。
読み込む位置wposはwhile文の条件式の中で進むため、先頭の文字が英字でなくても処理は先へ進みます。配列の範囲外に書き込むこともありません。したがって、その文字を無視するイが該当します。
誤りやすいポイント
- 文字列の長さが0でも、配列に何も設定されないわけではありません。while文の後でcharx[0]とattrx[0]に「'\0'」が設定されるため、空文字列として比較できます。
- fでは「30文字目まで」とだけ考えると、31文字目を処理する例外を見落とします。英字を処理した直後に、次の文字を調べている点がポイントです。
- gでは、先頭が英字でないときに配列への書込みが起こるかを確認します。英字でない文字は英字を処理する部分に入らないため、配列には書き込まれません。
FAQ
Q: 文字列の終わりを示す「'\0'」は、文字列の長さに含まれますか?
A: 問題文でいう文字列の長さには含まれません。文字列がどこで終わるかをプログラムに知らせるために使われます。
A: 問題文でいう文字列の長さには含まれません。文字列がどこで終わるかをプログラムに知らせるために使われます。
Q: 31文字目が英字の場合も処理されますか?
A: されません。31文字目を調べるのは、30文字目を英字として処理した直後です。そのとき31文字目が「-」又は「.」なら処理されますが、英字なら読み込む位置の条件を満たさず、処理されません。
A: されません。31文字目を調べるのは、30文字目を英字として処理した直後です。そのとき31文字目が「-」又は「.」なら処理されますが、英字なら読み込む位置の条件を満たさず、処理されません。
Q: 先頭が英字でない場合、文字列全体が無視されますか?
A: 先頭の文字だけが英字の処理対象から外れます。その後の文字は、while文で順に調べられます。
A: 先頭の文字だけが英字の処理対象から外れます。その後の文字は、while文で順に調べられます。
関連キーワード: C言語、配列、文字列、strcmp、ループ処理

