
基本情報技術者 2013年 秋期 午後 問08
次のプログラムの説明及びプログラムを読んで、設問1,2に答えよ。
〔プログラムの説明〕
英字A~Zから構成される文字列を圧縮する副プログラムCompress、及び圧縮された文字列を復元する副プログラムDecompressである。
〔圧縮処理の説明〕
副プログラムCompressでは、配列Plaindataに格納されている圧縮前の文字列を受け取り、圧縮後の文字列を配列Compresseddataに格納する。図1に示す文字列“ABCDEFABCDABCDEF”を例として、圧縮処理の内容を説明する。
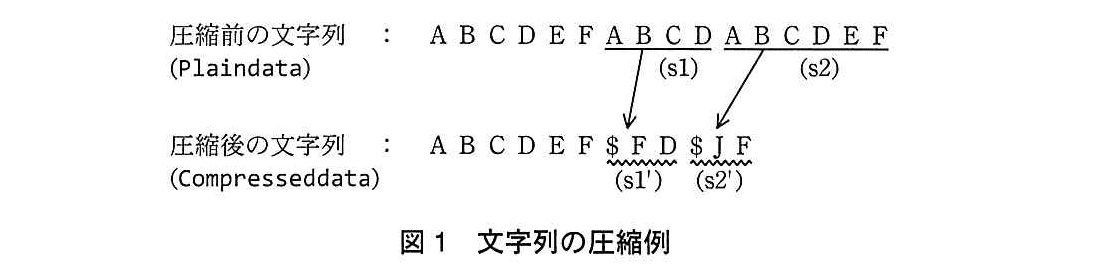
(1) 図1の圧縮前の文字列“ABCDEFABCD…”のように、“ABCD”という同じ文字の並びが複数回出現する場合、二つ目以降の“ABCD”を圧縮列に置き換えることによって、文字列の長さを短くする。図1では、Plaindataに格納されている圧縮前の文字並び(s1)、(s2)を圧縮列(s1')、(s2')に置き換えてCompresseddataに格納している。
(2) 圧縮列は、制御記号、距離、文字数の三つの部分から成る。
① 制御記号は、“$”であり、圧縮列の先頭を表す。
② 距離と文字数は、圧縮前の文字列において、“この場所の文字並びは、何文字前(距離)の文字から始まる何文字の長さ(文字数)の文字並びと同じである”という内容を意味する。距離と文字数の最大値は26とし、1, 2, …, 26をA, B, …, Zで表す。図1の例では、圧縮前の文字並び(s1)は、(s1)の先頭文字の6文字前から始まる長さ4の文字並び“A B C D”と一致するので、圧縮列(s1')は“$FD”となる。また、圧縮前の文字並び(s2)は、(s2)の先頭文字の10文字前から始まる長さ6の文字並び“A B C D E F”と一致するので、圧縮列(s2')は“$JF”となる。
(3) 圧縮処理は、配列Plaindataに格納されている圧縮前の文字列中で、圧縮する文字並びを検索する検索処理と、検出した文字並びを圧縮列に置き換えて配列Compresseddataに格納する置換処理から成る。
(4) 圧縮する文字並びの検索処理の内容を次に示す。
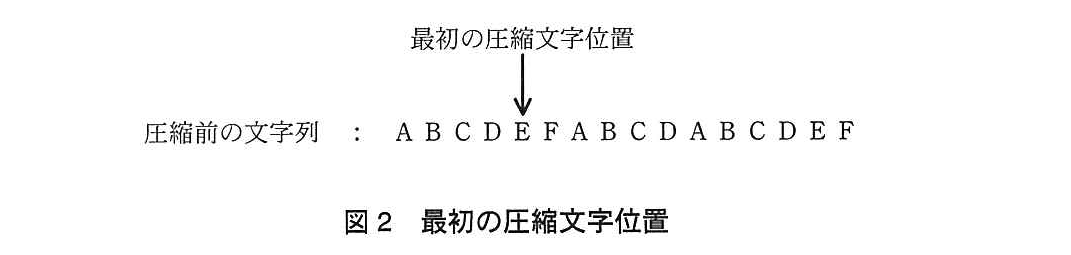
① 圧縮処理の対象となる文字並びを圧縮文字並び、圧縮文字並びの先頭位置を圧縮文字位置という。圧縮列の文字数は3なので、一致する文字数が4以上の圧縮文字並びの場合に圧縮列に置き換える。したがって、最初の圧縮文字位置は、図2に示すように圧縮前の文字列の先頭から5文字目となる。この文字位置から圧縮文字位置を文字列の後方に向かって移動させながら検索処理②, ③を行う。
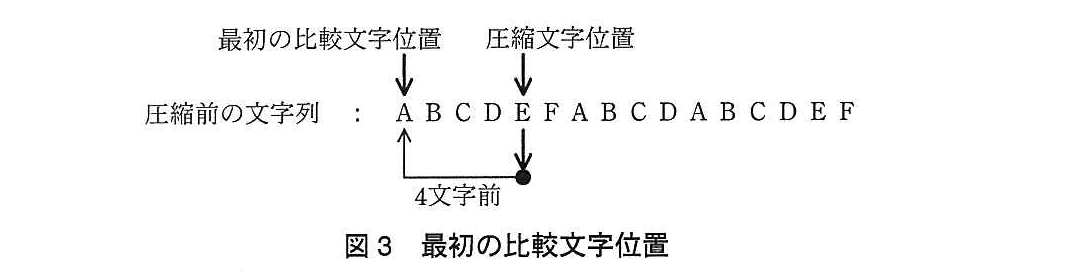
② 圧縮文字並びの比較対象とする文字並びを比較文字並び、比較文字並びの先頭位置を比較文字位置という。最初の比較文字位置は、図3に示すように圧縮文字位置の4文字前とする。
③ 比較文字位置を文字列の先頭に向かって、圧縮文字位置から最大26文字前まで移動させながら、次の(a), (b)を行う。
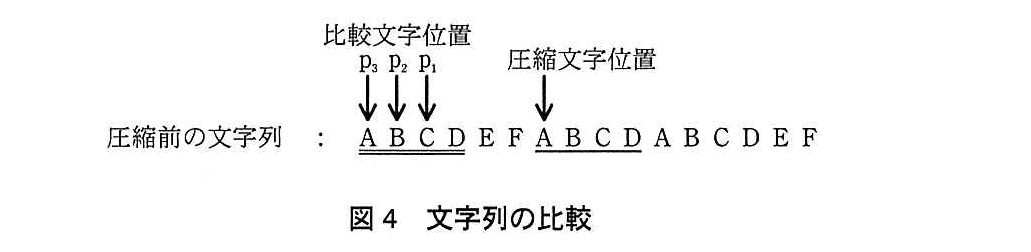
(a) 圧縮文字位置と比較文字位置から文字列の後方に向かって、圧縮文字並びと比較文字並びが何文字一致するかを調べる。図4は、圧縮文字位置が7文字目のときに、比較文字位置を文字列の先頭に向かってp1, p2, p3と移動しながら、一致する文字を検索している様子を示している。比較文字位置p1とp2では、1文字目が一致していない。比較文字位置p3では1文字目が一致し、一致する文字数は4となる。
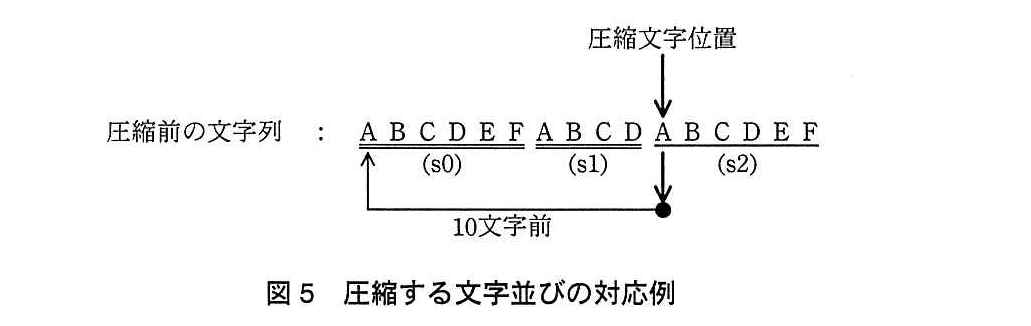
(b) 圧縮する文字並びは、それよりも前にある比較文字並びの中で、一致する文字数が4以上で最も多い比較文字並びとする。圧縮する文字並びの対応例を図5に示す。図5では、圧縮文字位置から始まる圧縮文字並び“A B C D …”と、それよりも前方に出現する比較文字並びの中で、一致する文字数が4以上の比較文字並びは、4文字前の(s1) “A B C D”と10文字前の(s0) “A B C D E F”である。したがって、一致する文字数が多い(s0)に対応させて、(s2) “A B C D E F”を圧縮列に置き換えることになる。
 (5) (4)の検索処理の結果に対する置換処理の内容を次に示す。
① 一致する文字数が3以下の場合には、圧縮列に置き換えないで、圧縮文字位置の文字を配列Compresseddataに格納する。
② 一致する文字数が4以上の場合には、その文字数が最も多い比較文字並びに対応する圧縮列を配列Compresseddataに格納する。
〔副プログラムCompressの引数の仕様〕
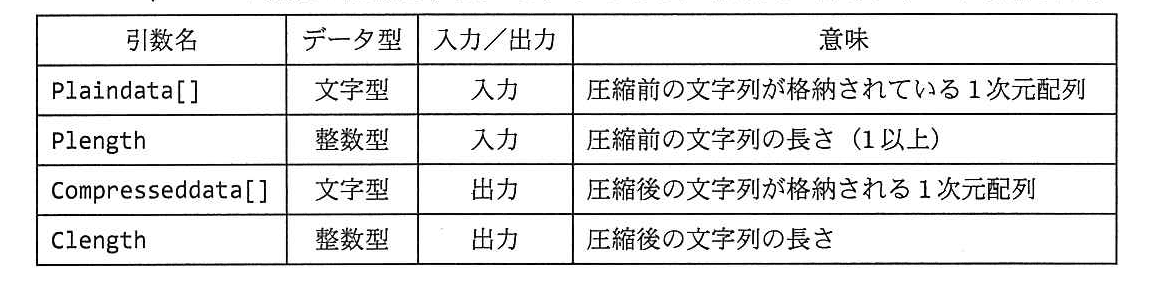
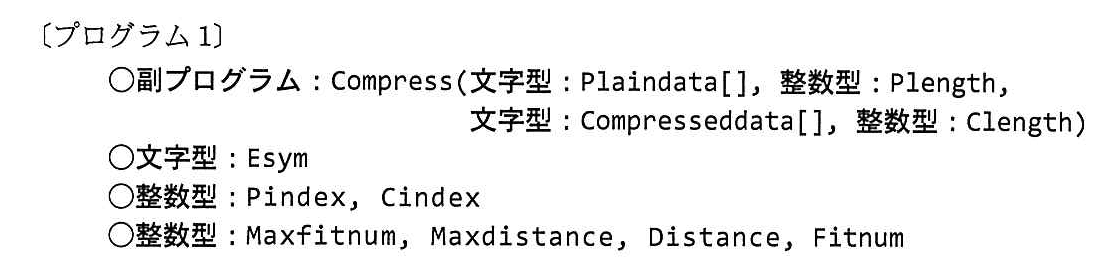
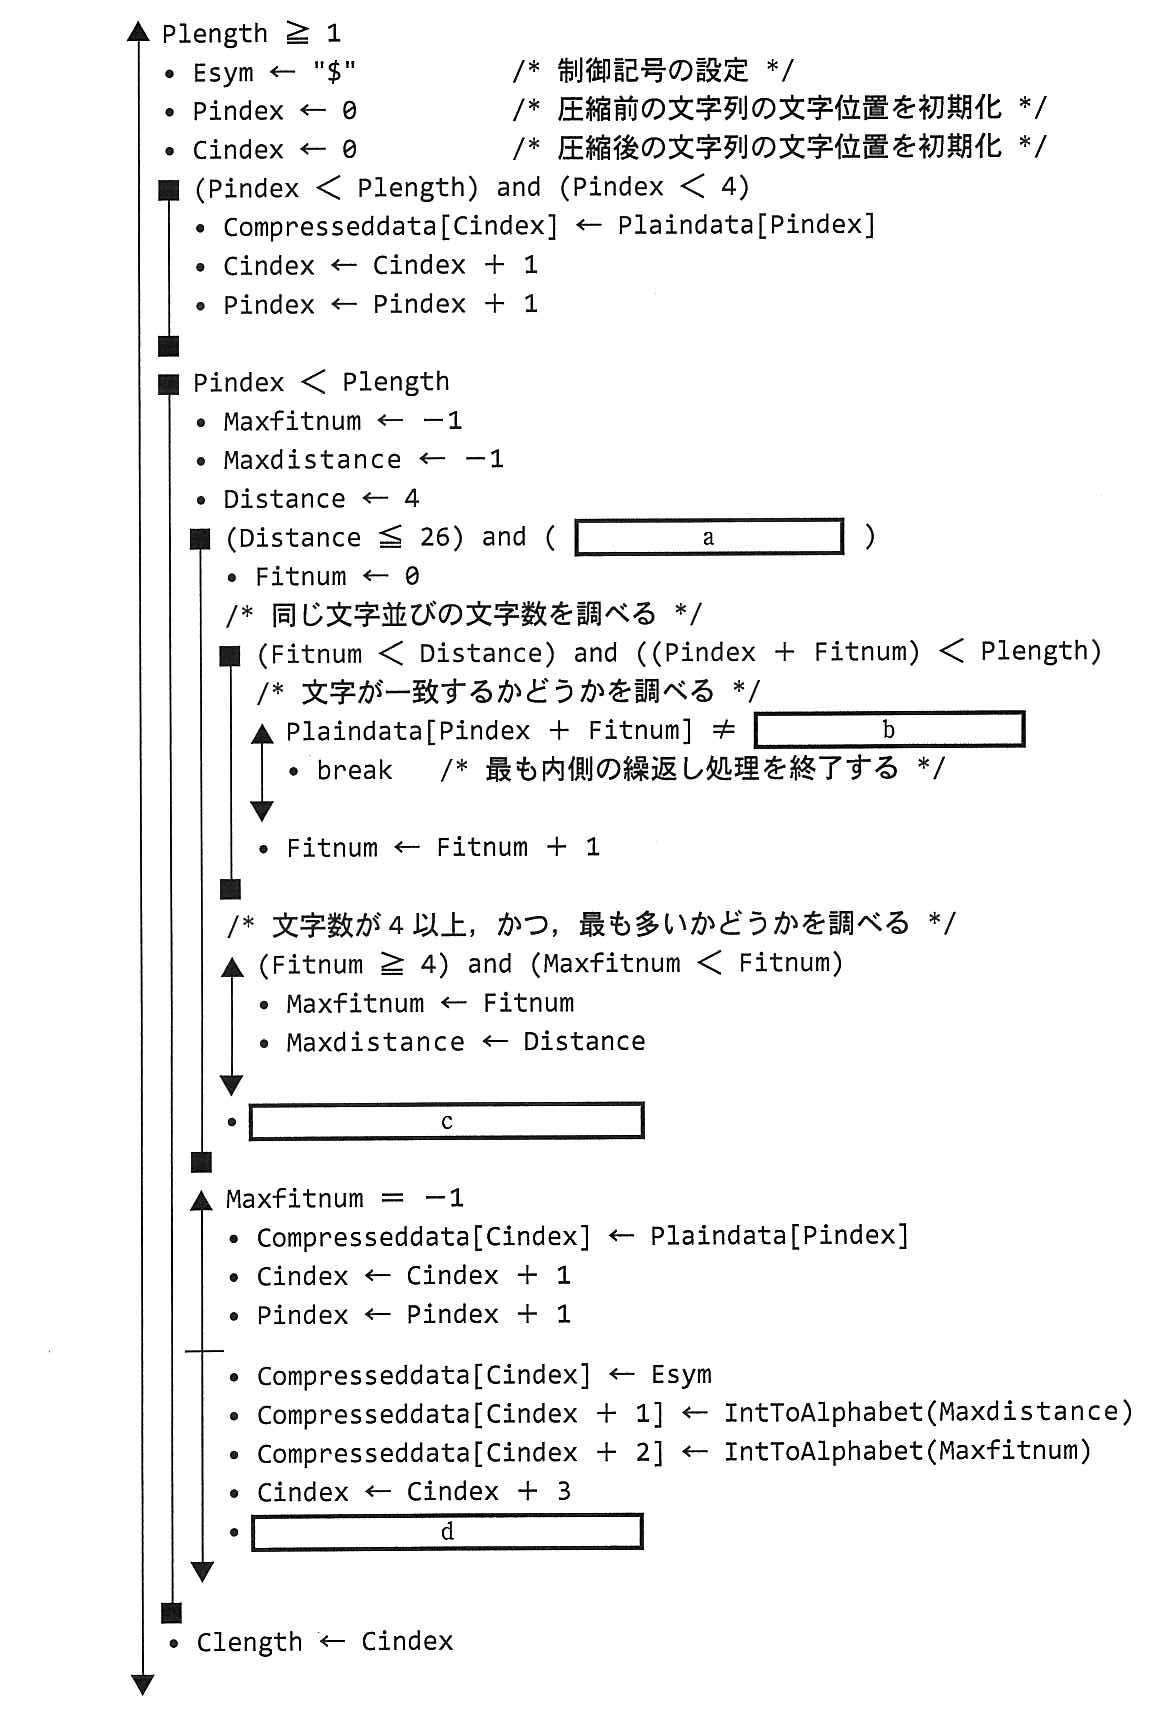
Compressの引数の仕様は、次のとおりである。各配列の添字は、0から始まる。
 〔復元処理の説明〕
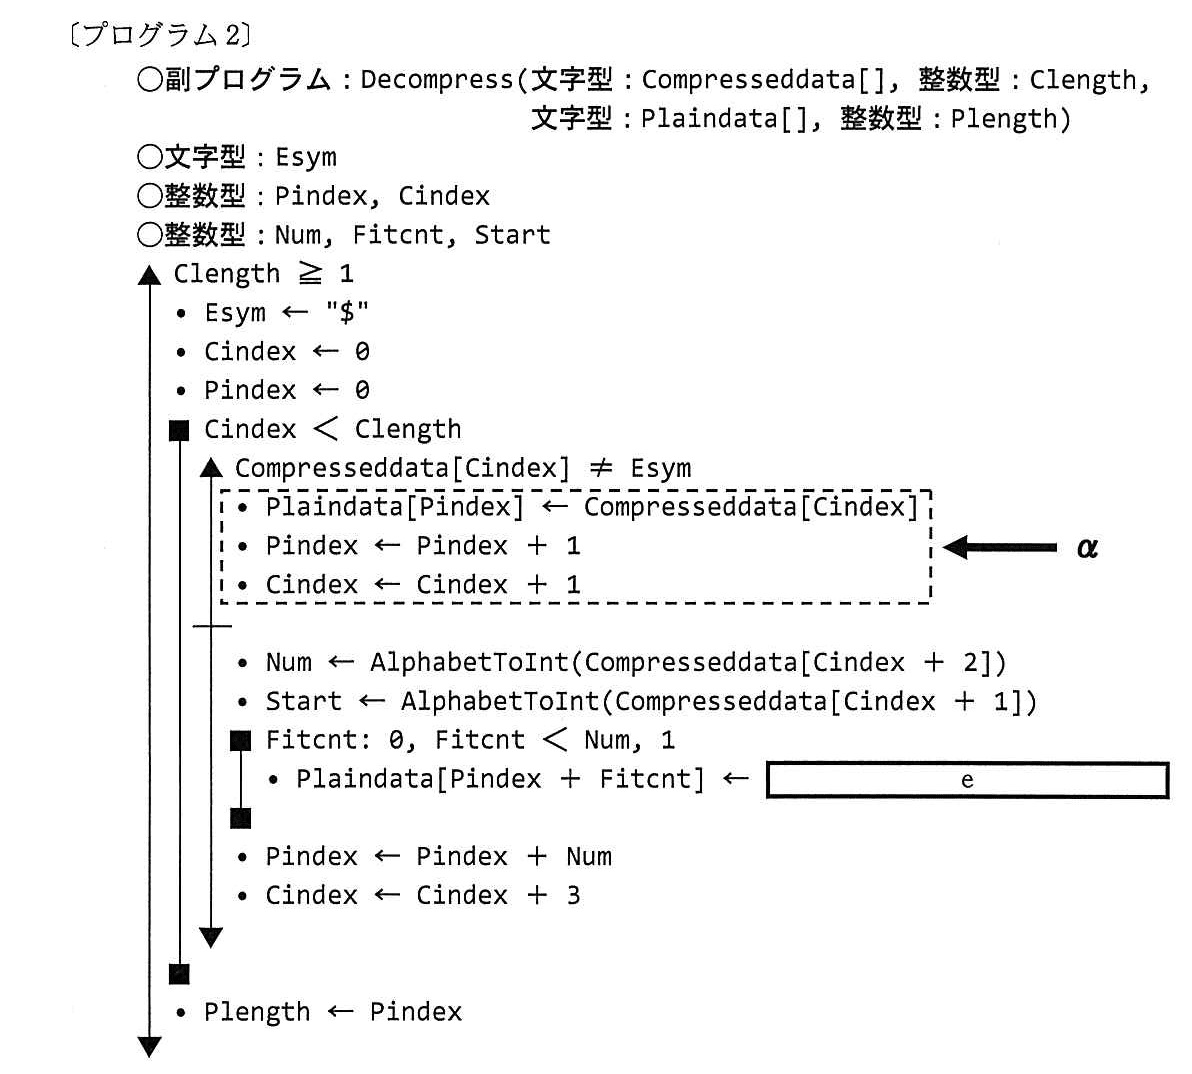
副プログラムDecompressでは、配列Compresseddataに格納されている圧縮された文字列を受け取り、復元後の文字列を配列Plaindataに格納する。復元処理の内容を次に示す。
(1) 配列Compresseddataの先頭から圧縮された文字列を順に調べる。
(2) 文字が制御記号でなければ、その文字をそのまま配列Plaindataに格納する。
(3) 文字が制御記号ならば、圧縮列の距離、文字数から、圧縮前の文字並びを復元して配列Plaindataに格納する。
〔副プログラムDecompressの引数の仕様〕
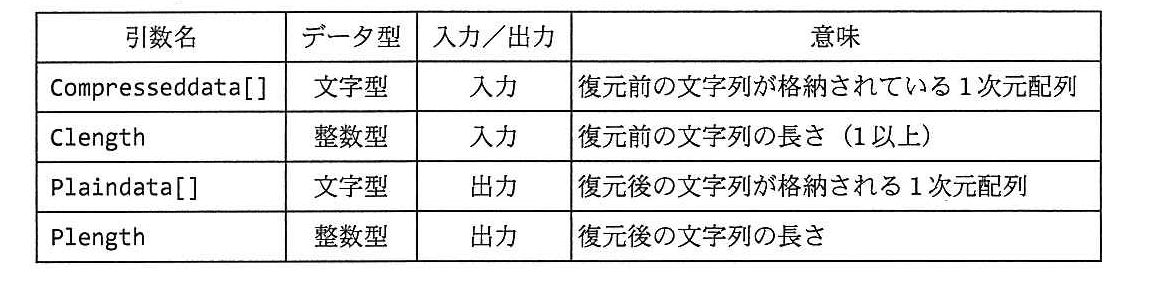
Decompressの引数の仕様は、次のとおりである。各配列の添字は、0から始まる。
副プログラムCompressとDecompressで使用している関数IntToAlphabetとAlphabetToIntの仕様は、次のとおりである。
〔関数IntToAlphabetの仕様〕
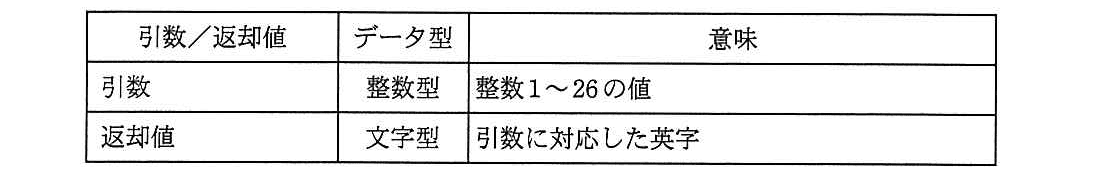
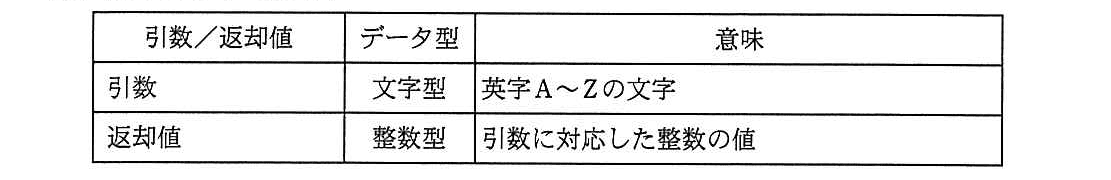
整数1~26を順に英字A~Zに変換する。IntToAlphabetの引数と返却値の仕様は、次のとおりである。
 〔関数AlphabetToIntの仕様〕
英字A~Zを順に整数1~26に変換する。AlphabetToIntの引数と返却値の仕様は、次のとおりである。
設問1:
問題文を見る プログラム中のに入れる正しい答えを、解答群の中から選べ。
aに関する解答群
ア:Pindex − Distance ≥ 0
イ:Pindex − Plength ≥ 0
ウ:Plength − Distance ≥ 0
エ:Plength − Pindex ≥ 0
bに関する解答群
ア:Plaindata[Pindex + Distance]
イ:Plaindata[Pindex + Distance + Fitnum]
ウ:Plaindata[Pindex − Distance]
エ:Plaindata[Pindex − Distance + Fitnum]
cに関する解答群
ア:Cindex ← Cindex + 1
イ:Distance ← Distance + 1
ウ:Fitnum ← Fitnum + 1
エ:Pindex ← Pindex + 1
オ:Plength ← Plength + 1
dに関する解答群
ア:Pindex ← Pindex + 1
イ:Pindex ← Pindex + 3
ウ:Pindex ← Pindex + Maxdistance
エ:Pindex ← Pindex + Maxfitnum
eに関する解答群
ア:Compresseddata[Pindex + Start + Fitcnt]
イ:Compresseddata[Pindex − Start + Fitcnt]
ウ:Plaindata[Pindex + Start + Fitcnt]
エ:Plaindata[Pindex − Start + Fitcnt]
模範解答
a:ア、b:エ、c:イ、d:エ、e:エ
解説
解答の導き方
この問題では、圧縮時に「どの文字と比べるか」「何文字一致したか」「一致した部分をどう置き換えるか」を順に考えます。復元時は、圧縮列に記録された距離と文字数を使って、元の文字列を再現します。
1. a:比較対象が文字列の先頭より前に出ない条件
圧縮文字位置をPindex、比較文字位置との距離をDistanceとすると、比較文字位置はPindex - Distanceです。
比較する文字列の位置は0から始まります。したがって、比較位置が0以上でなければなりません。問題文では、配列の添字は0から始まるとされています。
その条件は「Pindex - Distance ≥ 0」です。よって、aにはアが入ります。この条件を満たさなくなった距離では、それ以上離れた位置も比較できないため、検索を続けません。
2. b:比較する文字の位置
比較文字位置は、圧縮文字位置よりDistance文字前です。そこからFitnum文字進んだ位置の文字は、Plaindata[Pindex - Distance + Fitnum]です。
一方、圧縮文字位置からFitnum文字進んだ位置はPlaindata[Pindex + Fitnum]です。プログラムは、この2つの文字が異なるかどうかを調べています。
したがって、bにはエが入ります。
3. c:次の距離を調べる
Distanceは、比較対象が圧縮文字位置から何文字前にあるかを表します。問題文では、比較文字位置を「文字列の先頭に向かって」移動させて検索すると説明されています。
そのため、一つの距離を調べた後は、Distanceを1増やして次の比較位置を調べます。cにはイが入ります。
なお、一致した文字数Fitnumは、比較するたびに1ずつ増えています。Distanceが4のときに一致する文字が4文字より多く続いても、このプログラムではFitnum < Distanceの条件によって、比較は4文字までです。つまり、一致文字数は距離を超えません。このため、距離が4未満の比較対象を調べても、圧縮に必要な4文字以上の一致は得られません。
4. 一致した文字数のうち、最も多いものを選ぶ
プログラムは、比較位置ごとに一致した文字数を調べます。その中から、Fitnumが4以上で、これまでの最大値Maxfitnumより大きい場合に、MaxfitnumとMaxdistanceを更新します。
このようにして、4文字以上一致する比較位置のうち、一致文字数が最大のものを記録します。もし一致文字数が同じ比較位置が複数あっても、更新条件が「Maxfitnum < Fitnum」なので、先に見つかった比較位置が残ります。
5. d:圧縮した文字数だけ圧縮前の位置を進める
4文字以上一致する比較位置が見つからなければ、圧縮文字位置の1文字をそのまま出力し、Pindexを1増やします。
圧縮する場合は、圧縮列として制御記号、距離、文字数の3文字を出力します。しかし、圧縮前の文字列では、一致した文字並びの分だけ位置を進める必要があります。進める文字数はMaxfitnumです。
よって、dには「Pindex ← Pindex + Maxfitnum」が入ります。選択肢はエです。圧縮後の文字数が3文字だからといって、Pindexを3増やすわけではありません。Cindexは圧縮後の配列の位置なので3増やしますが、Pindexは圧縮前の配列の位置なので、置き換えた文字数分だけ進めます。
6. 例で圧縮位置と距離を確認する
問題文の文字列「ABCDEFABCDABCDEF」では、配列の添字が0から始まります。
- Pindexが6のとき、距離6の比較位置は添字0です。ここから「ABCD」が一致しますが、その先は一致しないため、一致文字数は4です。距離6は英字F、文字数4は英字Dで表されるので、この部分は「$FD」に置き換えられます。
- 次にPindexが10のとき、距離4の比較位置では4文字一致します。距離10の比較位置では6文字一致します。一致文字数がより多い距離10を選びます。距離10は英字J、文字数6は英字Fで表されるので、この部分は「$JF」に置き換えられます。
この例からも、距離と文字数は別々の値であり、距離は比較位置を決め、文字数は圧縮前の位置をどれだけ進めるかを決めると分かります。
7. e:復元する文字の読み取り元
Decompressでは、圧縮列から距離をStart、文字数をNumとして読み取ります。現在の復元位置PindexからStart文字前が、復元元の先頭位置です。
復元するFitcnt文字目の読み取り元は、Plaindata[Pindex - Start + Fitcnt]です。圧縮列の文字ではなく、すでに復元した配列Plaindataを読み取ります。
したがって、eにはエが入ります。復元した各文字をPlaindataに書き込み、Num文字分を書き終えたら、PindexをNum増やし、圧縮列側のCindexは圧縮列3文字分だけ進めます。
誤りやすいポイント
- DistanceとFitnumを混同すること
Distanceは「何文字前を参照するか」、Fitnumは「何文字一致したか」です。前者が距離、後者が文字数です。 - 比較位置をPindex + Distanceとしてしまうこと
比較位置は圧縮文字位置より前です。そのため、位置はPindex - Distanceになります。 - 圧縮列の出力文字数と、圧縮前の位置の進め方を混同すること
Cindexは圧縮列の3文字分だけ進みます。一方、Pindexは置き換えた元の文字数Maxfitnumだけ進みます。 - 復元元をCompresseddataから探すこと
圧縮列にあるのは距離と文字数です。復元する文字は、距離を使って復元後のPlaindataから読み取ります。 - 一致文字数が3以下でも圧縮列に置き換えること
圧縮列自体が3文字なので、4文字以上一致する場合だけ置き換えます。3文字以下なら、元の文字をそのまま出力します。
FAQ
Q: なぜ圧縮処理の最初に、先頭の4文字をそのまま出力するのですか?
A: 圧縮列に置き換えるには、4文字以上の一致が必要です。先頭付近では、それより前に比較できる文字が十分にありません。プログラムは先頭の4文字を出力してから、検索を始めます。
A: 圧縮列に置き換えるには、4文字以上の一致が必要です。先頭付近では、それより前に比較できる文字が十分にありません。プログラムは先頭の4文字を出力してから、検索を始めます。
Q: 圧縮時に調べる距離が26までなのはなぜですか?
A: 距離は1~26を英字A~Zで表します。そのため、距離が26を超える比較位置は圧縮列に記録できず、検索対象になりません。
A: 距離は1~26を英字A~Zで表します。そのため、距離が26を超える比較位置は圧縮列に記録できず、検索対象になりません。
Q: Decompressは、圧縮列のどこで距離と文字数を読み取りますか?
A: 制御記号の次の文字を距離、その次の文字を文字数として読み取ります。AlphabetToIntによって英字を整数に戻し、その値を復元に使います。
A: 制御記号の次の文字を距離、その次の文字を文字数として読み取ります。AlphabetToIntによって英字を整数に戻し、その値を復元に使います。
関連キーワード: 文字列圧縮、データ復元、配列、添字、制御記号、文字列照合

設問2:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
次の文字列を圧縮した文字列を副プログラムDecompressを使って復元する場合、プログラム2のαの部分はf回実行される。
文字列:A B C D E F G A B C D E A B C D F E F G A B C D
fに関する解答群
ア:3
イ:4
ウ:5
エ:6
オ:7
カ:8
模範解答
f:カ
解説
解答の導き方
αに進むのは、圧縮後の文字列にある「制御記号ではない文字」を、そのまま復元後の文字列に書き写す場合です。したがって、圧縮後の文字列のうち、元の文字がそのまま残っている文字の数を数えます。
まず、与えられた文字列を先頭から見て、圧縮できる並びを確認します。圧縮列は制御記号「$」と、距離・文字数を表す2文字から成るため、同じ並びが4文字以上ある場合に置き換えます。
距離と文字数を表す文字は、1をA、2をB、…、26をZとして決めます。たとえば8~12の並びは、距離が7なのでG、文字数が5なのでEとなり、圧縮列は「$GE」です。
この圧縮後の文字列で、元の文字がそのまま残っているのは、最初の「A B C D E F G」と、後半の「F」です。合計で7文字と1文字、つまり8文字です。
Decompressでは、これらの文字を1文字ずつそのまま復元するたびにαの経路を通ります。一方、「$GE」「$ED」「$MG」は圧縮列として復元されるため、その経路は通りません。よって、αは8回実行されます。
誤りやすいポイント
- 圧縮前の文字列の長さを数えないようにします。αの回数は、圧縮後の文字列でそのまま残っている文字の数です。
- 圧縮列の3文字、つまり制御記号・距離・文字数を、元の文字として数えないようにします。これらは一致する文字並びを復元するための情報です。
- 圧縮するには、過去に同じ並びがあるだけでなく、一致する文字数が4以上である必要があります。4文字未満の一致では、文字をそのまま格納します。
FAQ
Q: 「$GE」の3文字は、αの実行回数に含めますか?
A: 含めません。「$」で始まる圧縮列は、距離と文字数を使って元の並びを復元します。文字をそのまま書き写す処理ではありません。
A: 含めません。「$」で始まる圧縮列は、距離と文字数を使って元の並びを復元します。文字をそのまま書き写す処理ではありません。
Q: 一致する並びが複数ある場合、どれを使いますか?
A: 問題文では、一致する文字数が最も多い並びを選びます。一致する文字数が同じ場合でも、圧縮列は3文字なので、復元時にその圧縮列を読む回数は1回です。
A: 問題文では、一致する文字数が最も多い並びを選びます。一致する文字数が同じ場合でも、圧縮列は3文字なので、復元時にその圧縮列を読む回数は1回です。
Q: なぜ圧縮列を使うと、復元後の文字数と圧縮後の文字数が異なるのですか?
A: 圧縮列の距離と文字数を使って、元の文字並びを複数文字分復元するためです。短い圧縮列から、より長い並びを復元できます。
A: 圧縮列の距離と文字数を使って、元の文字並びを複数文字分復元するためです。短い圧縮列から、より長い並びを復元できます。
関連キーワード: データ圧縮、可逆圧縮、辞書式圧縮、制御記号、文字列照合

