
基本情報技術者 2017年 秋期 午後 問08
次のプログラムの説明及びプログラムを読んで、設問1~4に答えよ。
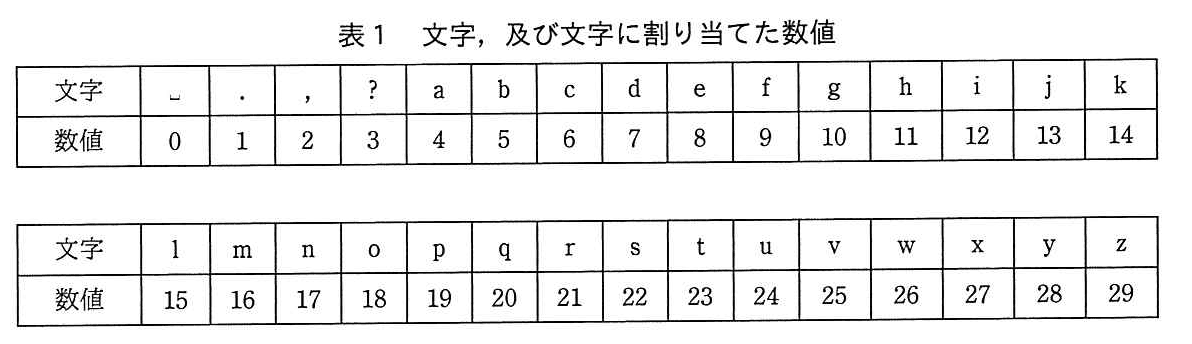
文字列の誤りを検出するために、N種類の文字に0, 1, ⋯, N−1の整数値を重複なく割り当て、検査文字を生成するプログラムと、元となる文字列の末尾に検査文字を追加した検査文字付文字列を検証するプログラムである。ここで扱う30種類の文字、及び文字に割り当てた数値を、表1に示す。空白文字は“␣”と表記する。
〔プログラムの説明〕
検査文字の生成と検査文字付文字列の検証の手順を示す。
(1) 検査文字の生成
① 文字列の末尾の文字を1番目の文字とし、文字列の先頭に向かって奇数番目の文字に割り当てた数値を2倍してNで割り、商と余りの和を求め、全て足し合わせる。
② 偶数番目の文字に割り当てた数値は、そのまま全て足し合わせる。
③ ①と②の結果を足し合わせる。
④ Nから、③で求めた総和をNで割った余りを引く。さらにその結果を、Nで割り、余りを求める。求めた数値に対応する文字を検査文字とする。
(2) 検査文字付文字列の検証
① 検査文字付文字列の末尾の文字を1番目の文字とし、文字列の先頭に向かって偶数番目の文字に割り当てた数値を2倍してNで割り、商と余りの和を求め、全て足し合わせる。
② 奇数番目の文字に割り当てた数値は、そのまま全て足し合わせる。
③ ①と②の結果を足し合わせる。
④ ③で求めた総和がNで割り切れる場合は、検査文字付文字列に誤りがないと判定する。Nで割り切れない場合は、検査文字付文字列に誤りがあると判定する。
〔検査文字付文字列の生成例〕
表1及び検査文字の生成の手順を用いることによって、文字列ipa␣␣に対し、生成される検査文字はfである。
検査文字付文字列は、文字列の末尾に検査文字を追加し、ipa␣␣fとなる。
〔プログラムの仕様〕
各関数の仕様を(1)~(4)に示す。ここで、配列の添字は1から始まるものとする。
(1) 関数calcCheckCharacterは、文字列及び文字列長を用いて生成した検査文字を返す。関数calcCheckCharacterの引数及び返却値の仕様は、表2のとおりである。
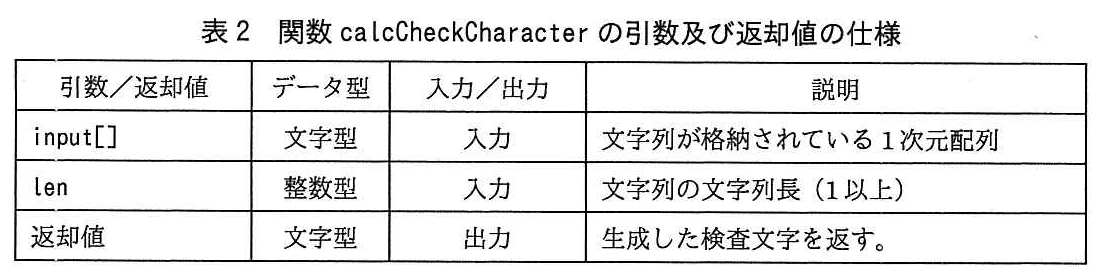
関数calcCheckCharacterは、関数getValue、関数getCharを使用する。
(2) 関数validateCheckCharacterは、検査文字付文字列を検証し、検証結果を返す。
関数validateCheckCharacterの引数及び返却値の仕様は、表3のとおりである。
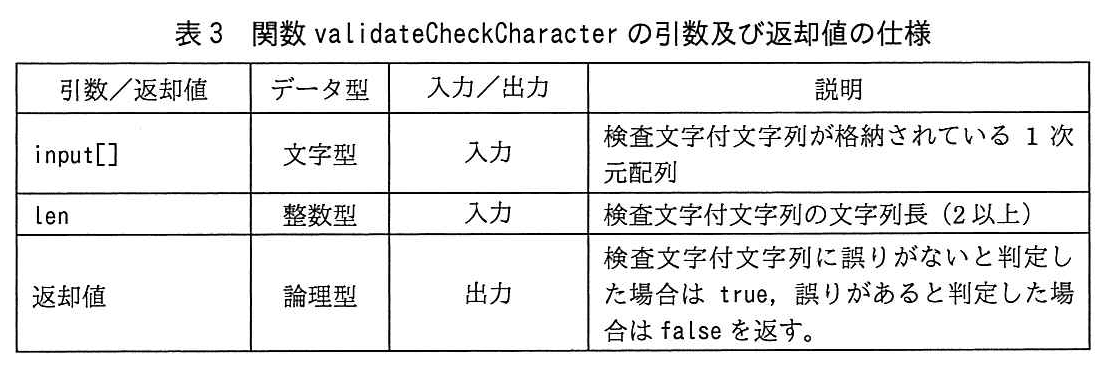 関数validateCheckCharacterは、関数getValueを使用する。
(3) 関数getValueは、表1に従い、引数として与えられた文字に割り当てた数値を返す。
(4) 関数getCharは、表1に従い、引数として与えられた数値に対応する文字を返す。
設問1:
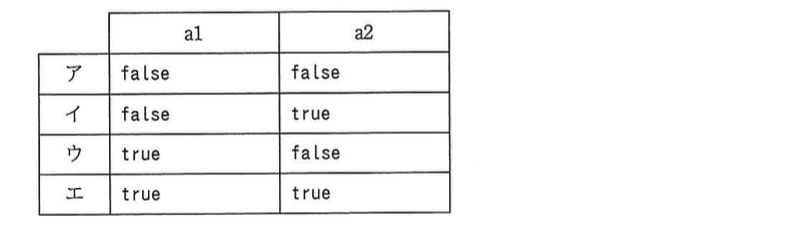
問題文を見る プログラム中のに入れる正しい答えを、解答群の中から選べ。ここで、a1とa2に入れる答えは、aに関する解答群の中から組合せとして正しいものを選ぶものとする。
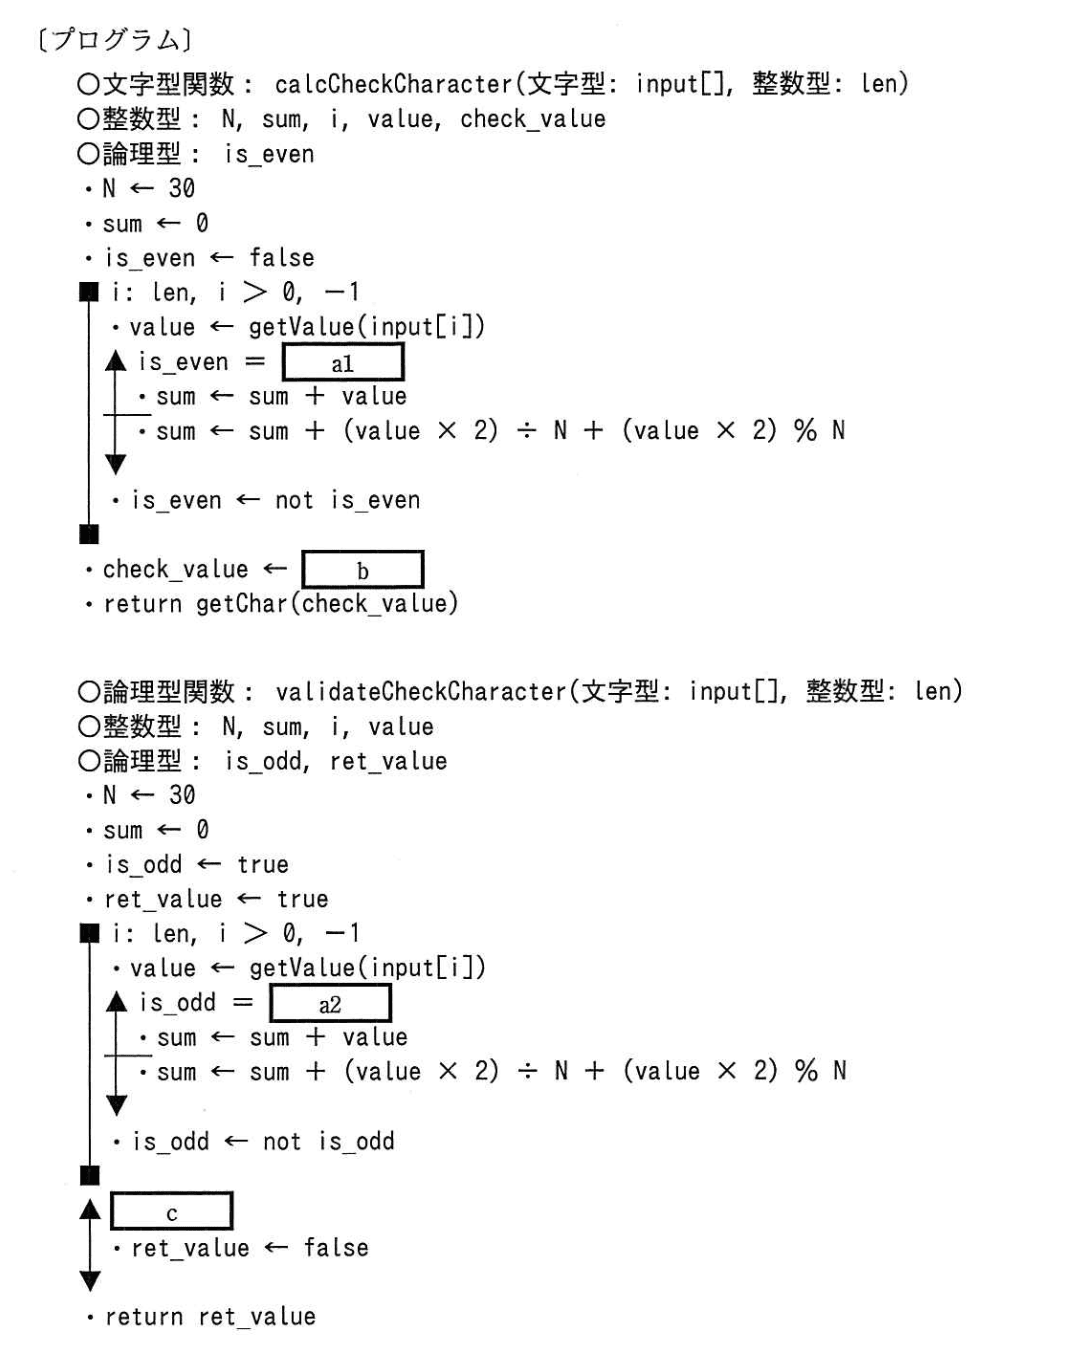
aに関する解答群
bに関する解答群
ア:N - sum % N
イ:sum % N
ウ:(N - sum % N) % N
エ:(sum - N) % N
cに関する解答群
ア:sum ÷ N = 0
イ:sum ÷ N ≠ 0
ウ:sum % N = 0
エ:sum % N ≠ 0
模範解答
a:エ、b:ウ、c:エ
解説
解答の導き方
この問題では、文字列の末尾に付ける検査文字を生成する方法と、検査文字付文字列に誤りがないかを確かめる方法を考えます。検査文字は、文字列が正しく伝わったかを確認するために追加する文字です。
a1、a2:末尾から数えた位置に応じて加算方法を選ぶ
本文では、文字列の末尾を「1番目の文字」として、先頭に向かって数えると説明されています。奇数番目と偶数番目では、割り当てられた数値の扱いが異なります。
検査文字の生成では、奇数番目の数値を2倍してから商と余りの和を求め、偶数番目の数値はそのまま足します。プログラムでは、処理を始めるとき、変数はfalseです。末尾からの1番目は奇数番目なので、ここでは2倍する計算を選ぶ必要があります。そのため、数値をそのまま足す処理を選ぶ条件は、がtrueであることになります。したがって、a1にはtrueが入ります。
検証では、生成時と反対に、偶数番目の数値を2倍して計算し、奇数番目の数値はそのまま足します。変数は処理開始時にtrueなので、末尾からの1番目では、数値をそのまま足します。そのため、数値をそのまま足す処理を選ぶ条件は、がtrueであることになります。したがって、a2にもtrueが入ります。
a1とa2の組合せは、解答群のエです。
b:総和から検査文字の数値を求める
本文の生成手順では、まず総和をで割った余りを求め、それをから引きます。さらに、その結果をで割った余りが検査文字の数値になります。
式にすると、次のとおりです。
これは解答群のウです。
最後にもう一度余りを求める理由は、総和がで割り切れる場合にも、検査文字の数値をにするためです。たとえば総和がで割り切れると、最初の引き算の結果はになります。これをで割った余りはです。表1にある数値はからまでなので、この処理により、検査文字に対応する数値の範囲に収まります。
生成例の文字列ipa␣␣を使って計算を確かめます。末尾からの位置に応じた加算値は、次のようになります。
奇数番目の文字は、数値を2倍してからで割り、商と余りを足します。たとえば、3番目のaは数値がなので、です。をで割ると商は、余りはなので、加算値はです。
総和はです。検査文字の数値は、次のとおりです。
表1で数値に対応する文字はfなので、生成例の検査文字はfです。
c:総和がで割り切れるかを判定する
本文には、総和がで割り切れる場合は誤りがなく、割り切れない場合は誤りがあるとあります。したがって、総和をで割った余りがでないときに、検証結果をfalseにします。
「余りがでない」は、解答群の「sum % N ≠ 0」に当たります。よって、cはエです。
生成例の検査文字を付けたipa␣␣fを検証すると、末尾から順に加算値はです。総和はで、をで割った余りはです。そのため、この文字列は誤りがないと判定されます。
誤りやすいポイント
- 文字の位置は、先頭からではなく末尾から数えます。末尾の文字が1番目です。
- 生成時と検証時では、2倍する位置が逆です。生成時は奇数番目、検証時は偶数番目を2倍します。
- 2倍した値をそのまま足すのではありません。で割った商と余りを足します。たとえば、をで割る場合は、商のと余りのを足してです。
- 検査文字の数値は、総和をで割った余りそのものではありません。からその余りを引き、さらにで割った余りを求めます。
- 誤りの判定では、商ではなく余りを見ます。余りがなら総和はで割り切れています。
FAQ
Q: ÷と%は、それぞれ何を表しますか?
A: ÷は整数の商を求める演算、%は割り算の余りを求める演算です。たとえば、の商はで、の余りはです。
A: ÷は整数の商を求める演算、%は割り算の余りを求める演算です。たとえば、の商はで、の余りはです。
Q: bの式で、最後にもう一度で割った余りを求めるのはなぜですか?
A: 総和がで割り切れる場合に、検査文字の数値をにするためです。最後に余りを求めないと、その場合の計算結果がになり、表1にある数値の範囲から外れてしまいます。
A: 総和がで割り切れる場合に、検査文字の数値をにするためです。最後に余りを求めないと、その場合の計算結果がになり、表1にある数値の範囲から外れてしまいます。
Q: 検証で「誤りがない」と判定されれば、文字列が絶対に変更されていないと言えますか?
A: このプログラムは、計算した総和がで割り切れるかどうかで判定します。判定の意味は、問題文に示された検査方法の範囲内で理解してください。
A: このプログラムは、計算した総和がで割り切れるかどうかで判定します。判定の意味は、問題文に示された検査方法の範囲内で理解してください。
関連キーワード: 検査文字、チェックサム、剰余演算、整数除算、誤り検出

設問2:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
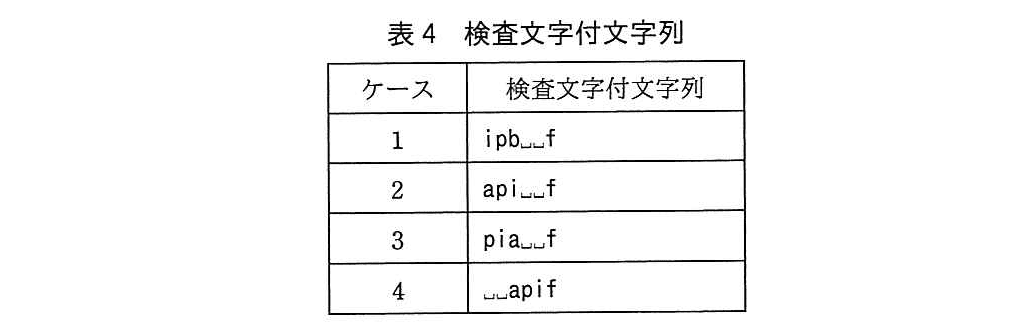
本プログラムでは、検査文字付文字列の誤りが1文字であれば、誤りを検出できる。しかし、複数の文字に誤りがある場合には、誤りがないと判定されることがある。例えば、関数validateCheckCharacterで表4に示す検査文字付文字列を検証した場合、誤りがないと判定されるケースはd。ここで、文字列ipa␣␣に対し生成される検査文字はfである。
dに関する解答群
ア:1と2と3と4である
イ:2である
ウ:2と3である
エ:2と3と4である
オ:2と4である
カ:ない
模範解答
d:オ
解説
解答の導き方
検査文字は、元の文字列に誤りがないかを確かめるため、文字列の末尾に付ける文字です。本問では、文字の数値から検査用の値を計算するチェックサム(データの誤りを確かめるため、データから計算する値)の考え方を使っています。
表1には30種類の文字があり、空白の値は0です。表4の□は空白文字として扱います。検証では、問題文に「末尾の文字を1番目の文字」とあるので、文字列の右端から数えます。
この問題では です。末尾から数えて、奇数番目の文字は割り当てられた数値をそのまま使います。偶数番目の文字は、数値を2倍し、30で割った商と余りを足します。最後に全ての値を合計し、問題文にあるとおり、その総和が30で割り切れれば誤りなしと判定します。
たとえば、文字の値が19で偶数番目にある場合は、 です。38を30で割ると、商は1、余りは8なので、この文字の寄与は になります。余りの8だけを使うのではない点に注意してください。
表4の各ケースについて、右端から数えた文字と、それぞれの寄与を並べます。
各ケースで使った値を確認します。
- ケース1では、4番目のbの値は5なので、 です。総和は となり、30で割り切れません。
- ケース2では、4番目のiの値は12なので、 です。6番目のaの値は4なので、 です。総和は となり、30で割り切れます。
- ケース3では、4番目のaの寄与は8です。6番目のpの値は19なので、 を30で割った商と余りの和は です。総和は となり、30で割り切れません。
- ケース4では、2番目のiの寄与は24、4番目のaの寄与は8です。総和は となり、30で割り切れます。
したがって、誤りがないと判定されるのはケース2とケース4です。解答群ではオに当たります。文字列には誤りがあっても、計算した総和が30で割り切れる場合があるためです。
誤りやすいポイント
- 文字の位置を文字列の先頭から数えてしまうことです。検証では、末尾から数えます。
- 奇数番目と偶数番目に適用する計算を逆にしてしまうことです。末尾から数えて、奇数番目はそのまま、偶数番目は2倍して商と余りの和を求めます。
- 2倍した値を30で割った余りだけで計算してしまうことです。商も足します。たとえば、値が19なら寄与は8ではなく9です。
- 空白文字を計算から完全に無視してしまうことです。空白の値は0ですが、文字の位置を数えるときには含めます。空白の位置を飛ばすと、奇数番目と偶数番目の判定がずれることがあります。
- 「誤りなし」という判定を、文字列が元の文字列と同じという意味に取り違えることです。この検査では、誤りがあっても総和が30で割り切れると、誤りを検出できません。
FAQ
Q: 空白の値が0なら、文字列から取り除いてもよいですか?
A: 取り除いてはいけません。空白の寄与は0ですが、位置を数える対象には含めます。空白を取り除くと、その後の文字が奇数番目か偶数番目か変わることがあります。
A: 取り除いてはいけません。空白の寄与は0ですが、位置を数える対象には含めます。空白を取り除くと、その後の文字が奇数番目か偶数番目か変わることがあります。
Q: ケース2とケース4は、なぜ誤りがあるのに誤りなしと判定されますか?
A: 検証では各文字を個別に正しいか調べるのではなく、寄与の総和が30で割り切れるかを調べます。ケース2とケース4では、文字列は元と異なりますが、総和がどちらも60になるため、誤りなしと判定されます。
A: 検証では各文字を個別に正しいか調べるのではなく、寄与の総和が30で割り切れるかを調べます。ケース2とケース4では、文字列は元と異なりますが、総和がどちらも60になるため、誤りなしと判定されます。
Q: 総和が30で割り切れない場合はどうなりますか?
A: 検査文字付文字列に誤りがあると判定されます。30で割り切れる場合は、この検査方法では誤りを検出できなかったという意味であり、文字列が必ず正しいとは限りません。
A: 検査文字付文字列に誤りがあると判定されます。30で割り切れる場合は、この検査方法では誤りを検出できなかったという意味であり、文字列が必ず正しいとは限りません。
関連キーワード: 検査文字、チェックサム、剰余、誤り検出、文字値
設問3:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
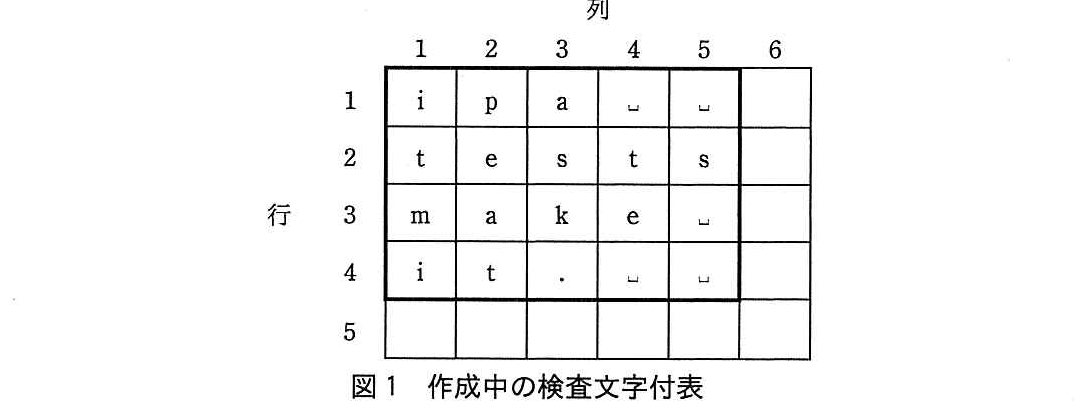
本プログラムを文字列長が同じである複数の文字列に対して適用することを考える(図1参照)。
〔考え方〕
文字列長がnであるm個の文字列について考える。文字列に対して、(m+1)行(n+1)列の表を用意する。以後、この表を検査文字付表という。
(1) 検査文字の生成
例えば、文字列長が5である4個の文字列 ipa␣␣, tests, make␣, it.␣␣ を、図1の太枠内のように、各文字列の先頭の位置を最左列に揃え、各文字列を上の行から順に格納して、表を作成する。この表の太枠内の各行各列をそれぞれ文字列とみなして検査文字を生成し、最右列と最下行に格納する。
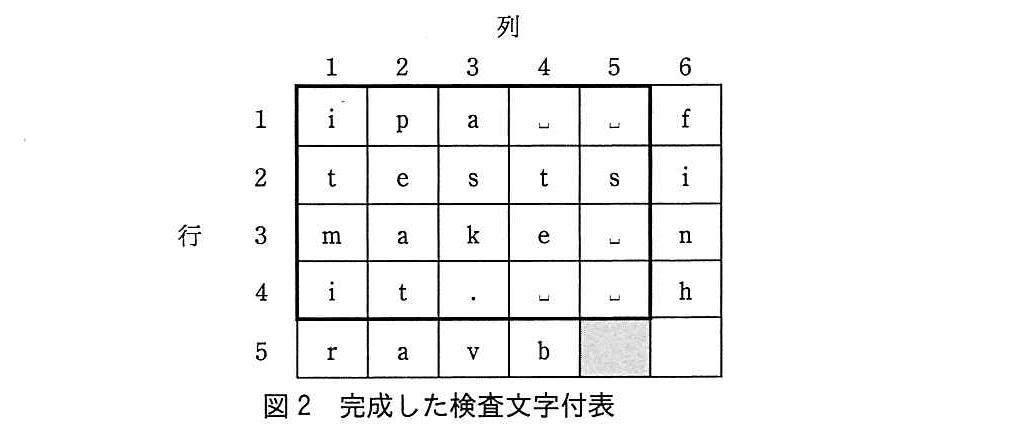
この手順で作成した検査文字付表を図2に示す。作成した検査文字付表の5行5列目(網掛け部分)の検査文字はeである。
(2) 検査文字付表の検証
(1)で作成した検査文字付表の、最下行を除く各行と最右列を除く各列を文字列とみなし、それぞれ関数validateCheckCharacterで検証した結果、全て誤りがないと判定された場合には、検査文字付表に誤りがないと判定する。一つでも誤りがあると判定された場合は、検査文字付表に誤りがあると判定する。
eに関する解答群
ア:j
イ:k
ウ:l
エ:m
模範解答
e:ウ
解説
解答の導き方
求めるのは、検査文字付表の5行5列目に入る文字です。図2では、各列の一番下に、その列の上から4文字をもとに生成した検査文字を入れています。したがって、5行5列目は、5列目の「␣、s、␣、␣」から生成します。
ここで、空白文字「␣」は値が0です。また、表1ではsの値は22です。検査文字を生成するときは、文字列の末尾から数えるため、5列目の文字は次の順番になります。
奇数番目の文字は値を2倍して商と余りを足し、偶数番目の文字は値をそのまま使います。よって、合計はです。
最後に、を合計を30で割った余りから引き、その結果を30で割った余りを求めます。
表1で値15に対応する文字はlです。したがって、5行5列目にはlが入ります。
誤りやすいポイント
- 文字の位置は表の上からではなく、列の末尾から数えます。この場合、行4の文字が1番目、行3の文字が2番目です。
- 空白文字「␣」も文字として扱います。空白を読み飛ばすのではなく、値0として計算します。
- 奇数番目の値を2倍した後は、2倍した値そのものを足すのではありません。30で割った商と余りを足します。
FAQ
Q: なぜ、5行5列目は5列目の文字から求めるのですか?
A: 表の一番下の行には、各列の上の文字列から生成した検査文字が入るためです。5列目の検査文字を求めるには、5列目の上から4文字を使います。
A: 表の一番下の行には、各列の上の文字列から生成した検査文字が入るためです。5列目の検査文字を求めるには、5列目の上から4文字を使います。
Q: 空白文字が複数ある場合、計算から省いてもよいですか?
A: 省けません。空白文字も文字列の一部であり、位置を決めるときに数えます。ただし、割り当てられた値が0なので、加算する値は0になります。
A: 省けません。空白文字も文字列の一部であり、位置を決めるときに数えます。ただし、割り当てられた値が0なので、加算する値は0になります。
Q: 2倍した値を30で割るのはなぜですか?
A: 文字に割り当てた値が0から29までの30種類だからです。奇数番目では、2倍した値を30で割った商と余りを使い、検査文字の計算に取り入れます。
A: 文字に割り当てた値が0から29までの30種類だからです。奇数番目では、2倍した値を30で割った商と余りを使い、検査文字の計算に取り入れます。
関連キーワード: 検査文字、チェックサム、誤り検出、剰余演算、配列
設問4:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
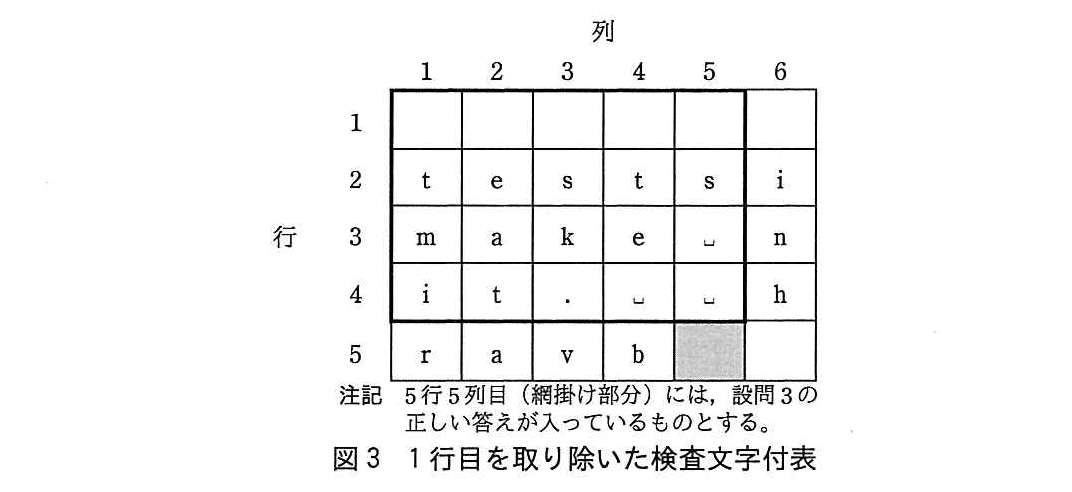
図2の1行目の検査文字付文字列を取り除いた、図3の検査文字付表について考える。表4のケース1~4の検査文字付文字列を順に、図3の1行目に格納して検証した場合、検査文字付表に誤りがないと判定されるケースはf。
fに関する解答群
ア:1と2と3と4である
イ:2である
ウ:2と3である
エ:2と3と4である
オ:2と4である
カ:ない
模範解答
f:カ
解説
解答の導き方
図3の1行目に表4の各ケースを入れたとき、検査文字付表全体が「誤りがない」と判定されるかを調べます。判定には、1行目の検査だけでなく、最下行を除く各行と最右列を除く各列の検査がすべて通る必要があります。
検査では、末尾から数えて奇数番目の文字は割り当てられた数値をそのまま使い、偶数番目の文字は数値を2倍してから商と余りの和を使います。ここで なので、偶数番目の文字に対する計算を
と表します。 は文字に割り当てられた数値です。検査に使う合計が で割り切れれば、その文字列は誤りがないと判定されます。
まず、各ケースの1行目を検査します。
1行目は6文字なので、左から見たとき、1文字目、3文字目、5文字目には を使い、2文字目、4文字目、6文字目は数値をそのまま使います。たとえばケース1の1文字目はiなので、寄与は です。
1行目は6文字なので、左から見たとき、1文字目、3文字目、5文字目には を使い、2文字目、4文字目、6文字目は数値をそのまま使います。たとえばケース1の1文字目はiなので、寄与は です。
ケース1とケース3は、1行目の合計が で割り切れないため、この時点で誤りありと判定されます。ケース2とケース4は、1行目の検査だけなら通ります。しかし、それだけでは検査文字付表全体が正しいとはいえません。
次に、列の検査を調べます。
図3では、各列の最下行にある検査文字は、図2で元の1行目を使って作成したものです。列の検査では、最下行の検査文字から数え始めます。列は5文字なので、一番上の文字は5番目、つまり奇数番目に当たり、割り当てられた数値をそのまま使います。
図3では、各列の最下行にある検査文字は、図2で元の1行目を使って作成したものです。列の検査では、最下行の検査文字から数え始めます。列は5文字なので、一番上の文字は5番目、つまり奇数番目に当たり、割り当てられた数値をそのまま使います。
列5の最下行の検査文字も確認します。元の列5のデータは、上から␣、s、␣、␣です。末尾から数えて3番目に当たるsの寄与は で、他の␣の寄与はすべてです。合計はなので、検査文字の数値は となり、文字はlです。
元の1行目がある場合の各列の検査合計は、次のとおりです。列1の「17」や「24」のように、偶数番目の文字には を使っています。
いずれも で割り切れます。候補の文字列に差し替えると、変更された文字がある列の合計が変わります。一番上の文字は列の検査合計にそのまま加わるため、その列の合計は「元の合計+新しい文字の数値-元の文字の数値」で求められます。
どのケースにも、 で割り切れない列があります。したがって、ケース2とケース4も、1行目の検査は通りますが、列の検査で誤りありと判定されます。全行・全列の検査がすべて通るケースはないため、該当する選択肢は「カ:ない」です。
誤りやすいポイント
- 1行目の検査が通っただけで、検査文字付表全体も正しいと判断しないでください。列の検査もすべて通る必要があります。
- 末尾から数える奇数番目・偶数番目を、左端から数えてしまわないようにします。1行目は6文字、列は5文字なので、左端から見たときに変換する位置が異なります。
- 割り当てられた数値の合計だけでなく、 で割った余りまで確認します。余りがでなければ、誤りありと判定されます。
FAQ
Q: 1行目の検査に通ったケース2とケース4が、なぜ正しいと判定されないのですか?
A: 1行目の検査は、横方向の文字列だけを調べています。図3では列も検査するため、1行目の文字が変わると、その文字を含む列の合計も変わり、検査に通らなくなります。
A: 1行目の検査は、横方向の文字列だけを調べています。図3では列も検査するため、1行目の文字が変わると、その文字を含む列の合計も変わり、検査に通らなくなります。
Q: 列の検査で、一番上の文字はなぜ数値をそのまま使うのですか?
A: 列の検査は一番下の検査文字から始めます。列は5文字なので、一番上の文字は末尾から数えて5番目、つまり奇数番目です。奇数番目は数値をそのまま使います。
A: 列の検査は一番下の検査文字から始めます。列は5文字なので、一番上の文字は末尾から数えて5番目、つまり奇数番目です。奇数番目は数値をそのまま使います。
Q: 文字を1文字変えただけで、列の合計が必ず変わるのですか?
A: この問題では、各文字に異なる数値が割り当てられています。一番上の文字は列の合計にそのまま加わるため、別の文字に置き換えると、その列の合計が変わります。
A: この問題では、各文字に異なる数値が割り当てられています。一番上の文字は列の合計にそのまま加わるため、別の文字に置き換えると、その列の合計が変わります。
関連キーワード: 検査文字、チェックサム、剰余演算、誤り検出、二次元チェック

