
基本情報技術者 2018年 秋期 午後 問11
次のJavaプログラムの説明及びプログラムを読んで、設問1,2に答えよ。
〔プログラムの説明〕
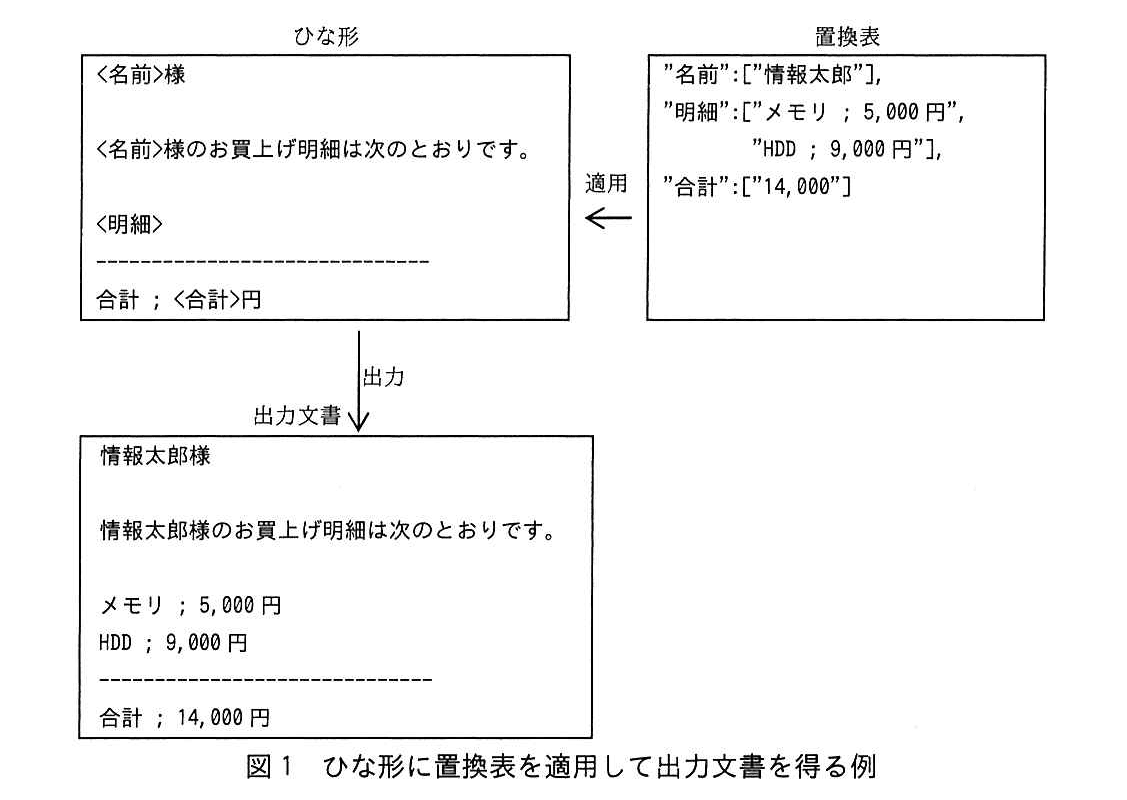
図1のように、文書の書式を表すひな形に置換表を適用して、出力文書を得るプログラムである。
(1) ひな形は、0個以上の置換指示と、0個以上のそのまま出力される置換指示以外の部分が連なるテキストである。
置換指示は、キー名称を < と > で囲ったものである。ひな形中で、< と > は、置換指示としてキー名称を囲う用途にだけ使用できる。
(2) 置換表は、キー名称とこれに対応する文字列の並びとの組みを一つ以上記述したテキストであり、それぞれの組みは、次の形式で記述する。
“キー名称”:[文字列の並び]
組みを二つ以上記述するときは、コンマで区切る。
文字列の並びには、置換に用いる文字列(以下、置換用文字列という)を二重引用符で囲んだものを一つ以上記述する。置換用文字列を二つ以上記述するときは、コンマで区切る。例えば、置換用文字列が二つである場合は、次の形式で記述する。
“キー名称”:[“置換用文字列”,“置換用文字列”]
(3) ひな形に置換表を適用すると、ひな形中の<キー名称>は、次の規則に従って置換される。
① 置換表のキー名称に対応する文字列の並びに含まれる置換用文字列が一つだけのときは、その置換用文字列で置換される。
② 置換表のキー名称に対応する文字列の並びに含まれる置換用文字列が二つ以上あるときは、各置換用文字列の間に改行を挟んだ上で、並び順に連結してできる文字列で置換される。
図1の例では、置換表中のキー名称 名前 に対応する文字列の並びに含まれる置換用文字列は 情報太郎 だけなので、ひな形中の<名前>は、情報太郎に置換される。
置換表中のキー名称 明細 に対応する文字列の並びには、置換用文字列としてメモリ ; 5,000円とHDD ; 9,000円とが含まれるので、ひな形中の<明細>は、メモリ ; 5,000円↵HDD ; 9,000円(↵は改行)に置換される。
このプログラムでは、ひな形を、0個以上の置換指示と0個以上の置換指示以外の部分が連なる文字ストリームとして扱う。個々の置換指示及び個々の置換指示以外の部分をフラグメントと呼ぶ。
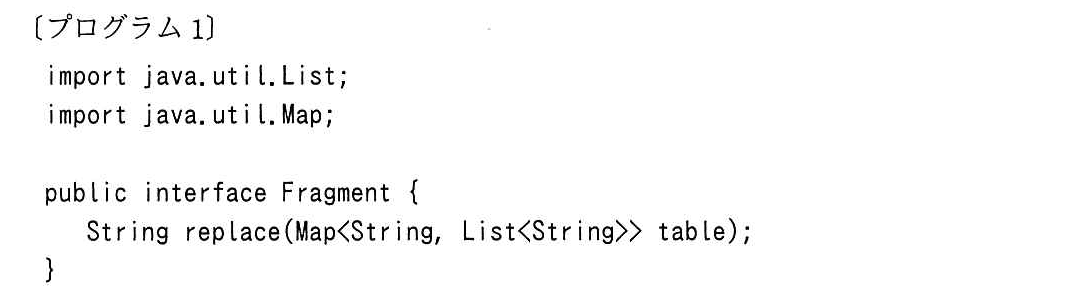
インタフェースFragmentは、フラグメントを表す。
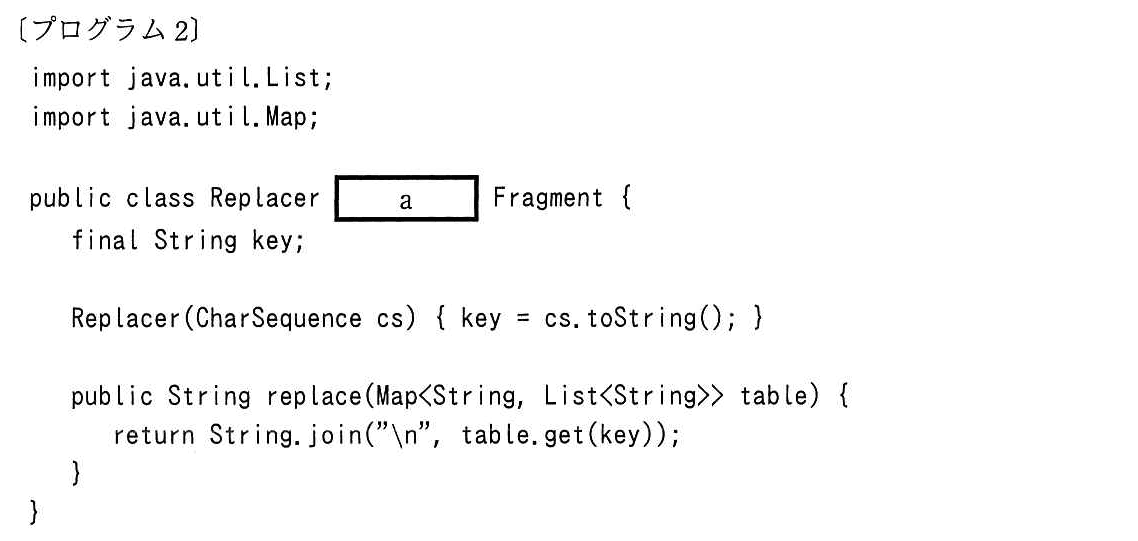
クラスReplacerは、置換指示を表す。
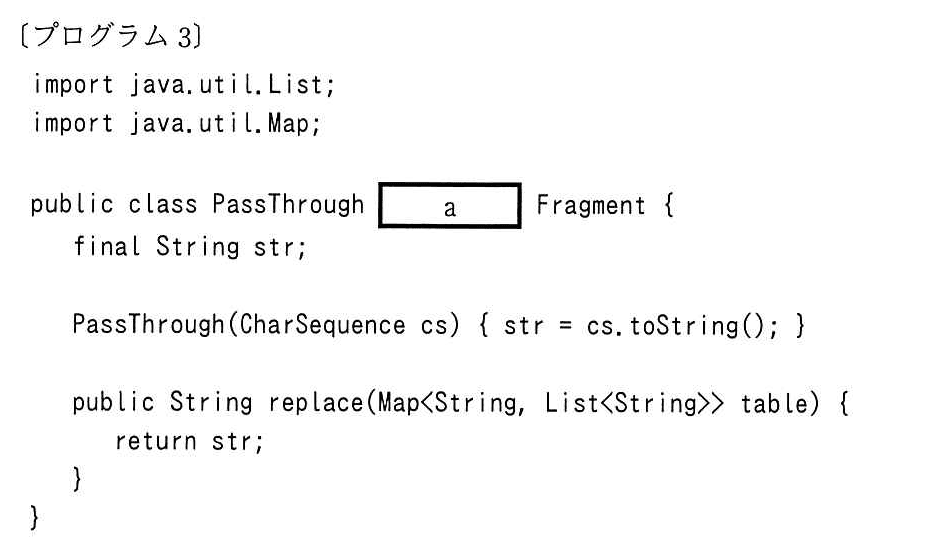
クラスPassThroughは、置換指示以外の部分を表す。
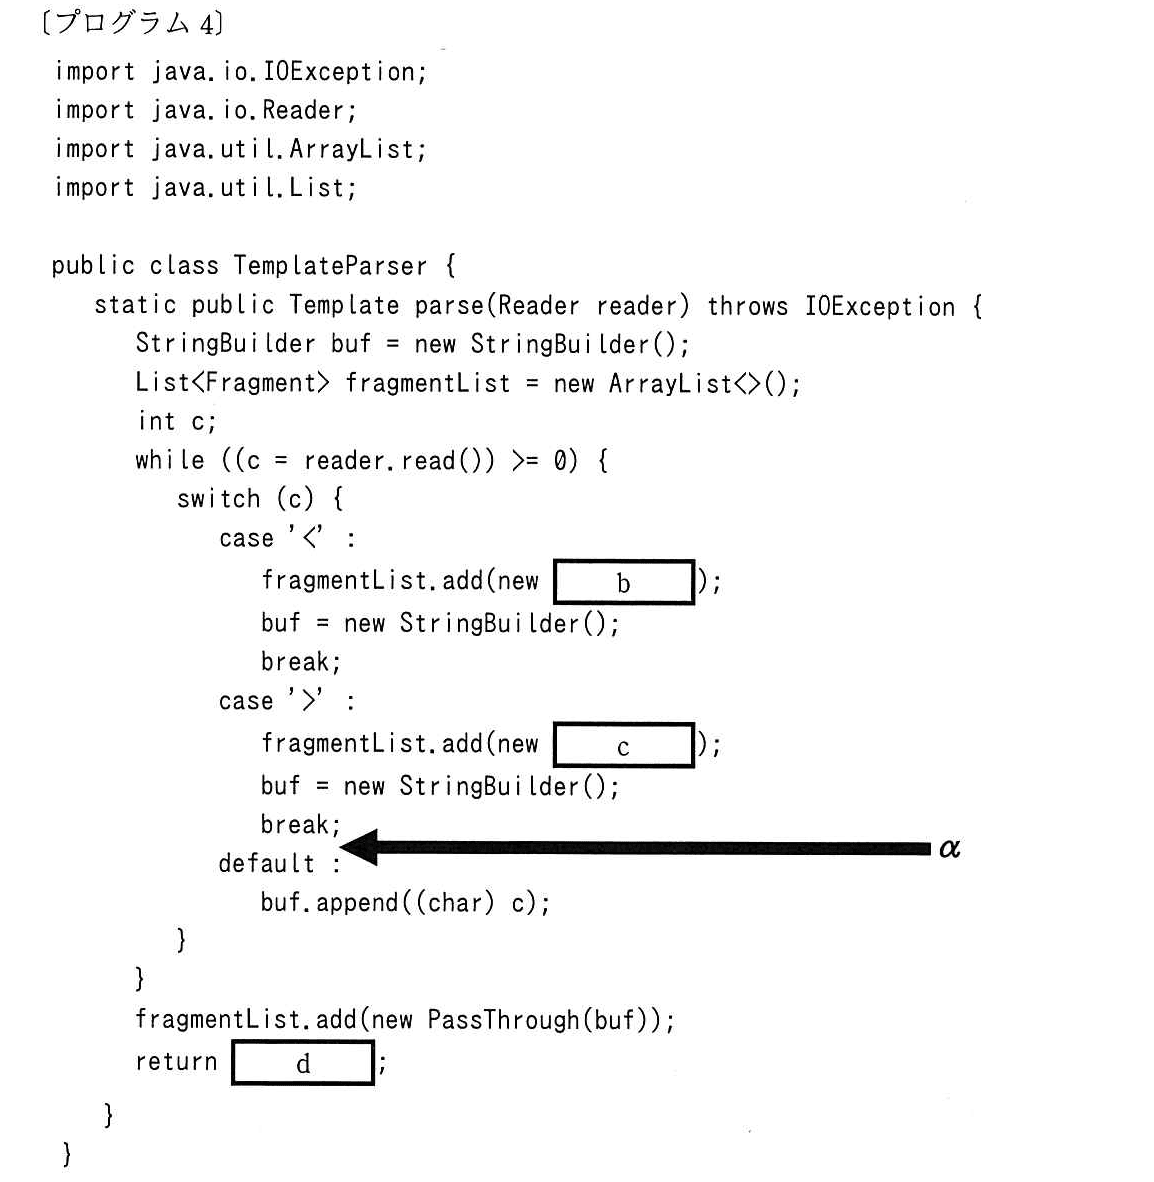
クラスTemplateParserのメソッドparseは、ひな形を表す文字ストリームからフラグメントのリストを構築し、クラスTemplateのインスタンスを生成して返す。ひな形に誤りはないものとする。
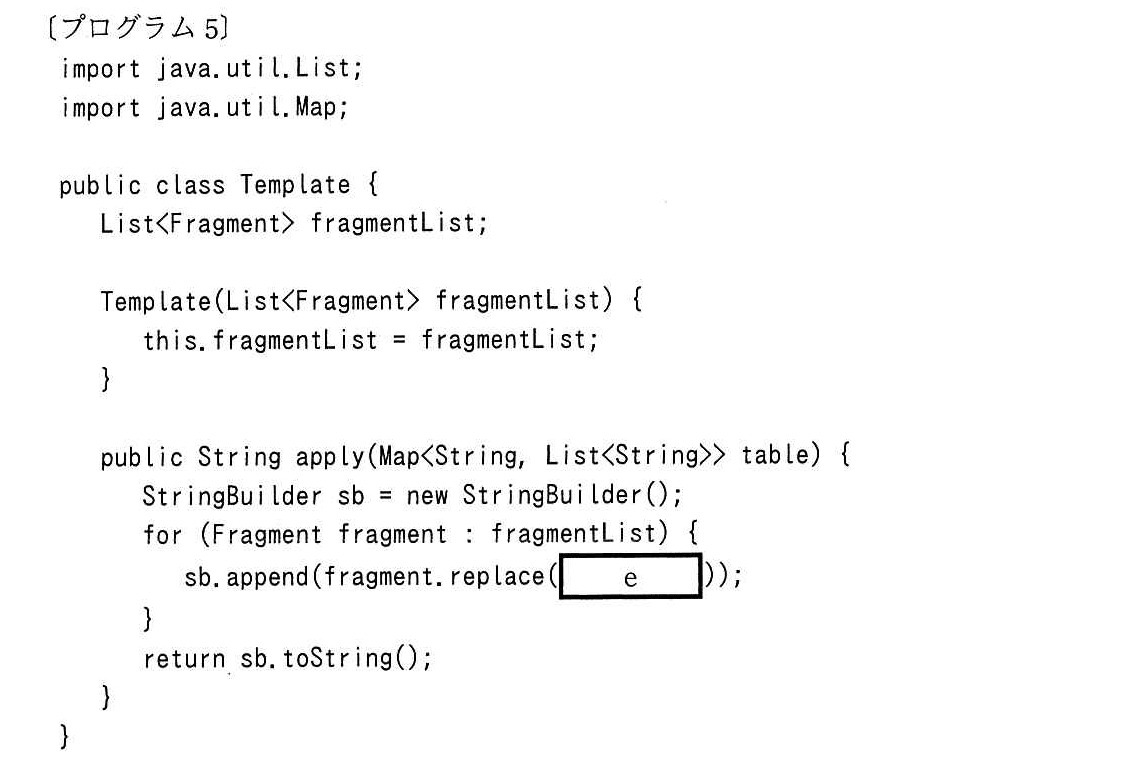
クラスTemplateは、ひな形をフラグメントのリストとして保持する。メソッドapplyは、ひな形に置換表を適用して、出力文書を文字列で返す。置換表には、このひな形に含まれるキー名称とそれに対応する文字列の並びが含まれているものとする。
クラスReplacementTableParserのメソッドparseは、置換表を表す文字ストリームから、キー名称とそれに対応する文字列の並びのマップを構築して、返す。置換表に誤りはないものとする(プログラムは省略)。
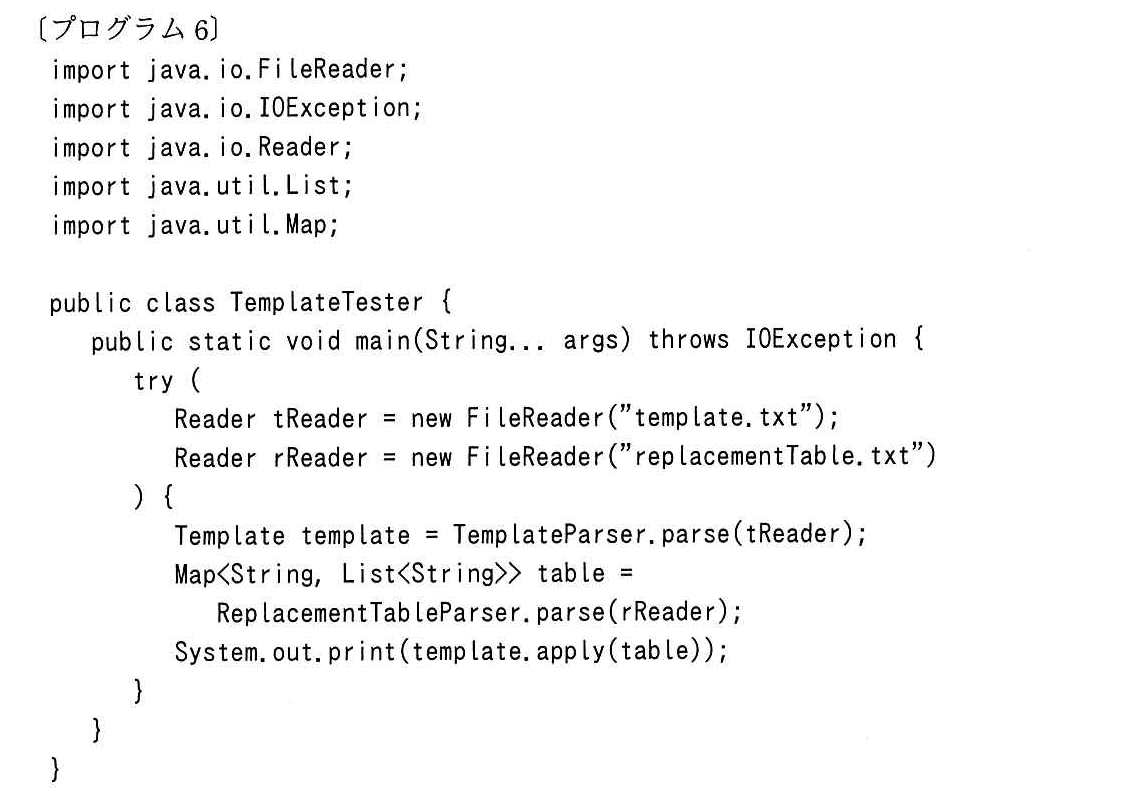
クラスTemplateTesterはテスト用のプログラムである。テキストファイルtemplate.txtが図1のひな形と同じ内容であって、テキストファイルreplacementTable.txtが図1の置換表と同じ内容であるとき、実行結果は図1の出力文書と同じになる。
設問1:
問題文を見る プログラム中のに入れる正しい答えを、解答群の中から選べ。
aに関する解答群
ア:extends
イ:interface
ウ:implements
エ:throws
b, cに関する解答群
ア:Fragment(buf)
イ:Fragment(c)
ウ:PassThrough(buf)
エ:PassThrough(c)
オ:Replacer(buf)
カ:Replacer(c)
dに関する解答群
ア:fragmentList
イ:new Template(buf)
ウ:new Template(fragmentList)
エ:new Template(reader)
eに関する解答群
ア:fragment
イ:fragmentList
ウ:sb
エ:table
模範解答
a:ウ、b:ウ、c:オ、d:ウ、e:エ
解説
解答の導き方
この問題では、プログラムの空欄が、ひな形の各部分を正しく記録し、置換表を使って出力する処理になるように考えます。
-
aは、クラスがインタフェースを実装する書き方ですインタフェースは、クラスが備えるべきメソッドを決めた「約束」です。問題文では、Fragmentがフラグメントを表し、そのメソッドとしてreplaceが定義されています。また、ReplacerとPassThroughはどちらもフラグメントを表すクラスです。Javaでは、クラスがインタフェースの約束を満たすことを、implementsで表します。そのため、どちらのクラス宣言も「implements Fragment」となります。選択肢ではウです。
-
bは、置換指示の前にある通常の文字列を記録しますTemplateParserでは、文字を1文字ずつ読み、bufにためています。山括弧の左側の「<」が読み込まれた時点で、bufにたまっているのは、その直前までの通常の文字列です。通常の文字列は、そのまま出力する部分です。これを表すのはPassThroughなので、bはPassThrough(buf)です。選択肢ではウです。ここでPassThroughのコンストラクタは、受け取った文字列をstrに保存します。その後にbufを新しくしても、すでに保存した文字列は残ります。
-
cは、置換指示のキー名称を記録します「<」を読み込んだ後は、bufにキー名称がためられます。そして「>」を読み込んだ時点で、bufの中身は置換指示のキー名称です。置換指示を表すクラスはReplacerです。したがって、cはReplacer(buf)となり、選択肢ではオです。例えば、ひな形にある「<名前>」では、「<」の後から「>」までの「名前」がReplacerに渡されます。
-
dは、フラグメントのリストを持つTemplateを作りますひな形の解析で作られたフラグメントは、fragmentListに順番に追加されています。Templateは、ひな形をフラグメントのリストとして保持するクラスです。そのため、fragmentListを引数にしてTemplateを生成します。dはnew Template(fragmentList)で、選択肢ではウです。なお、文字の読み込みが終わった後にもPassThroughを追加しています。これは、最後の置換指示より後ろにある通常の文字列を記録するためです。
-
eは、各フラグメントに置換表を渡しますTemplateのapplyでは、fragmentListからフラグメントを一つずつ取り出し、そのフラグメントのreplaceを呼び出しています。replaceには置換表を渡す必要があります。置換表を受け取っている引数の名前はtableです。したがって、eはtableで、選択肢ではエです。Replacerのreplaceは、キー名称に対応する文字列のリストを置換表から取り出します。文字列が複数ある場合は、String.join("\n", ...)によって、文字列の間に改行を入れてつなげます。一方、PassThroughのreplaceは、保存しておいた通常の文字列をそのまま返します。Templateはそれらを順番に連結し、出力文書を作ります。
誤りやすいポイント
- bとcを逆にしないようにします。「<」に来た時点では、bufにあるのは直前の通常の文字列です。「>」に来た時点では、bufにあるのはキー名称です。
- **aにextendsを選ばないようにします。**extendsはクラスを継承するときに使います。この問題では、クラスがFragmentというインタフェースを実装するため、implementsを使います。
- **dにbufを渡さないようにします。**bufは読み取り中の文字列をためるもので、解析結果全体をフラグメントとして保持しているのはfragmentListです。
- **eにfragmentを渡さないようにします。**fragmentはreplaceを呼び出される側です。replaceに渡すのは、置換に必要な情報を持つtableです。
FAQ
Q: 置換用文字列が複数ある場合、なぜ改行してつなぐのですか?
A: 問題文の規則で、置換用文字列が二つ以上あるときは、文字列の間に改行を挟んで連結すると定められているためです。ReplacerのString.join("\n", ...)が、その処理を行います。
Q: ひな形の最後にPassThroughを追加するのはなぜですか?
A: 最後の置換指示の後ろにも、通常の文字列が続くことがあるからです。読み込み終了時にbufの内容をPassThroughとして追加すれば、その部分も出力に含められます。
Q: PassThroughでもreplaceを呼び出すのはなぜですか?
A: Fragmentの約束に合わせて、ReplacerとPassThroughが同じ名前・引数のreplaceメソッドを持つためです。Replacerは置換を行い、PassThroughは保存した文字列を返すことで、Templateは種類ごとに処理を分けずに順番に出力できます。
関連キーワード: インタフェース、クラス、コンストラクタ、文字列連結、Map、リスト

設問2:
問題文を見る 次の記述中のに入れる正しい答えを、解答群の中から選べ。
< と >は、置換指示としてキー名称を囲う用途以外では、ひな形中で使用することができない。そこで、これらの文字を他の用途でも使用できるように、次の2行をプログラム4のクラスTemplateParserのαの位置に挿入した。これによって、\に続く1文字(\が複数個連続するときは奇数個目に続く1文字)は、置換指示以外の部分やキー名称の一部として扱われる。ここで、続く1文字は必ず読めるものとする。
case '\\':
f ;
fに関する解答群
ア:break
イ:buf.append((char) c)
ウ:buf.append((char) c); break
エ:buf.append((char) reader.read())
オ:buf.append((char) reader.read()); break
模範解答
f:オ
解説
解答の導き方
設問では、ひな形の中で「\に続く1文字」を、置換指示ではなく文字として扱うための処理を考えます。
プログラム4では、reader.read()で1文字ずつ読み、その文字をcに入れてからswitchで処理を分けています。bufは、今読んでいる文字を一時的にためておく領域です。通常の文字はdefaultの処理でbufに追加されます。
ここで「\に続く1文字」を特別扱いするには、次の2つが必要です。
-
reader.read()で、\の次の文字を読み取ってbufに追加する
cに入っているのは\自身です。そのため、次の文字を追加するには、もう一度reader.read()を呼び出します。読み取った値は数値として返されるので、文字に変換するために(char)を付けます。 -
breakで、現在の処理を終える
breakがないと、次のdefaultの処理にも進みます。すると、cに入っている\までbufに追加されてしまいます。
したがって、必要な処理は「reader.read()で次の文字をbufに追加し、その後breakで処理を終える」ものです。これに当てはまるのは、オの「buf.append((char) reader.read()); break」です。
この処理では、\の次にある文字が<や>であっても、それを区切り文字として処理せず、bufに文字として追加できます。次の文字はreader.read()で読み取られるため、後続のループで改めて判定されることもありません。
誤りやすいポイント
- cに入っているのは、\の次の文字ではなく、現在処理している\です。次の文字を使うにはreader.read()が必要です。
- 次の文字をbufに追加するだけでは不十分です。breakがないとdefaultにも進み、\もbufに追加されます。
- \をbufに追加する処理では、\の次の文字を置換指示から守れません。設問で扱うのは、\そのものではなく「\に続く1文字」です。
FAQ
Q: なぜcではなくreader.read()を使うのですか?
A: cには、switchで判定中の文字、つまり\が入っているためです。続く1文字を得るには、文字ストリームからさらに読み取る必要があります。
A: cには、switchで判定中の文字、つまり\が入っているためです。続く1文字を得るには、文字ストリームからさらに読み取る必要があります。
Q: breakを省くとどうなりますか?
A: switchの処理が次のdefaultにも続きます。その結果、\までbufに追加され、意図しない文字列になります。
A: switchの処理が次のdefaultにも続きます。その結果、\までbufに追加され、意図しない文字列になります。
Q: \が連続するときも同じ処理でよいのですか?
A: はい。1個目の\が次の\を読み取って文字として追加します。続く文字は次のループで処理されるため、設問にある奇数個目・偶数個目の扱いにつながります。
A: はい。1個目の\が次の\を読み取って文字として追加します。続く文字は次のループで処理されるため、設問にある奇数個目・偶数個目の扱いにつながります。
関連キーワード: エスケープ文字、文字ストリーム、バッファ、switch文、文字列処理

