
情報処理安全確保支援士 2016年 秋期 午後1 問02
ソフトウェア開発における脆弱性対策に関する次の記述を読んで、設問1~4に答えよ。
V社は、ディジタル機器の開発及びソフトウェアの受託開発を行う、従業員数400名の企業である。昨今、ソフトウェアの重大な脆弱性が相次いで報告されているので、V社開発部のL氏は、セキュリティ専門業者S社の情報セキュリティスペシャリストのK氏から、ソフトウェア開発についてのアドバイスを受けることとした。
〔脆弱性及びその悪用〕
ソフトウェアの脆弱性の情報を組織間で一意に特定し共有できる仕組みが運用されている。例えば、脆弱性が報告されると、a識別子が付番され、日本国内ではJPCERT/CCなどが公表し注意喚起している。ただし、公表前に悪用されるものもあり、b脆弱性と呼ばれる。b脆弱性は、特定の組織を狙う攻撃、つまりc型攻撃でしばしば悪用される。
脆弱性の中でも、バッファオーバフロー脆弱性(以下、BOF脆弱性という)は、最近開発されたソフトウェアにおいても数多く報告されている。BOF脆弱性は、主に、スタックベースBOF脆弱性とヒープベースBOF脆弱性に分類される。ソフトウェアにBOF脆弱性がある場合、当該ソフトウェアへの入力によって、①開発者が想定しないメモリ領域に書き込まれ、開発者の意図しない命令が実行されることがある。
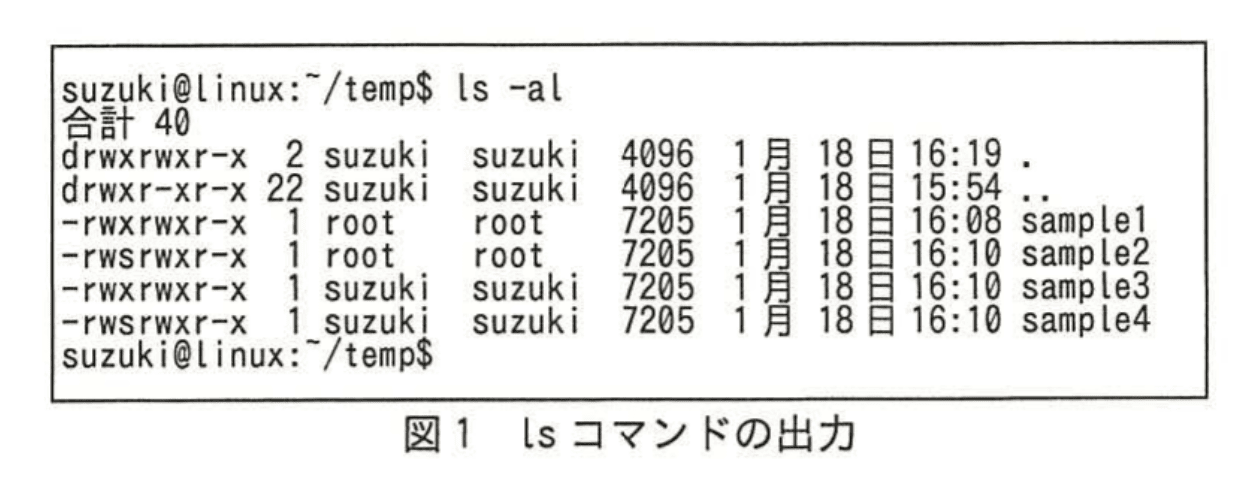
今、Linuxにおいて実行可能ファイルが四つあるとする。図1は、それらが存在するディレクトリでのlsコマンドの出力である。実行権限の属性に“s”が表示されているファイルは、ファイルの所有者権限で実行されることを示している。四つのファイルのうちアは、一般利用者suzukiによって起動された場合でもroot権限で動作する。アにBOF脆弱性があると、外部の攻撃者やマルウェアによって、開発者の意図しない命令がroot権限で実行されてしまう。
〔ヒープベースBOF脆弱性〕
K氏によると、最近、ヒープベースBOF脆弱性を悪用する攻撃の報告が増えてきているという。L氏は、出荷前のV社製品のソフトウェアについてヒープベースBOF脆弱性がないか、K氏のレビューを受けることにした。
図2のプログラムYは、起動時に、第1引数は利用者IDを、第2引数はパスワードを受け取る。このプログラム用にあらかじめ登録された“利用者IDとパスワード”の組と引数で与えられた組を比較し、利用者認証する。“利用者IDとパスワード”は、いずれも半角英数字、最小6文字最大8文字の文字列と仕様で定められている。
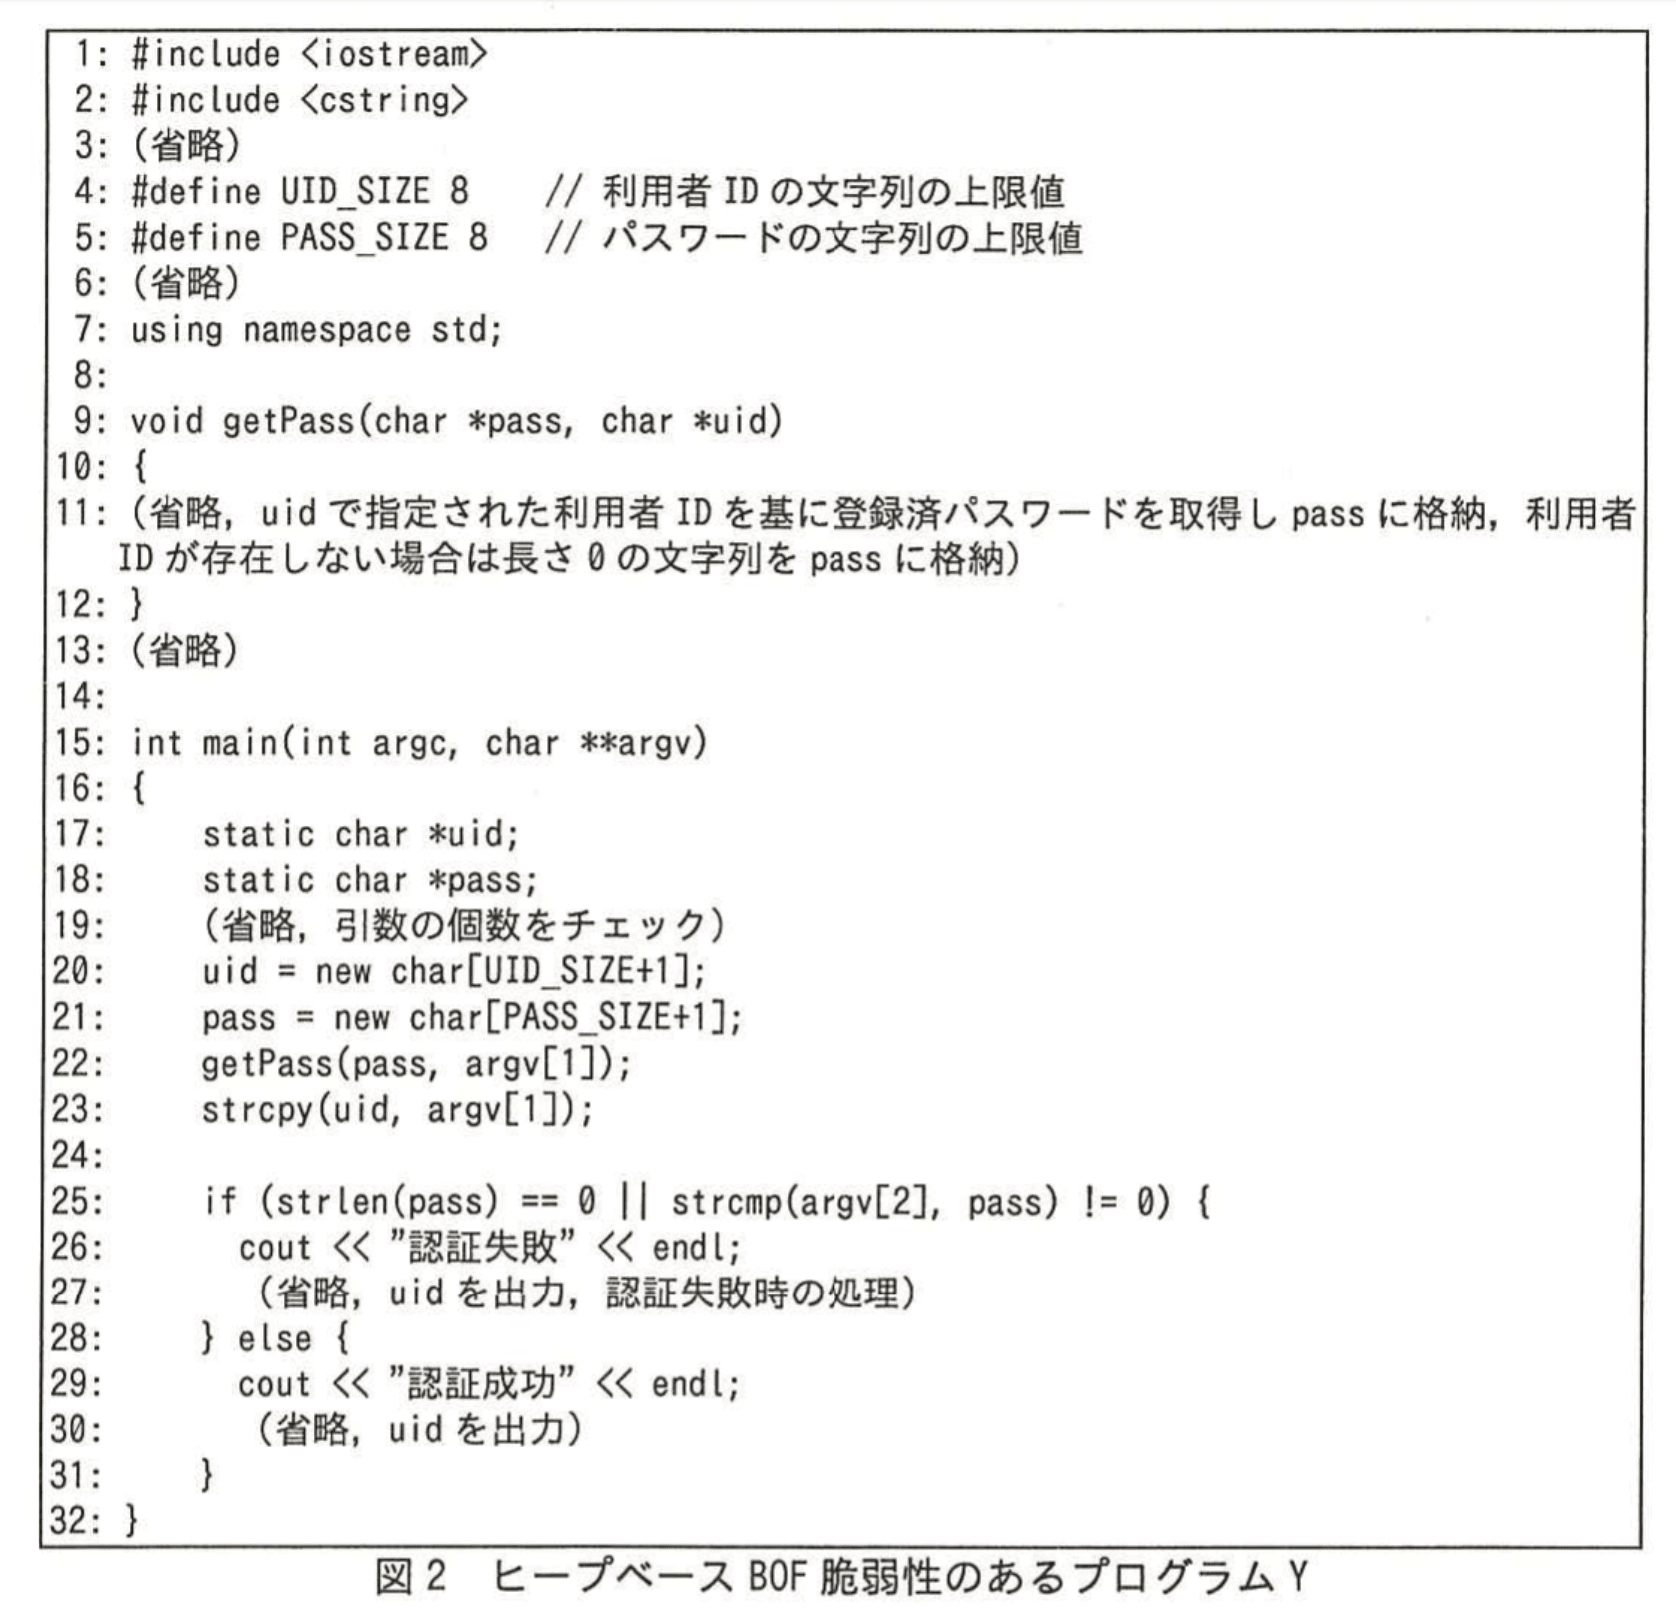
プログラムYにはヒープベースBOF脆弱性があり、②引数によっては、利用者認証を回避される可能性があると、L氏はK氏に指摘された。ただし、K氏によると、③このプログラムYは引数が同じでも、実行環境によっては利用者認証を回避されないとのことだった。L氏は、V社の開発した他のプログラムについても確認することとした。
〔V社の脆弱性対策〕
BOF脆弱性は、メモリを直接操作することが可能なプログラム言語CやC++などで発生する。その対策として、例えば、WindowsではハードウェアDEP(Data Execution Prevention)のようなデータ実行防止機能を適用することで、一部のBOF脆弱性を悪用する攻撃を抑制できる。しかし、④プログラムYでの利用者認証を回避する攻撃に対しては有効に機能しない。そこで、V社では、CやC++の利用が避けられない場合を除き、BOF脆弱性が起きにくい他のプログラム言語を利用することとした。一般的には、開発時に、静的解析ツールを利用したり、通常の利用では想定しないデータを入力し、その応答から脆弱性を探すd検査を行うツールを利用したりして、脆弱性を洗い出すことも効果的である。また、V社では、ソフトウェアのリリース後、脆弱性が発見された場合に備え、V社製品の利用者に更新プログラムを提供するサイトを準備することとした。
設問1:
問題文を見る本文中のa〜dに入れる最も適切な字句を解答群の中から選び、記号で答えよ。
解答群
ア:CVE
イ:ゼロデイ
ウ:標的
エ:ファジング
模範解答
a:ア
b:イ
c:ウ
d:エ
解説
解答の論理構成
- 【問題文】には「脆弱性が報告されると、a識別子が付番され、日本国内ではJPCERT/CCなどが公表し注意喚起している。」とあります。世界共通で脆弱性を一意に識別する仕組みは “CVE(Common Vulnerabilities and Exposures)” であり、識別子は “CVE-2023-xxxx” のように付番されます。したがってa=「ア:CVE」となります。
- 次に「ただし、公表前に悪用されるものもあり、b脆弱性と呼ばれる。」とあります。公表(パッチ公開)前に攻撃に利用される脆弱性は “ゼロデイ脆弱性” です。よってb=「イ:ゼロデイ」です。
- 続けて「b脆弱性は、特定の組織を狙う攻撃、つまりc型攻撃でしばしば悪用される。」とあるため、特定組織を狙う攻撃=“標的型攻撃” と分かります。ゆえにc=「ウ:標的」です。
- 「…静的解析ツールを利用したり、通常の利用では想定しないデータを入力し、その応答から脆弱性を探すd検査を行うツール…」とあり、想定外データを大量に与えてバグを探す手法は “ファジング(fuzzing)” です。従ってd=「エ:ファジング」となります。
よって最終解答は
a:ア b:イ c:ウ d:エ
a:ア b:イ c:ウ d:エ
誤りやすいポイント
- “CVE” を “CWE” と取り違えるケースが頻出します。CWEは脆弱性の種類分類、CVEは個別脆弱性の識別子です。
- “ゼロデイ” と “公開前” に関する記述を読み落とし、“深刻度が高い脆弱性” と誤解する受験生がいます。高リスク=ゼロデイとは限りません。
- “標的型攻撃” を「APT」と英語表記で思い出し、選択肢にないため混乱するパターンがあります。日本語の「標的」が正解。
- “ファジング” 検査を「動的解析」とだけ覚え、選択肢に同義語がないため迷うことがあります。ファジングは動的解析の一種ですが、キーワードは“ファジング”です。
FAQ
Q: “ゼロデイ脆弱性” と “未知の脆弱性” は同じ意味ですか?
A: ほぼ同義ですが、ゼロデイは「パッチが提供されていない段階で攻撃に利用される」というニュアンスが強調されます。単に未知であっても攻撃実績がなければゼロデイと呼ばれない場合があります。
A: ほぼ同義ですが、ゼロデイは「パッチが提供されていない段階で攻撃に利用される」というニュアンスが強調されます。単に未知であっても攻撃実績がなければゼロデイと呼ばれない場合があります。
Q: ファジング検査はバッファオーバフロー以外の脆弱性も見つけられますか?
A: はい。異常系入力への耐性を見るため、メモリ破損以外にも入力検証不備・例外処理漏れ・サービス拒否(DoS)など幅広い欠陥の発見に有効です。
A: はい。異常系入力への耐性を見るため、メモリ破損以外にも入力検証不備・例外処理漏れ・サービス拒否(DoS)など幅広い欠陥の発見に有効です。
Q: CVE番号を自社の脆弱性管理台帳に登録するメリットは?
A: 社外の公開情報と自動で突き合わせられるため、脆弱性情報の重複や漏れを防ぎ、パッチ適用やリスク評価を効率化できます。
A: 社外の公開情報と自動で突き合わせられるため、脆弱性情報の重複や漏れを防ぎ、パッチ適用やリスク評価を効率化できます。
関連キーワード: CVE, ゼロデイ脆弱性、標的型攻撃、ファジング、バッファオーバフロー

設問2:脆弱性を悪用する攻撃について、(1)、(2)に答えよ。
問題文を見る(1)本文中の下線①について、スタックベースBOF脆弱性を悪用する攻撃の場合、関数呼出し時にスタックに必ず積まれるはずの、何の値を書き換えることによって攻撃が開始されるか。20字以内で答えよ。
模範解答
呼出し元関数への戻りアドレス
解説
解答の論理構成
- 【問題文】では、スタックベースBOF脆弱性について「①開発者が想定しないメモリ領域に書き込まれ、開発者の意図しない命令が実行される」と説明されています。
- スタック領域には、関数呼出し時に「戻り先」を示す値が必ず積まれます。
- 攻撃者は入力データでバッファをあふれさせ、この「戻り先」を自分の用意したアドレスに書き換えます。
- 関数がret命令を実行すると、改ざんされた値を取り出してジャンプし、意図しない命令が実行される――すなわち攻撃が開始されます。
- 以上より、書き換えられる値は「呼出し元関数への戻りアドレス」です。
誤りやすいポイント
- 「ローカル変数」や「スタックポインタ」を答えてしまう。実際に制御を奪う鍵は戻りアドレスです。
- ヒープベースBOFと混同し、mallocで確保した領域のメタデータを書き換えると誤解する。設問はスタックベースBOFについて問われています。
- 「関数ポインタ」「システムコール番号」など、スタックに常に置かれるとは限らない情報を連想してしまう。
FAQ
Q: 戻りアドレス以外を改ざんしても攻撃はできませんか?
A: できます。例としてフレームポインタや例外ハンドラのポインタを書き換える手法がありますが、基本かつ代表的なのが戻りアドレスの改ざんです。
A: できます。例としてフレームポインタや例外ハンドラのポインタを書き換える手法がありますが、基本かつ代表的なのが戻りアドレスの改ざんです。
Q: 近年はスタック実行禁止機能があると聞きました。戻りアドレスを書き換える攻撃は防げますか?
A: 実行禁止は「スタック上のコード実行」を防ぐ仕組みです。戻りアドレスを書き換えて既存のコードへ飛ぶ攻撃(ROPなど)は防げないため、別の対策が必要です。
A: 実行禁止は「スタック上のコード実行」を防ぐ仕組みです。戻りアドレスを書き換えて既存のコードへ飛ぶ攻撃(ROPなど)は防げないため、別の対策が必要です。
Q: C言語を使い続ける場合、根本対策はありますか?
A: strncpyや境界チェック付きライブラリ、スタックカナリア、ASLRなどを組み合わせることでリスクを大きく下げられます。
A: strncpyや境界チェック付きライブラリ、スタックカナリア、ASLRなどを組み合わせることでリスクを大きく下げられます。
関連キーワード: バッファオーバフロー、スタック、戻りアドレス、ASLR, DEP
設問2:脆弱性を悪用する攻撃について、(1)、(2)に答えよ。
問題文を見る(2)本文中のアに入れるファイル名を全て答えよ。
模範解答
ア:sample2
解説
解答の論理構成
- 前提確認
- 問題文には「実行権限の属性に“s”が表示されているファイルは、ファイルの所有者権限で実行されることを示している。」とあります。これはUnix系OSにおける set-user-ID (setuid) の説明です。
- 判定条件
- さらに「四つのファイルのうちアは、一般利用者suzukiによって起動された場合でもroot権限で動作する。」という記載から、アに入るのは
(a) パーミッション欄に “s” がある
(b) 所有者が root
を同時に満たすファイルであると分かります。
- さらに「四つのファイルのうちアは、一般利用者suzukiによって起動された場合でもroot権限で動作する。」という記載から、アに入るのは
- 図1の読み取り
- 図1(lsコマンド結果)を確認すると、“s” を含むファイルは2つありますが、所有者が root なのは sample2 だけです。
- 結論
- 以上より、ア に入るファイル名は「sample2」となります。
誤りやすいポイント
- “s” が付いていれば無条件にrootで動作すると早合点し、所有者欄を見落とす。所有者がrootでなければsetuidで実行してもroot権限にはなりません。
- “s” がgroup権限位置に付いているsetgidと混同する。設問は「root権限で動作する」ためsetuid(ユーザ側)の有無が鍵です。
- 図1の行を数えて上から順に選ぶなど、視覚的な並び順で判断してしまう。必ず属性と所有者を両方確認する必要があります。
FAQ
Q: “s” が付いているのにroot権限にならないケースはありますか?
A: 所有者がrootでない場合や、マウントオプションnosuidが指定されている場合はroot権限になりません。設問では所有者がrootであるかが重要でした。
A: 所有者がrootでない場合や、マウントオプションnosuidが指定されている場合はroot権限になりません。設問では所有者がrootであるかが重要でした。
Q: setuidビットはセキュリティ上なぜ注意が必要ですか?
A: 脆弱性を含むsetuidプログラムを悪用されると、通常権限の攻撃者でも所有者権限(多くはroot)で任意コードを実行できるからです。BOF脆弱性と組み合わされることで権限昇格が容易になります。
A: 脆弱性を含むsetuidプログラムを悪用されると、通常権限の攻撃者でも所有者権限(多くはroot)で任意コードを実行できるからです。BOF脆弱性と組み合わされることで権限昇格が容易になります。
Q: setgidとsetuidの見分け方は?
A: 権限文字列の4文字目が小文字/大文字のs/Sならsetuid、7文字目がs/Sならsetgidです。大文字は実行ビットが立っていないことも表します。
A: 権限文字列の4文字目が小文字/大文字のs/Sならsetuid、7文字目がs/Sならsetgidです。大文字は実行ビットが立っていないことも表します。
関連キーワード: setuid, 権限昇格、ファイルパーミッション、攻撃ベクトル
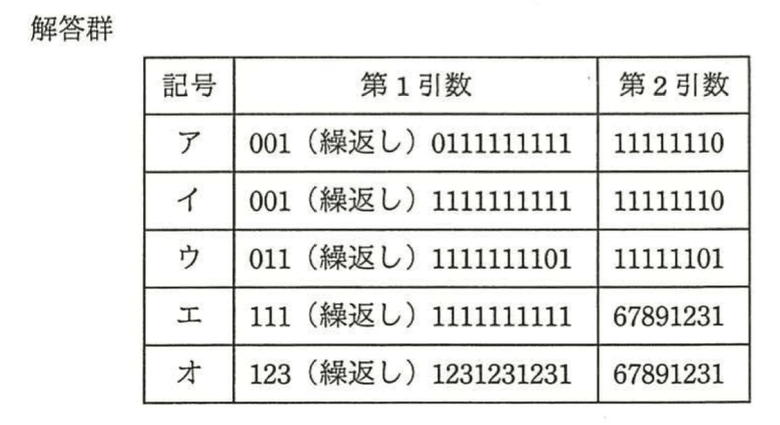
(1)本文中の下線②はどのような引数で利用者認証を回避されるか。引数の組を解答群の中から選び、記号で答えよ。
模範解答
ウ
解説
解答の論理構成
-
図2では、ユーザID用バッファを
uid = new char[UID_SIZE+1];
(ここで "UID_SIZE 8")
により9 byte、続いてパスワード用バッファを
pass = new char[PASS_SIZE+1];
(ここで "PASS_SIZE 8")
により9 byte確保しています。ヒープでは通常、先に確保した領域(uid)の直後に後の領域(pass)が並びます。 -
取得した正規パスワードをいったん
getPass(pass, argv[1]);
で pass に格納した後、次の一文が問題です。
strcpy(uid, argv[1]);
strcpyは長さチェックを行わず、第1引数(argv[1])を NUL終端まで uidに書き込みます。
• 8文字を超える入力 → uidを越えて pass 領域へ上書き → “ヒープベースBOF” 発生 -
認証判定は
strlen(pass) == 0 || strcmp(argv[2]、 pass) != 0
です。攻撃者が
① argv[1] を17 byte(uid9 byte+pass8 byte)以上にし、後半8 byteを任意値で上書き
② argv[2] にその8 byteと同じ値を入れる
と、strcmpが一致して 「認証成功」 となります。
表の候補中、この条件を満たすのは以下の組です。• 第1引数「011(繰返し)1111111101」は17文字で、先頭9文字 (uidと終端のNUL文字) を超えた後半8文字「11111101」を pass に上書き
• 第2引数「11111101」はpassが書き換えられた値と完全一致他の候補は
– 上書き文字数が8 byteに足りない
– 第2引数と後半8 byteが一致しない
などで条件を満たしません。したがって解答は 「ウ」 になります。
これが本文の下線②「引数によっては、利用者認証を回避される可能性」の具体例です。
誤りやすいポイント
- 「UID_SIZE+1」で9 byte確保しているため、NUL文字も領域に含まれる点を忘れると必要なオーバフロー長を誤算します。
- ヒープの配置は処理系依存であるため、下線③「実行環境によっては利用者認証を回避されない」を見落として「必ず成功する」と断定しがちです。
- getPassが先にpassを設定する流れを追わず、「認証時に再取得するはず」と思い込むと、上書きのタイミングを誤解します。
- DEPやASLRなどの実行制御系の防御は「コード実行阻止」には効いても、「データ改竄だけで成立する認証回避」には無力な点を混同しやすいです。
FAQ
Q: オーバフローでpassにNUL文字が入ると比較が途中で切れませんか?
A: 第1引数の後半8 byteを NULを含めずに埋めればstrcmpは全長を比較します。候補「ウ」もNULを含まない8文字です。
A: 第1引数の後半8 byteを NULを含めずに埋めればstrcmpは全長を比較します。候補「ウ」もNULを含まない8文字です。
Q: 環境依存で成功しないのはなぜですか?
A: ヒープアロケータの実装や直前のメモリ使用状況によって、uidとpassが隣接しない場合があります。そのときはuidのオーバフローがpassに届かず、改竄に失敗します。
A: ヒープアロケータの実装や直前のメモリ使用状況によって、uidとpassが隣接しない場合があります。そのときはuidのオーバフローがpassに届かず、改竄に失敗します。
Q: DEPやスタックカナリーを有効にすれば安心ですか?
A: 今回は「データを書き換えて認証を回避」するだけで、シェルコード実行は不要です。**「④プログラムYでの利用者認証を回避する攻撃に対しては有効に機能しない」**と本文が述べる通り、防げません。
A: 今回は「データを書き換えて認証を回避」するだけで、シェルコード実行は不要です。**「④プログラムYでの利用者認証を回避する攻撃に対しては有効に機能しない」**と本文が述べる通り、防げません。
関連キーワード: ヒープオーバーフロー、NUL終端、認証回避、メモリレイアウト
(2)利用者認証を回避される原因となるヒープベースBOF脆弱性の存在箇所を、実際にバッファがオーバフローするコードの行番号で答えよ。
模範解答
23
解説
解答の導き方
設問は「実際にバッファがオーバーフローするコードの行番号」を問うています。図2のコードからバッファ確保と境界チェックのないコピー処理の順序を追えば答えにたどり着けます。
-
バッファサイズと確保箇所を確認する。図2に "#define UID_SIZE 8 // 利用者IDの文字列の上限値" とあり、
"uid = new char[UID_SIZE+1];"(20行目)でuid用バッファをヒープに確保しています。passについても "pass = new char[PASS_SIZE+1];"(21行目)でヒープに確保しています。これにより該当バッファはヒープ上に存在することが分かります。 -
データの入出力の順序を見る。図2では先に "getPass(pass, argv[1]);"(22行目)が呼ばれ、ここでpassに登録済パスワードが格納されます(利用者IDが存在しない場合は長さ0の文字列を格納するという仕様も記載されています)。その直後に "strcpy(uid, argv[1]);"(23行目)が実行されます。つまり、passに値が入った後でuidへ無条件にコピーが行われます。
-
なぜ23行目でオーバーフローするかを数式で示す。argv[1] の文字数を とすると、strcpyは末尾のヌル文字を含めて バイトをコピーします。uid用に確保したバッファサイズは バイトです。したがって コピー量がバッファを超える条件は 、すなわち です。仕様上は利用者IDは最大8文字と定められていますが、プログラム側で長さチェックをしていないため、長い引数を与えればオーバーフローが発生します。
-
なぜ認証回避につながるか。オーバーフローはuidバッファの直後のヒープ領域を上書きします。図2の確保順(uidを先に確保し、その後passを確保)や一般的なヒープ配置のされ方から、オーバーフローによりpassに確保した領域の内容が書き換えられる可能性があります。getPassは先にpassに正しいパスワードを格納しているため、strcpyによる上書きでpassの内容が攻撃者の任意の値(例えばargv[2] と同じ値)に書き換わると、条件式 "if (strlen(pass) == 0 || strcmp(argv[2]、 pass) != 0) {" のstrcmpが0(等しい)を返し、認証判定をすり抜けて "認証成功"(28行目)の分岐に入ることがあり得ます。以上より、実際にバッファがオーバーフローするコードの行は23行目の "strcpy(uid, argv[1]);" です。
誤りやすいポイント
- passポインタ(変数本体)がオーバーフローで上書きされると考える誤り。passは "static char *pass;"(18行目)として宣言されており、ポインタ変数本体は静的領域(データ領域)に置かれます。オーバーフローで上書きされるのはヒープ上の領域(passが指すバッファの内容やヒープメタデータ)であり、ポインタ変数そのものとは限りません。
- スタックベースのBOFと同じ振る舞いを想定する誤り。ここではnewによるヒープ確保なのでヒープ上の隣接領域やメタデータが影響を受けます。
- UID_SIZE = 8だから「8文字でオーバーフローする」と誤って覚える。実際はヌル文字分を含めて バイト確保なので、オーバーフローは (9文字以上)のときに発生します。
- DEP(NX)などのデータ実行防止機能でこの攻撃が防げると考える誤り。今回の攻撃はデータの改変(認証情報の上書き)を狙うもので、必ずしも実行可能領域へのコード注入/実行を伴わないため、DEPは有効とは限りません(問題文でも同様の指摘があります)。
FAQ
Q: なぜ「ヒープベース」なのですか?
A: 図2では "uid = new char[UID_SIZE+1];" と "pass = new char[PASS_SIZE+1];"(20〜21行目)で動的確保しており、newによる領域はヒープ上に配置されます。よってコピー時のオーバーフローはヒープ領域の破壊(ヒープベースBOF)になります。
A: 図2では "uid = new char[UID_SIZE+1];" と "pass = new char[PASS_SIZE+1];"(20〜21行目)で動的確保しており、newによる領域はヒープ上に配置されます。よってコピー時のオーバーフローはヒープ領域の破壊(ヒープベースBOF)になります。
Q: strcpyの代わりにstrncpyを使えば安全ですか?
A: strncpyはヌル終端を保証しない副作用があるため注意が必要です。安全策としては「入力長を検査してからコピーする」「std::stringを使う」「バッファ長を明示的に使って安全にコピーする(例: memcpyと長さチェック)」といった方法が堅実です。
A: strncpyはヌル終端を保証しない副作用があるため注意が必要です。安全策としては「入力長を検査してからコピーする」「std::stringを使う」「バッファ長を明示的に使って安全にコピーする(例: memcpyと長さチェック)」といった方法が堅実です。
Q: 同じ引数で実行しても、なぜ実行環境によって挙動が変わるのですか?
A: ヒープの配置はランタイムのメモリアロケータ実装、ヒープの断片化状況、ASLRやmallocのセキュリティ対策、ライブラリのバージョンなどで変わります。ある環境ではuidの直後にpassのバッファが来て上書きされるが、別環境ではパディングや別領域が入って上書きされずクラッシュする場合もあります。これが「実行環境依存」の理由です。
A: ヒープの配置はランタイムのメモリアロケータ実装、ヒープの断片化状況、ASLRやmallocのセキュリティ対策、ライブラリのバージョンなどで変わります。ある環境ではuidの直後にpassのバッファが来て上書きされるが、別環境ではパディングや別領域が入って上書きされずクラッシュする場合もあります。これが「実行環境依存」の理由です。
関連キーワード: ヒープベースBOF、strcpy、入力長検証、ヒープメタデータ、ASLR
(3)(2)で示した行番号の行を差し替えて行う改修案として適切なものを解答群の中から全て選び、記号で答えよ。
解答群
ア:memcpy(uid, argv[1], strlen(argv[1])+1);
イ:memcpy(uid, argv[1], UID_SIZE+1);
ウ:pass=new char[PASS_SIZE+8];
エ:strncpy(uid, argv[1], strlen(argv[1])+1);
オ:strncpy(uid, argv[1], UID_SIZE+1);
模範解答
イ、オ
解説
解答の導き方
設問の要点は、図2のコードで「どの置換案がstrcpyによるヒープベースのバッファオーバフロー(BOF)を防ぎ、利用者認証の回避を抑止するか」を判断することです。問題文に「利用者IDとパスワードは、いずれも半角英数字、最小6文字最大8文字の文字列と仕様で定められている」とありますが、実際の引数は外部から任意に与えられるため長い文字列が渡され得ます。また「プログラムYにはヒープベースBOF脆弱性があり、②引数によっては、利用者認証を回避される可能性がある」と明記されており、境界チェックの欠如が原因であると判断できます。
まず図2の該当箇所を確認します。重要な行は次のとおりです。
「uid = new char[UID_SIZE+1];」
「pass = new char[PASS_SIZE+1];」
「getPass(pass, argv[1]);」
「strcpy(uid, argv[1]);」
さらに認証判定は次の条件で行われます。
「if (strlen(pass) == 0 || strcmp(argv[2]、 pass) != 0) {」
「uid = new char[UID_SIZE+1];」
「pass = new char[PASS_SIZE+1];」
「getPass(pass, argv[1]);」
「strcpy(uid, argv[1]);」
さらに認証判定は次の条件で行われます。
「if (strlen(pass) == 0 || strcmp(argv[2]、 pass) != 0) {」
これらから段階的に考えます。
-
なぜ脆弱性が起きるか
- uidとpassをそれぞれヒープ上に確保しており、コードは先にuidをnewし、その後にpassをnewしています。つまりヒープ上でuidの領域が先に割り当てられ、その直後にpassが割り当てられる可能性が高く、長いargv[1] を「strcpy(uid, argv[1]);」で書き込むとuidの境界を越えて後続のヒープ領域(例えばpass)を上書きすることがあり得ます(ヒープベースBOF)。
- getPass(pass, argv[1]) が先に呼ばれてpassに登録パスワードを格納しているため、strcpyによる上書きでpassの内容を攻撃者が書き換えれば、strcmpの比較を整合させて認証を通す(利用者認証の回避)ことが可能です。
-
実行環境依存性の理由
- 問題文にあるように「引数が同じでも、実行環境によっては利用者認証を回避されない」ことがあるのは、ヒープの割り当て順序やアロケータ、ASLR等によりuidとpassの物理的配置が変わり、オーバーフローがpassに到達するかどうかが変わるためです。
-
選択肢の評価(各置換案を順に検討)
- ア:memcpy(uid、argv[1]、strlen(argv[1])+1);
- コピー長をstrlen(argv[1])+1にしているため、argv[1] の長さがUID_SIZEを超えるとuidの確保領域を越えて書き込む(書き込み側でオーバーフローする)。したがってオーバーフロー対策にならないため不適切です。
- イ:memcpy(uid、argv[1]、UID_SIZE+1);
- 書き込み長をUID_SIZE+1(uidの確保サイズ)に固定しているため、書き込みが確保領域を超えてpassを上書きすることは防げます。ただしmemcpyは指定したバイト数だけ「読み出す」ので、argv[1] が短い場合にソース側(argv[1])のヌル終端を越えて読み出すことになり、未定義動作(読み出し側の越境)を招く点に注意が必要です。とはいえ与えられた選択肢の中では書き込み長を固定してオーバーフローを防ぐという観点で許容されます。
- ウ:pass=new char[PASS_SIZE+8];
- passの確保サイズを増やすだけではstrcpyがuidの境界を越える根本原因を解決しません。ヒープ上の配置や他のデータを破壊する可能性は残るため根本対策ではなく不適切です。
- エ:strncpy(uid、argv[1]、strlen(argv[1])+1);
- コピー長をstrlen(argv[1])+1にしており、argv[1] が長い場合は書き込み側がオーバーフローするため不適切です。
- オ:strncpy(uid、argv[1]、UID_SIZE+1);
- コピー長をUID_SIZE+1に制限するため、書き込みが確保領域を越えることは防げます。strncpyはソースが短ければ残りをヌルで埋めるのでargv[1] が短い場合は安全にヌル終端されます。ソースがUID_SIZE+1以上の長さの場合はヌル終端が保証されない点に注意が必要ですが、書き込み長の観点ではオーバーフローを防ぐため許容されます。
- ア:memcpy(uid、argv[1]、strlen(argv[1])+1);
以上の比較から、書き込み量を確保領域以内に抑える選択肢が正解であり、選ぶべき候補はイとオになります。ただし注意点として、イ(memcpyで固定長コピー)は「読み出し側の越境による未定義動作」がある点、オ(strncpy)も「ソースが長い場合にヌル終端が保証されない」点があるため、実際の修正ではこれらの副作用を解消する追加措置(コピー長をmin(strlen(src)+1, dest_size) にする、またはstrncpyの後に明示的に終端をセットする、あるいはsafer APIを使う)を行うべきです。
(例:安全な実装方針の一例)
uidの確保サイズがUID_SIZE+1の場合、実運用では次のようにするのが望ましいです。
size_t n = strlen(argv[1]);
size_t copy = (n < UID_SIZE) ? n : UID_SIZE;
memcpy(uid, argv[1], copy);
uid[copy] = '\0';
あるいはstrlcpy/snprintfを利用する(環境により利用可否があるため注意)。
uidの確保サイズがUID_SIZE+1の場合、実運用では次のようにするのが望ましいです。
size_t n = strlen(argv[1]);
size_t copy = (n < UID_SIZE) ? n : UID_SIZE;
memcpy(uid, argv[1], copy);
uid[copy] = '\0';
あるいはstrlcpy/snprintfを利用する(環境により利用可否があるため注意)。
誤りやすいポイント
- memcpy(uid、argv[1]、UID_SIZE+1) を「完全に安全」と誤解する。memcpyは読み出し長を指定した通りに読むため、argv[1] が短いとソース側の越境(未定義動作)を招く可能性がある。
- strncpy(uid、argv[1]、UID_SIZE+1) が常にヌル終端を保証すると誤解する。ソース長が指定長以上ならヌル終端はされないので、必ず末尾を明示的に '\0' にする等の措置が必要。
- バッファを単に大きくする(ウ)ことで問題解決したと考える。根本的な境界チェックをしない限り他の領域破壊や未定義動作のリスクは残る。
- ヒープ領域の配置に依存して「ある環境では動かない=脆弱性ではない」と誤認する。攻撃者は適切な環境や工夫で利用可能にすることがあるため、条件に依存する脆弱性でも修正が必要。
FAQ
Q1: strncpyとmemcpy、どちらが安全ですか?
A1: 用途によります。安全に文字列をコピーしたいなら「コピー長をdest_size-1にして最後に '\0' を書く」か、環境で提供される安全な関数(strlcpy, snprintfなど)を使うのがよいです。memcpyはバイト単位で指定長を必ず読み書きするため、ソースのヌル終端を前提にしない処理には向きません。
A1: 用途によります。安全に文字列をコピーしたいなら「コピー長をdest_size-1にして最後に '\0' を書く」か、環境で提供される安全な関数(strlcpy, snprintfなど)を使うのがよいです。memcpyはバイト単位で指定長を必ず読み書きするため、ソースのヌル終端を前提にしない処理には向きません。
Q2: なぜpassのサイズを増やす(ウ)は不十分なのですか?
A2: サイズを増やして一時的に隣接領域への上書きを避けられるかもしれませんが、strcpyが境界を越える根本原因は解決されていません。他のヒープ領域や管理構造を破壊するリスクが残り、安全な解決策とは言えません。
A2: サイズを増やして一時的に隣接領域への上書きを避けられるかもしれませんが、strcpyが境界を越える根本原因は解決されていません。他のヒープ領域や管理構造を破壊するリスクが残り、安全な解決策とは言えません。
Q3: 「実行環境によっては回避されない」とあるのはどういうことですか?
A3: ヒープ上の配置はアロケータやASLRによって変化するため、uidとpassが連続して配置される場合にのみoverflowがpassを上書きします。別の環境では配置が異なり上書きが発生しないため、攻撃成功の可否が環境依存になります。しかし環境依存でも脆弱性は放置すべきではありません。
A3: ヒープ上の配置はアロケータやASLRによって変化するため、uidとpassが連続して配置される場合にのみoverflowがpassを上書きします。別の環境では配置が異なり上書きが発生しないため、攻撃成功の可否が環境依存になります。しかし環境依存でも脆弱性は放置すべきではありません。
関連キーワード: ヒープベースバッファオーバーフロー、境界チェック、ヌル終端、strncpy/memcpy、ASLR
設問4:利用者認証の回避について、(1)、(2)に答えよ。
問題文を見る(1)本文中の下線③について、利用者認証が回避されない理由を、攻撃のタイミングではなく実行環境の観点で、40字以内で述べよ。
模範解答
ヒープメモリの確保方法が、メモリ確保のライブラリによって違うから
解説
解答の論理構成
- 【問題文】では、下線部③として「このプログラムYは引数が同じでも、実行環境によっては利用者認証を回避されない」と述べています。
- ヒープベースBOFでは、攻撃者は「先に確保したバッファをあふれさせて、後から確保した重要変数を書き換える」ことを狙います。
- ところがヒープ領域は、動的メモリ確保ライブラリ(malloc/newなど)の実装やOSのバージョンによって「確保単位」「チャンクの並び順」「番兵領域の有無」が変わります。
- そのため、同じ順序でnewを呼び出しても
・ある環境では「uidバッファ」の直後に「passバッファ」が並び、あふれた文字列がpassを上書きし認証回避が成立
・別の環境では2つのバッファの間に隙間やガード領域が入り、上書きが届かず回避が失敗
という差が生じます。 - よって、下線③の理由は「ヒープメモリの確保方法が、メモリ確保のライブラリによって違うから」となります。
誤りやすいポイント
- 「攻撃タイミングの違い」と誤解し、ヒープ配置の非決定性を見落とす。
- DEPやASLRと混同し、「OS保護機構が有効だから回避できない」と答えてしまう。
- スタックBOFと同じ感覚で「関数の戻り番地が書き換えられるか否か」が決め手だと勘違いする。
- 文字列長チェック不足ばかりに注目し、ヒープ上の物理的な配置が環境依存である事実をスルーする。
FAQ
Q: どのライブラリなら安全なのですか?
A: 多くの最新ライブラリは「番兵領域」や「ヒープカナリア」で破壊検知を行いますが、完全ではありません。設計段階で安全なAPIを使うことが根本対策です。
A: 多くの最新ライブラリは「番兵領域」や「ヒープカナリア」で破壊検知を行いますが、完全ではありません。設計段階で安全なAPIを使うことが根本対策です。
Q: DEPが効かないのはなぜ?
A: 今回の攻撃は「コード実行」ではなく「データ改竄」で条件分岐をすり抜けるタイプです。データ実行防止は無関係のため効果がありません。
A: 今回の攻撃は「コード実行」ではなく「データ改竄」で条件分岐をすり抜けるタイプです。データ実行防止は無関係のため効果がありません。
Q: strncpyに置き換えれば十分?
A: 長さ制限付きコピーに替えることで今回のオーバーフローは防げますが、入力検証・バッファサイズ管理など包括的な対策が必要です。
A: 長さ制限付きコピーに替えることで今回のオーバーフローは防げますが、入力検証・バッファサイズ管理など包括的な対策が必要です。
関連キーワード: ヒープオーバーフロー、動的メモリ確保、メモリアロケータ、バッファ上書き、認証バイパス
設問4:利用者認証の回避について、(1)、(2)に答えよ。
問題文を見る(2)本文中の下線④について、有効に機能しない理由を、30字以内で述べよ。
模範解答
ヒープ領域を書き換える行為を防止できないから
解説
解答の論理構成
- 本文には「WindowsではハードウェアDEP(Data Execution Prevention)のようなデータ実行防止機能を適用することで、一部のBOF脆弱性を悪用する攻撃を抑制できる。しかし、④プログラムYでの利用者認証を回避する攻撃に対しては有効に機能しない」と明記されています。
- DEPが防げるのは「メモリ上のデータ領域を実行不可にする」タイプの攻撃、すなわち“注入したシェルコードを実行させる”ケースです。
- ところがプログラムYの攻撃は、図2のuid = new char[UID_SIZE+1];で確保したヒープ領域にstrcpy(uid, argv[1]);で境界を超えて書き込み、uidやpassなどの変数内容を改変しstrcmpの結果を偽装する“認証バイパス”であり、悪用の核心は「ヒープ領域の書き換え」です。
- DEPは「実行」を防ぎますが「書き換え」そのものは防げません。従って本文④が示す通り、利用者認証を回避するヒープベースBOF攻撃には効果がありません。
- 以上より、「ヒープ領域を書き換える行為を防止できないから」という解答が導かれます。
誤りやすいポイント
- 「DEP=BOF全般に有効」と思い込み、データ改ざん型の攻撃にも効くと勘違いする。
- ヒープとスタックを混同し、スタック上でのコード実行阻止を理由にしてしまう。
- ④の文脈を読まず、「OS設定が無効」など方向違いの説明を書く。
FAQ
Q: なぜヒープベースBOFではコードを実行しなくても認証を回避できるのですか?
A: 変数配置が近接しているため、長い入力で隣接ポインタやフラグを書き換え、認証結果を操作できるからです。
A: 変数配置が近接しているため、長い入力で隣接ポインタやフラグを書き換え、認証結果を操作できるからです。
Q: DEP以外に有効な防御策はありますか?
A: 境界チェックの徹底、strncpy等の安全API使用、ASLRやヒープカナリア、そして静的解析・d検査(ファジング)などが挙げられます。
A: 境界チェックの徹底、strncpy等の安全API使用、ASLRやヒープカナリア、そして静的解析・d検査(ファジング)などが挙げられます。
Q: スタックカナリアは今回の脆弱性に有効ですか?
A: スタック領域専用の保護機構なので、ヒープ領域を対象とした今回の攻撃には直接効果を期待できません。
A: スタック領域専用の保護機構なので、ヒープ領域を対象とした今回の攻撃には直接効果を期待できません。
関連キーワード: ヒープオーバフロー、Data Execution Prevention, 認証バイパス、メモリ保護、境界値チェック

