
応用情報技術者 2013年 秋期 午後 問02
リストによるメモリ管理に関する次の記述を読んで、設問1~3に答えよ。
与えられたメモリ空間(以下、ヒープ領域という)の中に、可変長のメモリブロックを動的に割り当てるためのデータ構造及びアルゴリズムを考える。
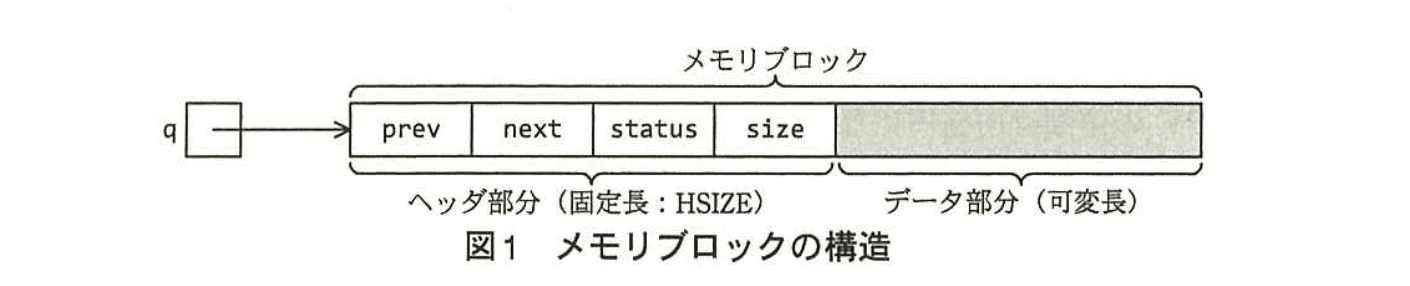
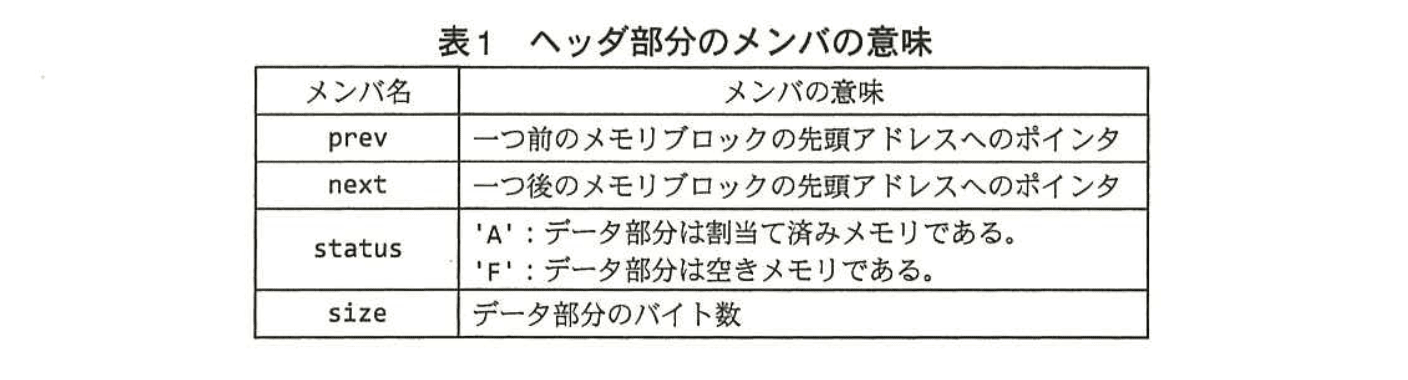
ヒープ領域は、一つ以上の連続したメモリブロックで構成する。メモリブロックは、固定長のヘッダ部分と可変長のデータ部分で構成される。ヘッダ部分は構造体で、prev, next, status及びsizeのメンバによって構成される。メモリブロックの構造を図1に、ヘッダ部分のメンバの意味を表1にそれぞれ示す。メモリブロックを指すポインタ変数には、メモリブロックの先頭アドレスをセットする。あるメモリブロックを指すポインタ変数をqとするとき、そのメンバprevの参照は、q->prevと表記する。また、ヘッダ部分のバイト数は、HSIZEとする。
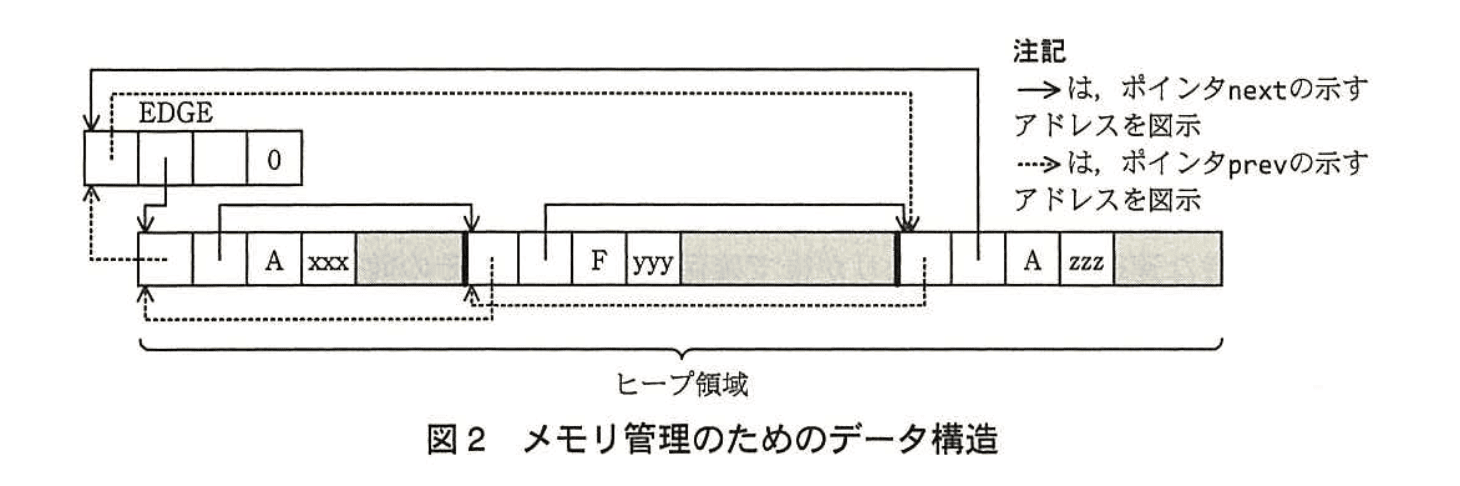
ヘッダ部分と同じ構造体の変数EDGEをヒープ領域の外に定義する。そのメンバprev及びnextには、それぞれヒープ領域の最後尾及び先頭のメモリブロックの先頭アドレスをセットする。ヒープ領域の先頭のメモリブロックのメンバprevと最後尾のメモリブロックのメンバnextには、ともにEDGEの先頭アドレスをセットする。これによって、EDGEを含むメモリブロックが双方向の循環リストを構成する。EDGEにはデータ部分はなく、メンバsizeには0が設定されている。データ構造の全体像を図2に示す。
〔メモリ割当ての関数〕
メモリ割当ての関数は、割り当てたいバイト数(msize)を引数とし、そのバイト数以上の大きさのデータ部分をもつメモリブロックを、ヒープ領域から探索する。このアルゴリズムを次のように考えた。
(1) ポインタ変数qを定義し、初期値として変数EDGEのnextの値をセットする。
(2) qがアと等しい場合は、ヒープ領域には十分な空きメモリをもったメモリブロックが無かったことを意味する。関数の戻り値にNULLをセットして終了する。それ以外の場合は、次の(3)~(5)を実行する。
(3) q->イが'A'の場合、又はq->sizeがmsize未満である場合は、qにq->ウをセットして(2)に戻る。
(4) q->sizeがHSIZE+msize以下の場合は、q->イに'A'をセットし、関数の戻り値にqの値をセットして終了する。
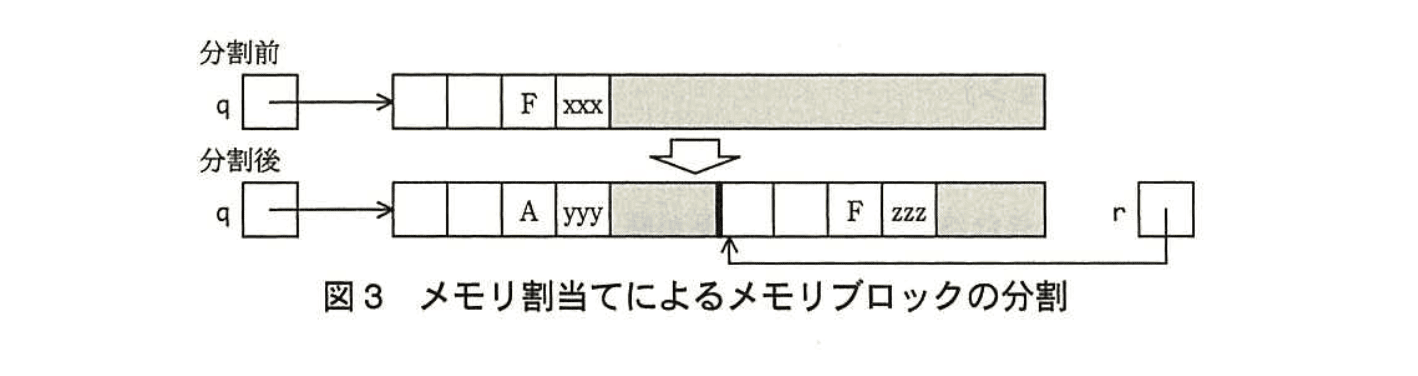
(5) q->sizeがHSIZE+msizeよりも大きい場合は、そのメモリブロックを割当て済みのメモリブロックと、残りの空きメモリブロックの二つに分割する(図3参照)。ポインタ変数rを定義し、初期値としてq+HSIZE+msizeをセットする。q->イに'A'をセットし、r->イに'F'をセットする。r->sizeにq->size-HSIZE-msizeをセットし、q->sizeにmsizeをセットする。r->prevにはエを、r->nextにはオを、q->next->prevにはrを、q->nextにはrを順にセットする。関数の戻り値にqの値をセットして終了する。
〔メモリ解放の関数〕
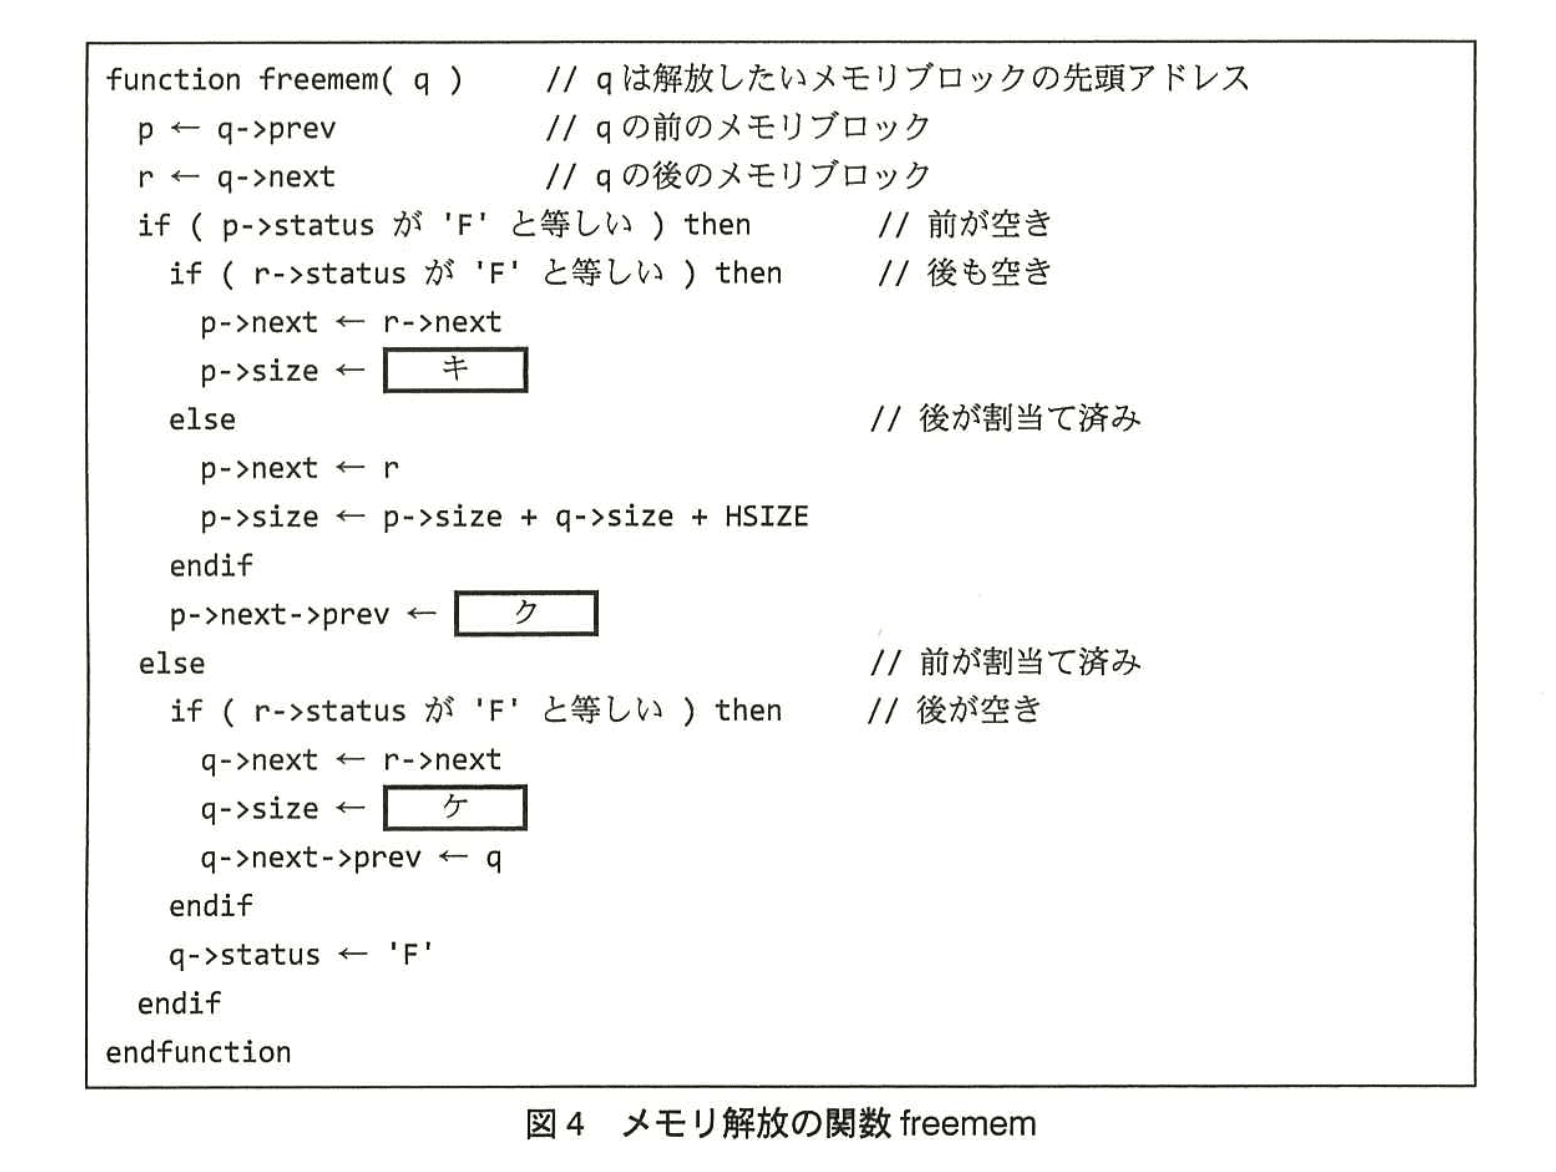
メモリ解放の関数freememは、解放したいメモリブロックの先頭アドレスを引数とし、そのメモリブロックを空きメモリブロックの状態に変更する。このとき、できるだけ大きな連続した空きメモリが後で確保できるよう、その前後のメモリブロックも空きメモリブロックかどうかを確認する。空きメモリブロックが連続する場合には、それらをまとめて一つの空きメモリブロックにする。
関数freememのプログラムを図4に示す。この関数を正しく動作させるためには、変数EDGEのメンバstatusの値はカである必要がある。
 ↩設問2(2)
〔メモリコンパクション〕
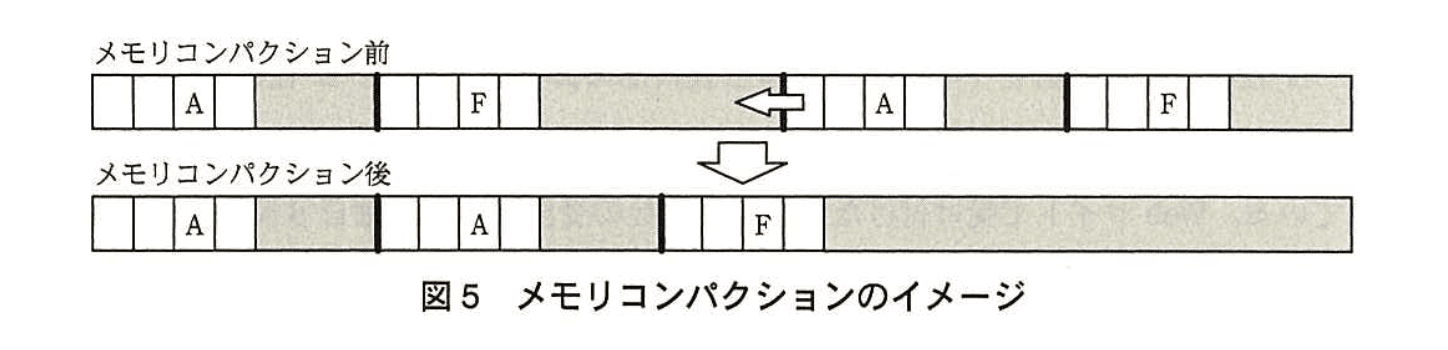
メモリの確保や解放の処理を繰り返すと、サイズの小さな空きメモリが分散してしまい、サイズの大きな空きメモリの確保が難しくなることがある。このような現象をコと呼ぶ。このとき、割当て済みのメモリブロックが連続するようにメモリブロックを移動し、移動したメモリブロックの後ろに大きな空きメモリを確保することをメモリコンパクションという(図5参照)。
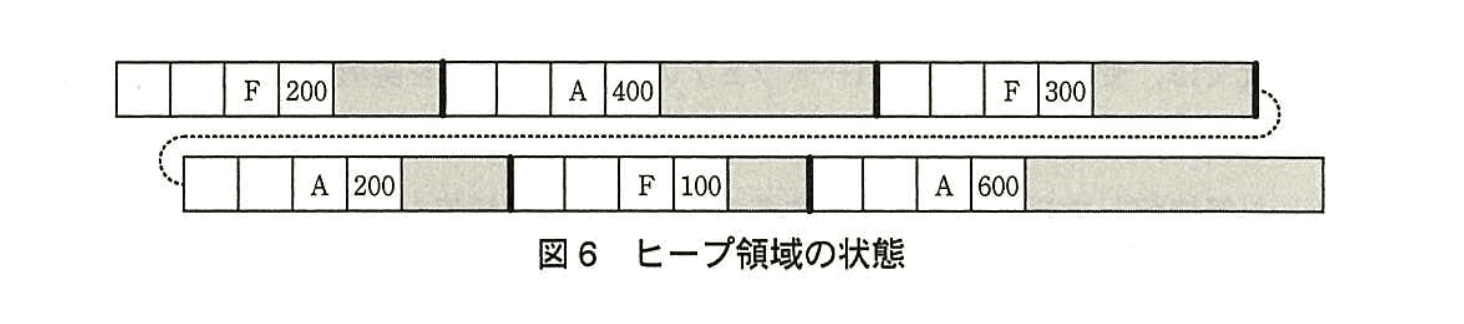
ヒープ領域が図6のように左上から右下にかけて連続する構成の場合、メモリコンパクションを実行すると、サバイトの空きメモリができる。
メモリコンパクションを実行すると、①メモリコンパクション前に実行したメモリ割当て関数の戻り値は、メモリ解放の関数の引数としては使えなくなる場合がある。
設問1:〔メモリ割当ての関数〕について、(1)、(2)に答えよ。
問題文を見る(1)本文中のア〜ウに入れる適切な字句を答えよ。
模範解答
ア:EDGEの先頭アドレス
イ:status
ウ:next
解説
解答の論理構成
-
循環リストの基準点
問題文には「EDGEを含むメモリブロックが双方向の循環リストを構成する。」とあり、さらに探索手順(1)で「変数EDGEのnextの値をセットする」と示されています。探索が一巡して元に戻ったことを検知するためには、qをセンチネルである「EDGEの先頭アドレス」と比較するしかありません。したがって
- ア=EDGEの先頭アドレス -
空き/使用中判定に使うメンバ
手順(3)では「q->イが'A'の場合、又は…」と記述されています。表1にはメンバstatusの意味として「'A':データ部分は割当て済みメモリである。'F':データ部分は空きメモリである。」と明記されており、'A' を保持するフィールドはstatusです。したがって
- イ=status -
次のブロックへの移動
探索継続は「qにq->ウをセットして(2)に戻る」と説明されています。双方向リストで前へ進むときはnextポインタを参照しますから
- ウ=next
以上より、模範解答は
ア:EDGEの先頭アドレス イ:status ウ:nextとなります。
ア:EDGEの先頭アドレス イ:status ウ:nextとなります。
誤りやすいポイント
- prevとnextの混同
循環リストで戻る方向も存在するため、先頭から順に走査する場合はnextが正解です。 - センチネルにNULLを想定
本問題では「EDGEによって…双方向の循環リストを構成する」とあるため、終端はNULLではなく「EDGEの先頭アドレス」です。 - 'A'/'F' を格納するフィールド名の誤記
表1に明示されているように 'A' と 'F' を保持するのはstatusであってsizeでもprevでもありません。
FAQ
Q: なぜ循環リスト(センチネル)を使うのですか?
A: 先頭や末尾のブロックでも同じロジックで走査・挿入・削除が行え、リストの終端判定が「EDGEに戻ったかどうか」だけで済むため、分枝が減り実装が簡潔になります。
A: 先頭や末尾のブロックでも同じロジックで走査・挿入・削除が行え、リストの終端判定が「EDGEに戻ったかどうか」だけで済むため、分枝が減り実装が簡潔になります。
Q: statusが 'A' であってもサイズが足りないブロックは飛ばすのですか?
A: はい。手順(3)で「q->statusが 'A' またはq->size < msizeの場合に次へ進む」と二重条件で判定しています。空きブロックでもサイズ不足なら候補になりません。
A: はい。手順(3)で「q->statusが 'A' またはq->size < msizeの場合に次へ進む」と二重条件で判定しています。空きブロックでもサイズ不足なら候補になりません。
Q: prevだけで前方向の走査はできますか?
A: 技術的には可能ですが、前方向(アドレスの増加方向)に進むにはnextが自然です。本問題のアルゴリズムもnextを使用しており、prevは主に逆方向処理や統合時に利用します。
A: 技術的には可能ですが、前方向(アドレスの増加方向)に進むにはnextが自然です。本問題のアルゴリズムもnextを使用しており、prevは主に逆方向処理や統合時に利用します。
関連キーワード: 循環リスト、センチネルノード、動的メモリ割当て、ダブルリンクリスト

設問1:〔メモリ割当ての関数〕について、(1)、(2)に答えよ。
問題文を見る(2)本文中のエ、オに入れる適切な字句を、ポインタ変数qを用いて答えよ。
模範解答
エ:q
オ:q->next
解説
解答の論理構成
-
分割の場面
本文(5)には「そのメモリブロックを割当て済みのメモリブロックと、残りの空きメモリブロックの二つに分割する」とあります。分割前にポインタ変数 q が指すブロックと q->next が指す後続ブロックが双方向リストで連結されています。 -
新ブロック r の位置関係
生成する r は「q+HSIZE+msize」を先頭アドレスとするので、物理的には q の直後、q->next の直前に挿入されます。したがって
• r の直前ブロック → q
• r の直後ブロック → q->next -
ヘッダの整合性
本文の指示は次の通りです。
「r->prevにはエを、r->nextにはオを、q->next->prevにはrを、q->nextにはrを順にセットする。」
双方向循環リストの整合性を保つには
• r->prevが q を指すことで、後方リンクが確立
• r->nextが q->next を指すことで、前方リンクが確立
• その後q->next->prevとq->nextを更新し、リストが切れ目なくつながる -
以上より
エ= q
オ= q->next
誤りやすいポイント
- r->nextに q を設定してしまう
→ これでは自分の後ろが自分になるループが発生します。 - q->nextの更新順序を誤る
→ 先にq->nextを書き換えると、元の後続ブロックのポインタが失われ復旧不能になります。 - prevとnextの役割混同
→ 物理メモリ順とリンクリスト順が一致していると錯覚しやすいので要注意です。
FAQ
Q: 分割後にq->sizeを変更するのはなぜですか?
A: 本文(5)にある通り「q->sizeにmsizeをセットする」ことで、q が要求サイズだけを保持し、余った領域を新ブロック r に譲るためです。
A: 本文(5)にある通り「q->sizeにmsizeをセットする」ことで、q が要求サイズだけを保持し、余った領域を新ブロック r に譲るためです。
Q: 循環リストである利点は何ですか?
A: 先頭・末尾判定が不要になり、EDGEから一周すれば全ブロックを走査できます。
A: 先頭・末尾判定が不要になり、EDGEから一周すれば全ブロックを走査できます。
Q: EDGEのsizeが必ず0である理由は?
A: データ部分を持たない番兵ノードなので、誤ってユーザに割り当てられないように固定値 0 にしています。
A: データ部分を持たない番兵ノードなので、誤ってユーザに割り当てられないように固定値 0 にしています。
関連キーワード: 双方向循環リスト、ヒープ領域、メモリブロック、ポインタ操作、分割アルゴリズム
設問2:〔メモリ解放の関数〕について、(1)、(2)に答えよ。
問題文を見る(1)本文中のカに入れる適切な字句を答えよ。
模範解答
カ:'A'
解説
解答の論理構成
-
図2の説明より
「ヒープ領域の先頭のメモリブロックのメンバprevと最後尾のメモリブロックのメンバnextには、ともにEDGEの先頭アドレスをセットする。これによって、EDGEを含むメモリブロックが双方向の循環リストを構成する。」
つまりEDGEはヒープ外にあるダミーノードであり、リストの番兵(sentinel)として機能します。 -
図4のfreememでは、解放対象qの前後ブロックの状態を
if (p->status が 'F' と等しい)
if (r->status が 'F' と等しい)
で判定し、空き ('F') なら連結・サイズ加算を行います。 -
解放対象がヒープの先頭ブロックの場合、pはEDGEを指します。
もしEDGE->statusが 'F' なら、freememはEDGEを通常の空きブロックとみなし、p->next ← r->next p->size ← ... p->next->prev ← pの処理でEDGEをヒープ内ブロックと誤認してしまいます。
これはダミーノードを破壊し、リストが壊れる原因になります。 -
一方EDGE->statusを 'A' にしておけば、上記のif文は成立せず、else // 前が割当て済み ... q->status ← 'F'が選択され、EDGEは併合対象になりません。
従って「この関数を正しく動作させるためには、変数EDGEのメンバstatusの値はカである必要がある。」の カ には 'A' が入ります。
誤りやすいポイント
- EDGEもヒープ領域と誤解し、'F' を入れてしまう
→ 先頭ブロック解放時に番兵が結合され、循環リストが崩壊します。 - 「ダミーノードにデータ部がない=空き」と短絡的に判断してしまう
→ ヘッダの役割(リストの境界識別)を見落とす典型例です。 - freememのif‐elseネストを追い切れず、番兵の扱いを確認せずに答えを決める
→ ポインタ更新先を紙に書き出して追跡するクセを付けましょう。
FAQ
Q: EDGE->statusを 'A' にしてもデータ部分が無いのは矛盾しませんか?
A: 本アルゴリズムでは 'A'/'F' は「結合対象か否か」を示すフラグです。EDGEは結合対象外にしたいだけなのでサイズ0のまま 'A' で問題ありません。
A: 本アルゴリズムでは 'A'/'F' は「結合対象か否か」を示すフラグです。EDGEは結合対象外にしたいだけなのでサイズ0のまま 'A' で問題ありません。
Q: 'A' 以外に特別なマーク(例:'E')を設けても良いですか?
A: 可能ですが、ソース全体に新しい状態を認識させる修正が必要です。既存の 'A'/'F' だけで済むなら設計・実装コストを抑えられます。
A: 可能ですが、ソース全体に新しい状態を認識させる修正が必要です。既存の 'A'/'F' だけで済むなら設計・実装コストを抑えられます。
Q: 末尾ブロックを解放するときもEDGEは安全ですか?
A: はい。末尾ブロックではrがEDGEを指しますが、EDGE->statusが 'A' のため併合は発生せず、番兵は保持されます。
A: はい。末尾ブロックではrがEDGEを指しますが、EDGE->statusが 'A' のため併合は発生せず、番兵は保持されます。
関連キーワード: ダミーノード、循環リンクリスト、空きブロック結合、旗ビット、境界条件
設問2:〔メモリ解放の関数〕について、(1)、(2)に答えよ。
問題文を見る模範解答
キ:p->size + q->size + r->size + 2*HSIZE
ク:p
ケ:q->size + r->size + HSIZE
解説
解答の導き方
図4のfreememを順に追うと、最初に
"p ← q->prev"(q の前のブロックが p)と
"r ← q->next"(q の後のブロックが r)と定義していることが分かります。次に条件分岐で
"if (p->statusが 'F' と等しい) then"(前が空きか)およびその中の
"if (r->statusが 'F' と等しい) then"(後も空きか)を調べています。したがって場合分けは次の3通りです。
-
前後とも空き(p->status == 'F' 且つr->status == 'F')のとき
コードの該当部分は "p->next ← r->next"
"p->size ← [a]"
"p->next->prev ← [b]"
となっています。ここで物理的な並びは(左から)pヘッダ・pデータ・qヘッダ・qデータ・rヘッダ・rデータです。マージ後はpのヘッダだけ残り、それ以外はすべてデータ領域になります。よって新しいp->sizeは元の各データの合計に、qとrのヘッダ分がデータに含まれる分を加えたものになります。式で表すと です。さらに "p->next ← r->next" の直後に "p->next->prev ← [b]" としているので、双方向リストの prev を正しく保つために [b] は p でなければなりません。 -
前が空きで後が割当て済み(p->status == 'F' 且つr->status != 'F')のとき
コードは "p->next ← r" と "p->size ← p->size + q->size + HSIZE" としており、ここでは p と q を結合します。物理的に取り除かれるヘッダは q のヘッダだけなので加算は HSIZE 1 個分です。従って p->size の更新式は (これはコード中に既に書かれている通り)です。 -
前が割当て済みで後が空き(p->status != 'F' 且つr->status == 'F')のとき
コードは "q->next ← r->next" と "q->size ← [c]" の形です。ここでは q と r を結合して q を先頭とする空きブロックにします。物理的に取り除かれるヘッダは r のヘッダだけなので、q->size は となります。最後にq->statusを 'F' にして空きにすることもコードにあります。
以上の導出から、図4中の空欄に入る値は次のようになります。
キ:
ク:p
ケ:
ク:p
ケ:
誤りやすいポイント
-
ヘッダ分(HSIZE)の扱いを忘れる/個数を間違える
— マージするときに消えるヘッダ分がデータに含まれるため、片側マージで +HSIZE、両側マージで +2*HSIZEとなる点を確実に押さえてください。 -
prev/nextの再接続を誤る
— p->nextを書き換えたら必ずp->next->prevを正しいブロック(ここではp)に設定する必要があります。これを忘れると双方向リストが壊れます。 -
変数の取り違え(p, q, r)
— pはqの前、rはqの後です。処理対象(どのブロックを先頭に残すか)に応じてサイズを更新する変数が変わるので注意してください(前側マージではp->sizeを更新、後側マージではq->sizeを更新)。 -
q->statusを 'F' にするのを忘れるケース
— 前が割当て済みで後が空きの分岐では、結合後のブロック(先頭は q)を空きにするため q->status ← 'F' を行う必要があります。 -
番兵EDGEのstatusの設定
— freememは隣接ブロックのstatusを見て結合を行うため、番兵であるEDGEのメンバstatusは 'A' にして結合対象にならないようにしておく必要があります。これを 'F' にしてしまうと境界を越えて不適切に結合しようとします。
FAQ
Q: なぜマージでHSIZEを足す必要があるのですか?
A: 本文にあるとおり "ヘッダ部分のバイト数は、HSIZEとする" ため、隣接ブロックのヘッダ(HSIZEバイト)はマージ後はデータ領域側に取り込まれます。片側マージはヘッダ1つ分(+HSIZE)、両側マージはヘッダ2つ分(+2*HSIZE)を足す必要があります。
A: 本文にあるとおり "ヘッダ部分のバイト数は、HSIZEとする" ため、隣接ブロックのヘッダ(HSIZEバイト)はマージ後はデータ領域側に取り込まれます。片側マージはヘッダ1つ分(+HSIZE)、両側マージはヘッダ2つ分(+2*HSIZE)を足す必要があります。
Q: p->next->prevに何を入れるべきか分からないときの考え方は?
A: まずp->nextをどのブロックに向けたかを見ると答えが出ます。p->nextをr->nextにしたなら、そのブロックのprevはpに戻す必要があります。要は双方向リンクが整合するよう両側を更新することです。
A: まずp->nextをどのブロックに向けたかを見ると答えが出ます。p->nextをr->nextにしたなら、そのブロックのprevはpに戻す必要があります。要は双方向リンクが整合するよう両側を更新することです。
Q: EDGEのstatusを 'A' にする理由をもう少し具体的に教えてください。
A: freememは前後のブロックのstatusが 'F' かどうかで結合判定をします。EDGEを 'F' にしておくと、ヒープの端を越えて番兵と結合しようとして不正な結合が発生します。番兵は境界を示すだけで結合対象にしたくないため、'A'(割当て済み)にしておきます。
A: freememは前後のブロックのstatusが 'F' かどうかで結合判定をします。EDGEを 'F' にしておくと、ヒープの端を越えて番兵と結合しようとして不正な結合が発生します。番兵は境界を示すだけで結合対象にしたくないため、'A'(割当て済み)にしておきます。
関連キーワード: メモリ管理、フリーリスト、メモリ断片化、メモリコンパクション、番兵(セントリネル)
設問3:〔メモリコンパクション〕について、(1)〜(3)に答えよ。
問題文を見る(1)本文中のコに入れる適切な字句をカタカナで答えよ。
模範解答
コ:フラグメンテーション
解説
解答の論理構成
-
問題文では次のように状況と用語を提示しています。「メモリの確保や解放の処理を繰り返すと、サイズの小さな空きメモリが分散してしまい、サイズの大きな空きメモリの確保が難しくなることがある。このような現象をコと呼ぶ。」
-
キーワードは「サイズの小さな空きメモリが分散」「サイズの大きな空きメモリの確保が難しくなる」。
これはヒープ領域に細切れの空き領域が点在し、連続領域が不足する典型的な問題の説明です。 -
動的メモリ管理分野で、細切れの空き領域が散在してしまう現象は一般に「フラグメンテーション(fragmentation)」と呼びます。
内部・外部に大別されますが、問題文が述べる「空きメモリが分散」は外部フラグメンテーションの典型です。 -
以上より、コ に入る語は 「フラグメンテーション」 が妥当です。
誤りやすいポイント
- 「メモリコンパクション」と混同
コンパクションはフラグメンテーションを解消する手段であって現象名ではありません。 - 「デフラグメンテーション」と誤記
デフラグはフラグメンテーションを直す操作を指す用語であり、空き領域が散在する状態そのものを示しません。 - 内部/外部の区別が頭に浮かび、設問がどちらかを問うと誤解
設問は現象の総称を聞いているため、どちらにも共通する「フラグメンテーション」で解答します。
FAQ
Q: 「フラグメンテーション」と「メモリコンパクション」の違いは何ですか?
A: 「フラグメンテーション」は空き領域がバラバラになる“現象”で、「メモリコンパクション」はその現象を解消するために割当て済みブロックを詰め、大きな連続空き領域を作る“操作”です。
A: 「フラグメンテーション」は空き領域がバラバラになる“現象”で、「メモリコンパクション」はその現象を解消するために割当て済みブロックを詰め、大きな連続空き領域を作る“操作”です。
Q: 内部フラグメンテーションと外部フラグメンテーションを区別する必要はありますか?
A: 本設問では分散した空きメモリが問題になっているため外部フラグメンテーションの説明に近いですが、解答としては総称の「フラグメンテーション」で十分です。
A: 本設問では分散した空きメモリが問題になっているため外部フラグメンテーションの説明に近いですが、解答としては総称の「フラグメンテーション」で十分です。
Q: フラグメンテーションを完全に防ぐ方法はありますか?
A: 完全に防ぐことは難しく、ガーベジコレクションやメモリプール、メモリコンパクションなどの対策を組み合わせて影響を抑えます。
A: 完全に防ぐことは難しく、ガーベジコレクションやメモリプール、メモリコンパクションなどの対策を組み合わせて影響を抑えます。
関連キーワード: フラグメンテーション、メモリコンパクション、ヒープ領域、動的メモリ割り当て
設問3:〔メモリコンパクション〕について、(1)〜(3)に答えよ。
問題文を見る(2)本文中のサに入れる適切な式を答えよ。
模範解答
サ:2 × HSIZE + 600
解説
解答の論理構成
-
ヘッダの性質
問題文冒頭で
「メモリブロックは、固定長のヘッダ部分と可変長のデータ部分で構成される。…ヘッダ部分のバイト数は、HSIZEとする。」
と述べられています。したがって各ブロックごとにHSIZEバイトのヘッダが存在します。 -
メモリコンパクション後の状態
メモリコンパクションでは「割当て済みのメモリブロックが連続するようにメモリブロックを移動し、移動したメモリブロックの後ろに大きな空きメモリを確保」します。- 3個の空きブロックは1か所にまとめられ、データ部分は200 + 300 + 100 = 600バイト。
- ヘッダは 3個 → 1個 に減るため、不要になるヘッダは2 × HSIZEバイト。
-
まとめ
以上より、コンパクション後に連続して確保できる空き容量は
600(データ部分合計) + 2 × HSIZE(余剰ヘッダ分) バイトとなります。よって サ に入る式は
2 × HSIZE + 600 です。
誤りやすいポイント
- ヘッダサイズを加味せずに600だけを書いてしまう。
- 「まとめ後のブロックにもヘッダが1個残る」ことを忘れ、3 × HSIZEを足してしまう。
- 図6が2段に描かれているため「上下で別領域」と誤解し、空きブロックを2個と数えてしまう。
- sizeフィールドにヘッダ分が既に含まれていると勘違いする。
FAQ
Q: HSIZEの具体的な値が問題文にないのに式で答えるのはなぜですか?
A: 本問は「式」を求める設問です。ヘッダ長は実装依存のため定数HSIZEのまま示すことが正解になります。
A: 本問は「式」を求める設問です。ヘッダ長は実装依存のため定数HSIZEのまま示すことが正解になります。
Q: メモリコンパクションでヘッダが減る仕組みを一言で言うと?
A: 離散していた空きブロックを一つに統合する過程で、先頭1個だけヘッダを残し、残りのヘッダ領域をデータ領域に取り込むからです。
A: 離散していた空きブロックを一つに統合する過程で、先頭1個だけヘッダを残し、残りのヘッダ領域をデータ領域に取り込むからです。
Q: 割当て済みブロックの移動でポインタはどう更新されますか?
A: コンパクション時には各ブロックのprev・nextだけでなく、そのブロックを指していたアプリ側ポインタも再設定する必要があります(本文の①が示す注意点)。
A: コンパクション時には各ブロックのprev・nextだけでなく、そのブロックを指していたアプリ側ポインタも再設定する必要があります(本文の①が示す注意点)。
関連キーワード: メモリコンパクション、外部フラグメンテーション、可変長メモリ管理、ヒープ、ヘッダオーバヘッド
設問3:〔メモリコンパクション〕について、(1)〜(3)に答えよ。
問題文を見る(3)本文中の下線①の理由を25字以内で述べよ。
模範解答
メモリブロックの先頭アドレスが変わるから
解説
解答の論理構成
- 問題文には「①メモリコンパクション前に実行したメモリ割当て関数の戻り値は、メモリ解放の関数の引数としては使えなくなる場合がある」とあります。
- メモリコンパクションとは「割当て済みのメモリブロックが連続するようにメモリブロックを移動し、移動したメモリブロックの後ろに大きな空きメモリを確保する」操作です。
- 移動とは物理アドレス(実アドレス)を詰め直す処理を指し、ブロックの「先頭アドレス」が書き換わることを意味します。
- メモリ割当て関数の戻り値は割当て直後のブロック先頭アドレスです。コンパクションでそのアドレスが変化すると、以前取得したポインタはヒープ内の正しいブロックを指さなくなります。
- その結果、ポインタをそのままfreememに渡すと誤動作や破壊的書込みを招くため、「使えなくなる場合がある」という警告が成立します。
- 以上より、理由は「メモリブロックの先頭アドレスが変わるから」となります。
誤りやすいポイント
- メモリコンパクション=ガーベジコレクションと早合点し、先頭アドレスの変更を意識しない。
- 仮想アドレス採用OSではアドレス固定と思い込み、本問題のような物理アドレス前提の実装を忘れる。
- 「戻り値が無効」=必ずNULLになると誤解し、ポインタ値自体は残ることを見落とす。
- コンパクション対象が空き領域だけだと勘違いし、割当て済みブロックが移動する事実を見落とす。
FAQ
Q: メモリコンパクション後にポインタを有効に保つ方法はありますか?
A: 移動前後でテーブルを更新するハンドル方式や、全ポインタを書き換える追跡ガーベジコレクション方式があります。
A: 移動前後でテーブルを更新するハンドル方式や、全ポインタを書き換える追跡ガーベジコレクション方式があります。
Q: コンパクションを行わない設計もありますか?
A: あります。固定サイズブロック方式やスラブアロケータなどは断片化を抑えつつコンパクションを不要にする設計です。
A: あります。固定サイズブロック方式やスラブアロケータなどは断片化を抑えつつコンパクションを不要にする設計です。
Q: 断片化とヒープ枯渇の関係は?
A: 断片化が進むと「空き容量は十分だが連続していない」状態となり、大きい要求を満たせずヒープ枯渇と同様のエラーを返すことがあります。
A: 断片化が進むと「空き容量は十分だが連続していない」状態となり、大きい要求を満たせずヒープ枯渇と同様のエラーを返すことがあります。
関連キーワード: メモリコンパクション、断片化、ポインタ、動的メモリ確保、ヒープ

