
応用情報技術者 2015年 春期 午後 問03
データ圧縮の前処理として用いられるBlock-sortingに関する次の記述を読んで、設問1~4に答えよ。
Block-sortingは、文字列に対する可逆変換の一種である。変換後の文字列は、変換前の文字列と比較して同じ文字が多く続く傾向があるので、その後に行う圧縮処理において圧縮率を向上させることができる。
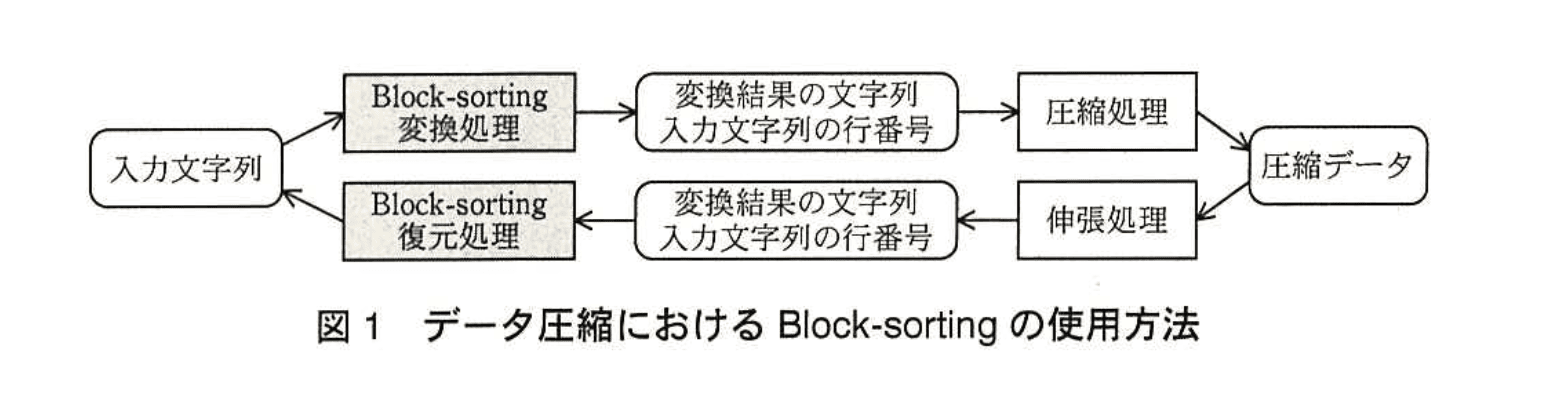
Block-sortingは、変換処理と復元処理の二つの処理で構成される。変換処理は、入力文字列を受け取って、変換結果の文字列と、入力文字列がソート後のブロックで何行目にあるか (以下、入力文字列の行番号という) を出力する。一方、復元処理は、変換結果の文字列と入力文字列の行番号を受け取って入力文字列を出力する。
データ圧縮におけるBlock-sortingの使用方法を図1に示す。
〔Block-sortingの変換処理〕
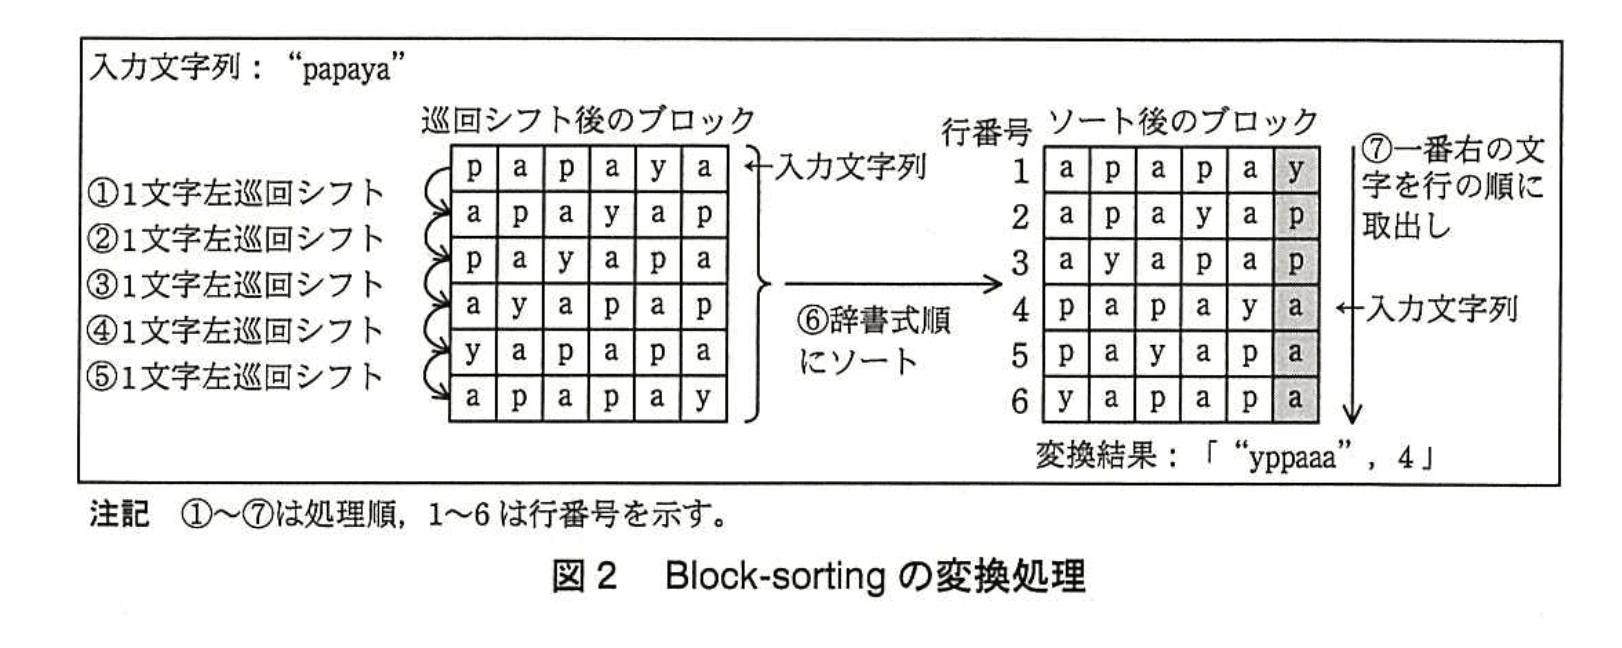
例として “papaya” を入力文字列としたときの変換処理を図2に示す。図2では、入力文字列を1文字左に巡回シフトすること(①)で文字列 “apayap” となる。さらに、もう1文字左に巡回シフトすること(②)で文字列 “payapa” となる。同様に1文字ずつ左に巡回シフトした(③〜⑤)結果の文字列を縦に並べて正方形のブロック (巡回シフト後のブロック) を作成する。
次に、このブロックを行単位で辞書式順にソートし(⑥)、ソート後のブロックを得る。ソート後のブロックの各行の文字列から一番右の文字を行の順に取り出して並べた文字列と、ソート後のブロックにおいて入力文字列に一致する行の行番号を変換結果とする(⑦)。
〔Block-sortingの復元処理〕
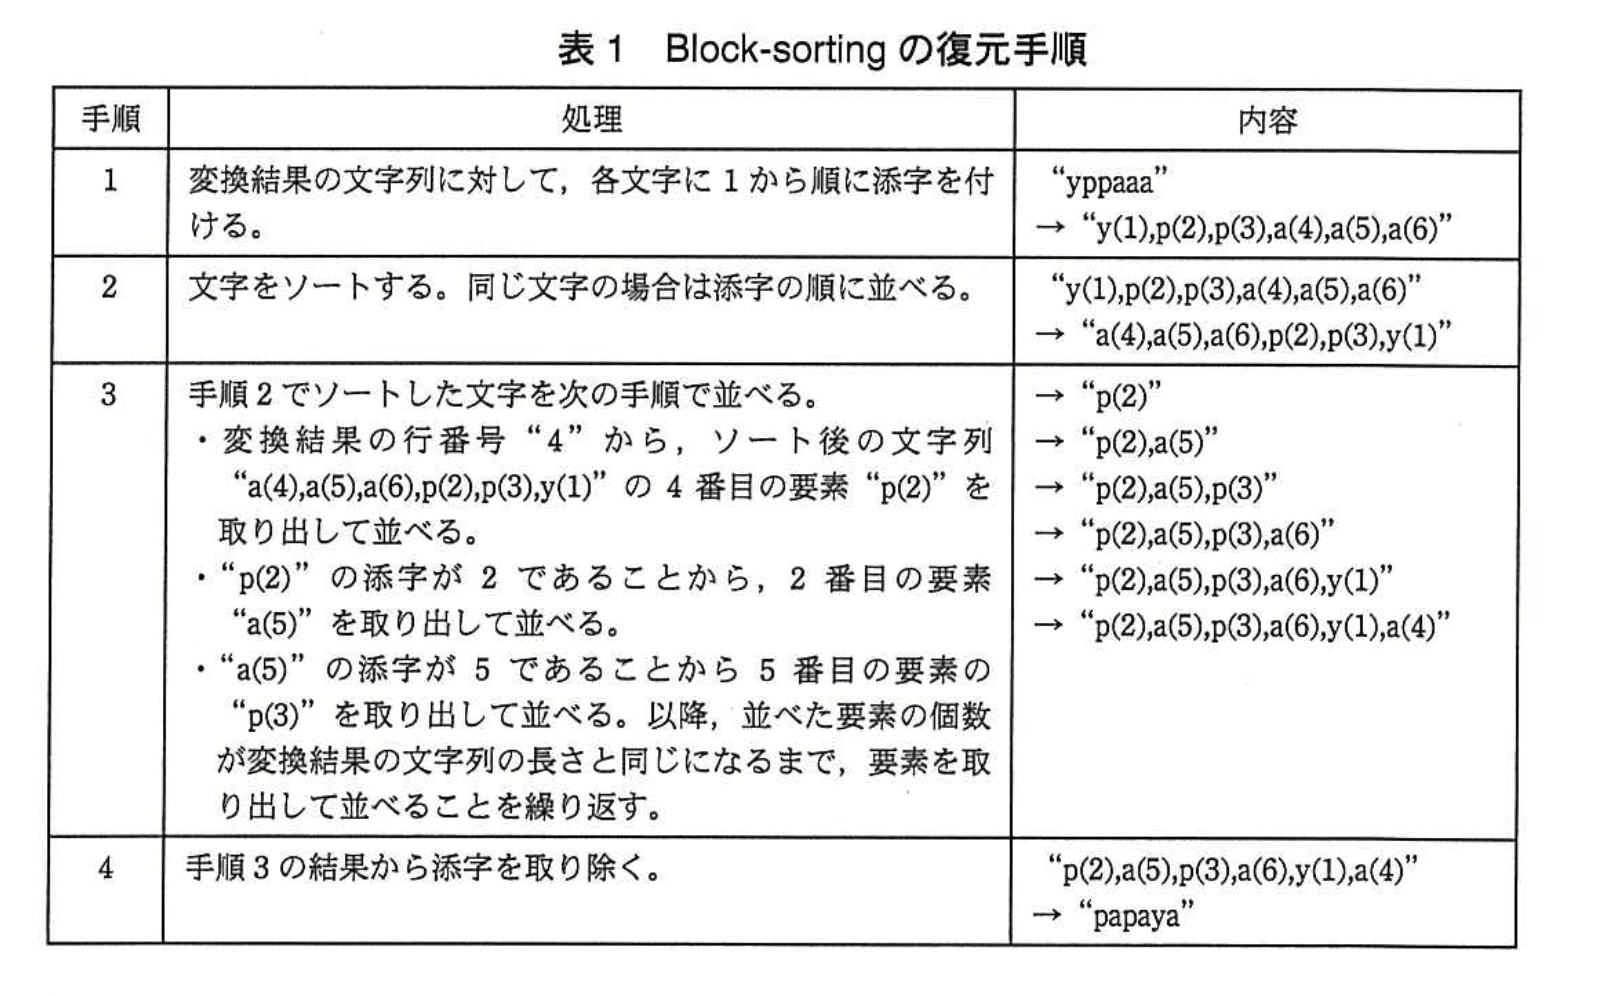
図2の変換結果「“yppaaa”、4」を復元する手順を表1に示す。
〔Block-sortingの実装〕
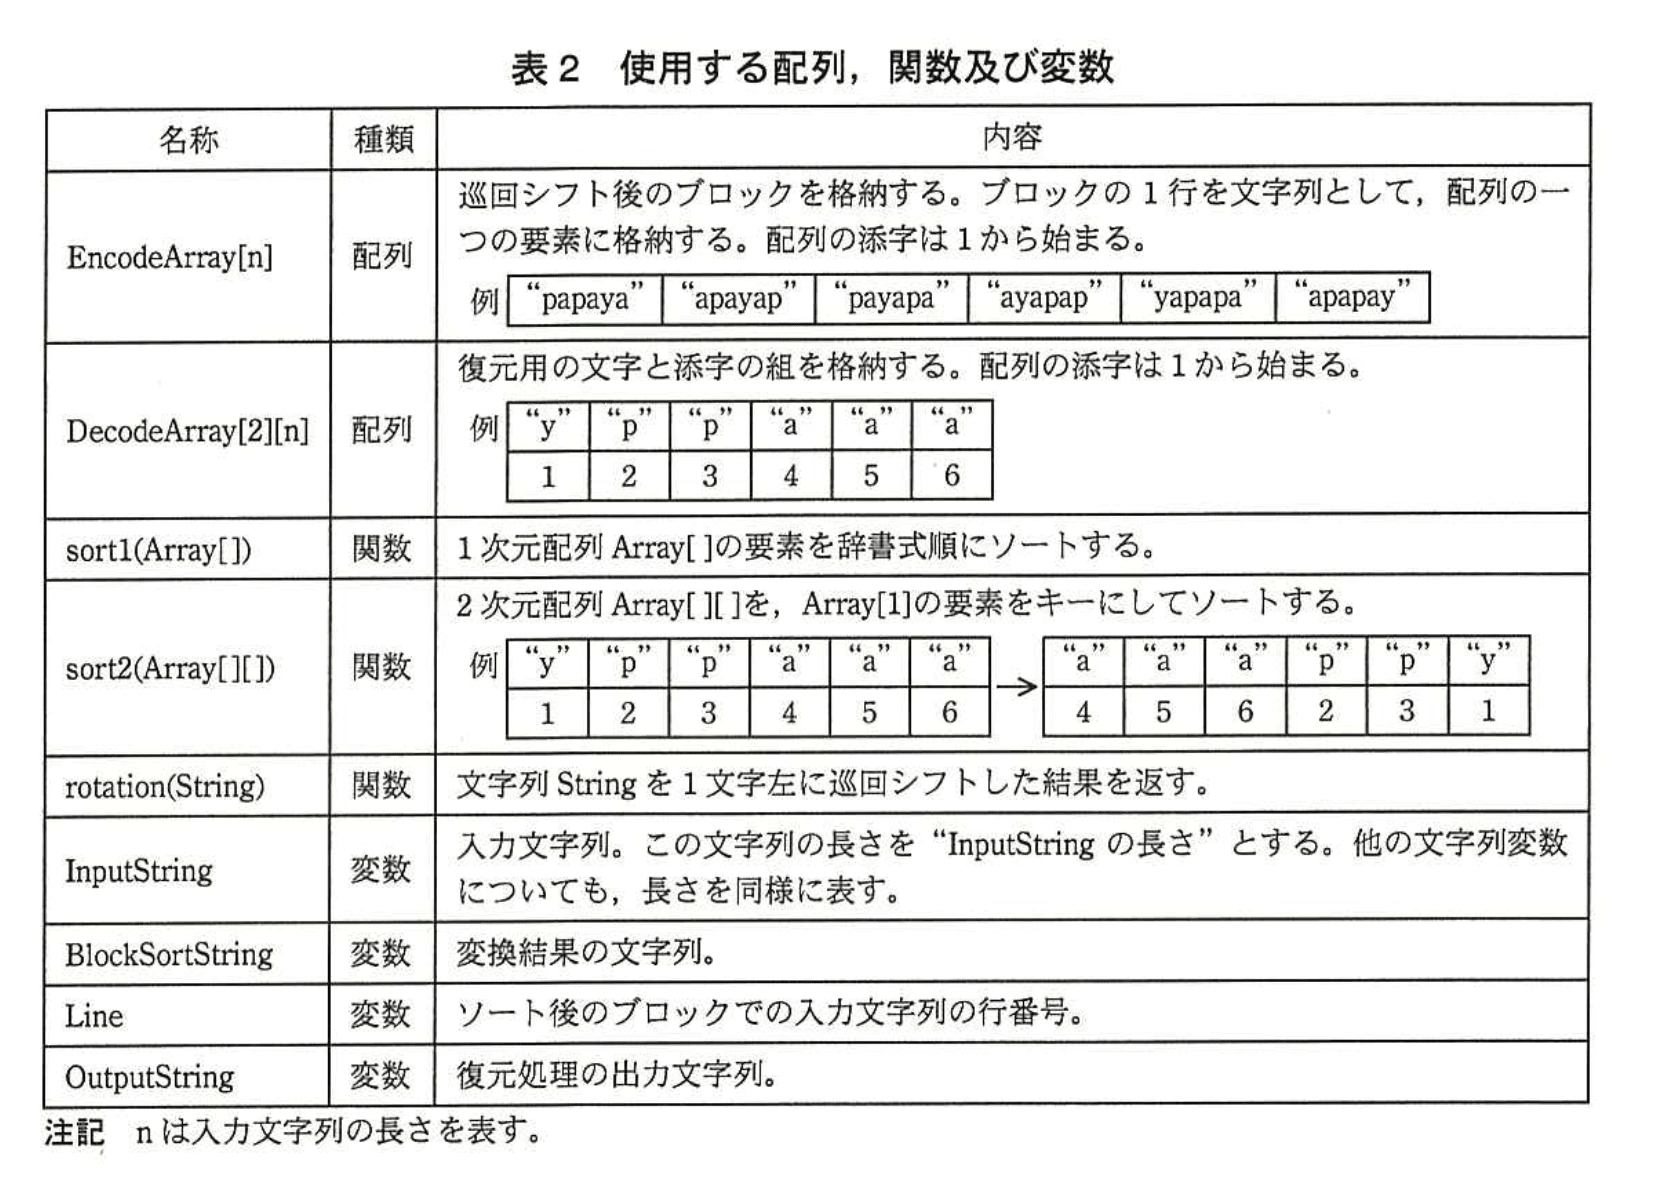
Block-sortingのプログラムを作成するために使用する配列、関数及び変数を、表2に示す。
〔変換処理関数encode〕
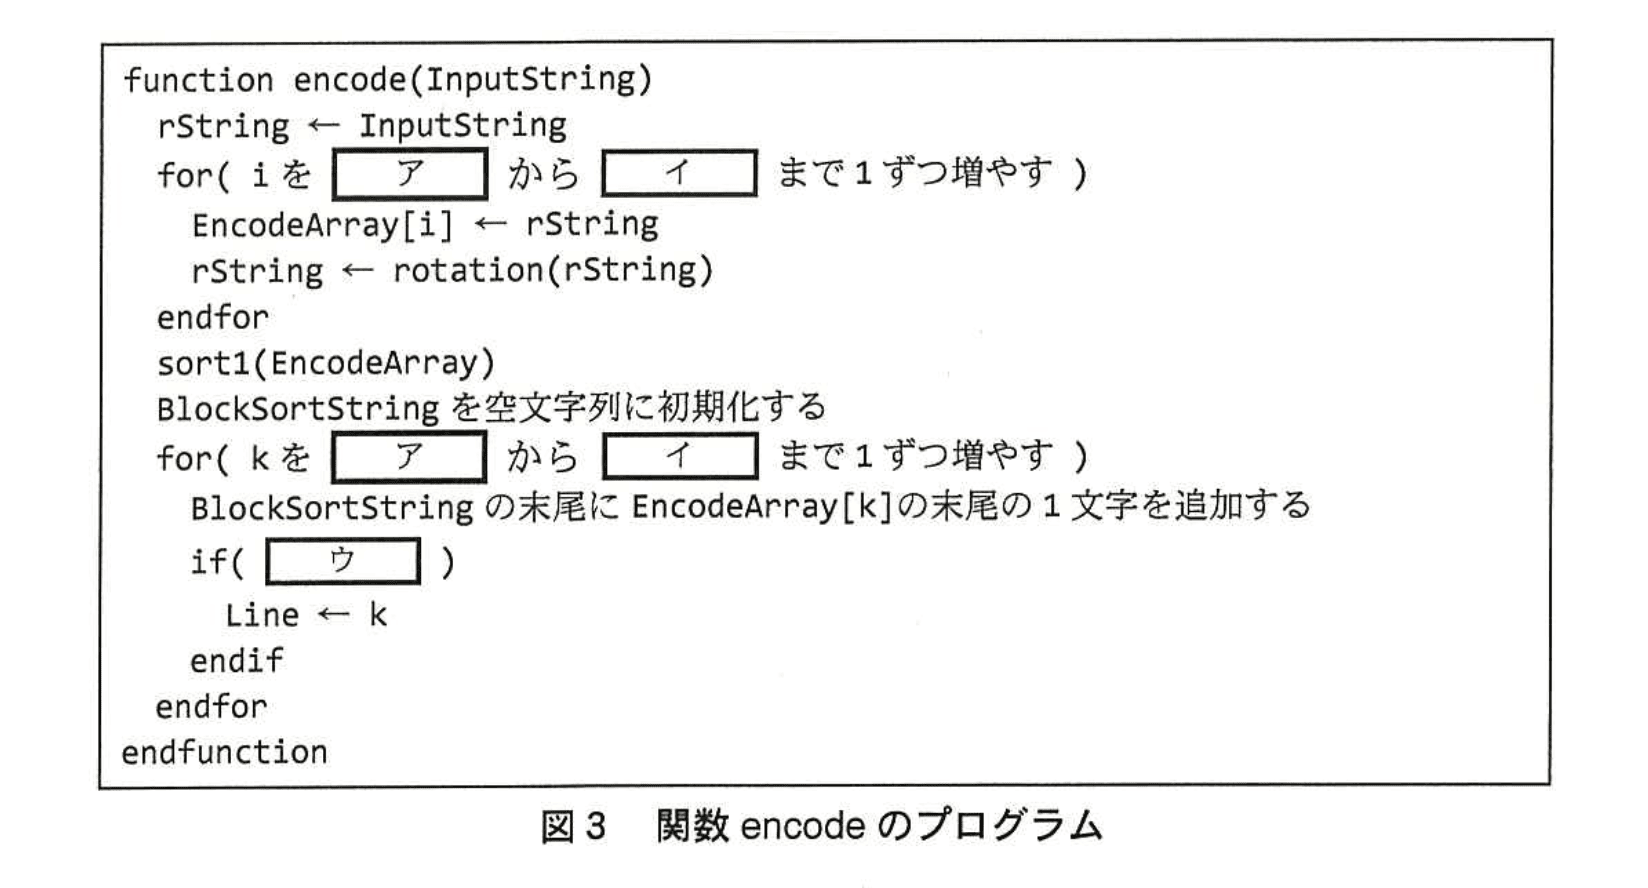
変換処理を実装した関数encodeのプログラムを図3に示す。
〔復元処理関数decode〕
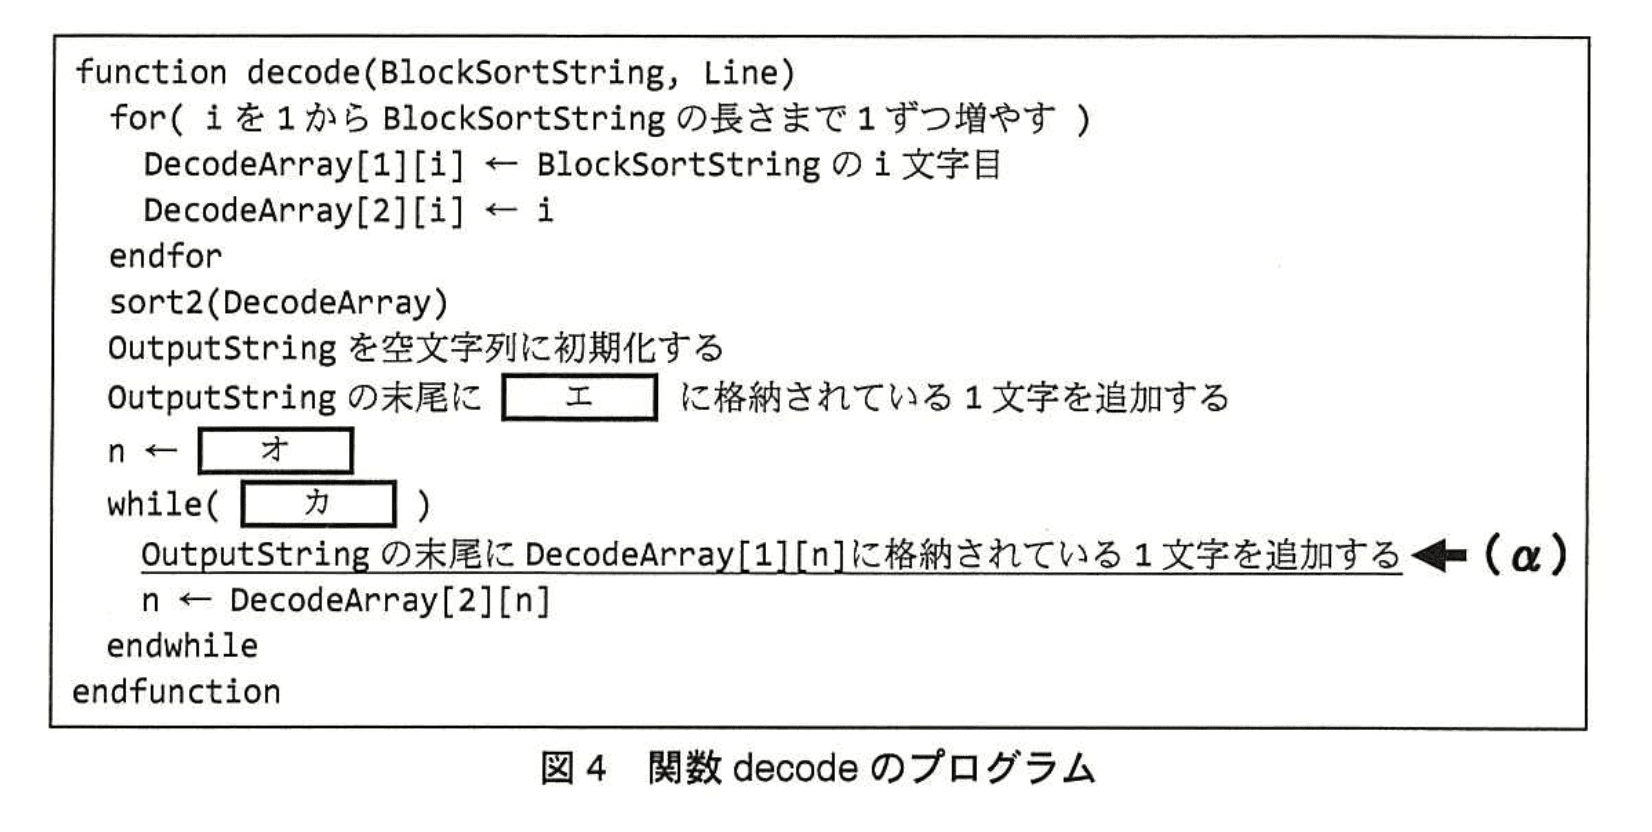
復元処理を実装した関数decodeのプログラムを図4に示す。
〔関数sort2(Array[][])の実装〕
関数decodeの処理時間は、使用する関数sort2(Array[][])の計算量に大きく依存する。処理時間を短くするためには、sort2(Array[][])の内部で計算量が少ないソートのアルゴリズムを使用して実装する必要がある。
処理時間の違いを確認するために複数のソートアルゴリズムを使用して関数sort2(Array[][])を実装したところ、Array[1]の要素をキーにしてクイックソート(不安定なソート)を使用した場合には復元処理の結果が入力文字列と一致しなかった。
この場合、sort2(Array[][])が表1の手順2を正しく実装できていないので、(β)ソートアルゴリズム、ソートキーのいずれかを見直す必要がある。
設問1:
問題文を見る文字列“kiseki”に対してBlock-sortingを適用して変換した結果を答えよ。変換結果は図2の記法に合わせて記述すること。
模範解答
“skkeii”, 5
解説
解答の論理構成
1.【問題文】には「入力文字列を1文字左に巡回シフトすること(①)…同様に1文字ずつ左に巡回シフトした(③〜⑤)結果の文字列を縦に並べて正方形のブロック (巡回シフト後のブロック) を作成する。」とあります。
文字列“kiseki”を0〜5回左に巡回シフトして6行のブロックを作ると
文字列“kiseki”を0〜5回左に巡回シフトして6行のブロックを作ると
-
kiseki
-
isekik
-
sekiki
-
ekikis
-
kikise
-
ikisek
-
次に「このブロックを行単位で辞書式順にソートし(⑥)」ます。6行を昇順に並べ替えると
- ekikis
- ikisek
- isekik
- kikise
- kiseki ←入力文字列
- sekiki
-
「ソート後のブロックの各行の文字列から一番右の文字を行の順に取り出して並べた文字列」として(⑦)
・ekikis → s
・ikisek → k
・isekik → k
・kikise → e
・kiseki → i
・sekiki → i
を連結すると “skkeii” になります。 -
「ソート後のブロックにおいて入力文字列に一致する行の行番号」を求めると、入力文字列“kiseki”は5行目なので行番号は5です。
以上より変換結果は
“skkeii”, 5
“skkeii”, 5
誤りやすいポイント
- 巡回シフト方向を逆にしてしまい、行列自体が間違う。
- ソート後の行番号ではなく、シフト生成時の行番号を答えてしまう。
- 同じ文字が続く場合、辞書式順で「添字の順(安定ソート)」になることを忘れ、不安定ソートの結果を用いてしまう。
- 末尾文字列を作る際に行順を崩してしまい、“skkeii” の文字順を取り違える。
FAQ
Q: 行数と文字列長が一致しないケースでも手順は同じですか?
A: はい。Block-sortingは「入力文字列の長さ=ブロックの行数=列数」という前提で動作します。長さが変わっても手順①〜⑦は不変です。
A: はい。Block-sortingは「入力文字列の長さ=ブロックの行数=列数」という前提で動作します。長さが変わっても手順①〜⑦は不変です。
Q: 辞書式順とは具体的にどの順序を指しますか?
A: 文字コード(例:ASCII)の昇順で比較し、先頭文字が同じ場合は2文字目以降を順に比較します。【問題文】にあるとおり、同じ文字列が複数現れる場合は「添字の順」を維持します。
A: 文字コード(例:ASCII)の昇順で比較し、先頭文字が同じ場合は2文字目以降を順に比較します。【問題文】にあるとおり、同じ文字列が複数現れる場合は「添字の順」を維持します。
Q: 行番号は0から数えてはいけませんか?
A: いけません。本問題では「配列の添字は1から始まる」と明示されているため、行番号も1始まりで数えます。
A: いけません。本問題では「配列の添字は1から始まる」と明示されているため、行番号も1始まりで数えます。
関連キーワード: Block-sorting, 巡回シフト, 辞書式ソート, 安定ソート, バローズホイラー変換

設問2:
問題文を見る模範解答
ア:1
イ:InputStringの長さ
ウ:EncodeArray[k]がInputStringと同一
解説
解答の導き方
-
最初のforループの始点(ア)について
図3の先頭で rString ← InputString と初期化されています。また表2の説明に「EncodeArray[n]は巡回シフト後のブロックを格納する。配列の添字は1から始まる」とあります。ループは rString を順に EncodeArray に格納し、毎回 rotation(rString) を行って次の巡回シフトを得るので、巡回シフトをすべて(元の文字列を含めて)格納するには添字を1から始めて n 回繰り返す必要があります。したがってアは 1 です。 -
ループの終点(イ)について
上と同じ理由でループは入力文字列の長さ分だけ実行し、全ての巡回シフト(合計 個)をEncodeArray[1]~EncodeArray[] に格納します。問題文ではnを「入力文字列の長さ」と定義しているので、ループ終点はInputStringの長さ になります。よってイはInputStringの長さ です。(根拠となる記述:図3 のループ内で毎回 rString ← rotation(rString) を行うこと、表2 の rotation の説明「文字列Stringを1文字左に巡回シフトした結果を返す」、および「配列の添字は1から始まる」。) -
条件式(ウ)について
図3ではsort1(EncodeArray) の後にソート済みの各行(EncodeArray[k])の末尾文字をBlockSortStringに追加し、該当行の行番号をLineに格納する処理があることが分かります。問題文の変換処理の説明に「ソート後のブロックにおいて入力文字列に一致する行の行番号を変換結果とする」と明記されているため、ソート後の各行が元の入力文字列と一致するかを判定して一致した行の添字をLineに代入すれば要件を満たします。したがってウはEncodeArray[k]がInputStringと同一 です。 -
実装上の注意(重要)
ここまでで空欄は次のように決まります。
ア:1
イ:InputStringの長さ
ウ:EncodeArray[k]がInputStringと同一ただし重要な補足として、InputStringに周期性がある(例:「aaaa」「ababab」など)と巡回シフトで同じ文字列が複数行生成され得ます。その場合、ソート後に同一の文字列が複数存在するため、単に文字列比較だけではどの行が「元の入力文字列の行」に対応するかが確定できません。これを正しく扱うためには、sort1が等しい要素間の相対順序を保持する「安定ソート」であることを保証するか、ソート時に元の添字を第二キーとして保持する実装(添字を一緒にソートする、あるいは添字をキーにしてソートする)にする必要があります。問題文でも図4側の実験でsort2に不安定なアルゴリズム(クイックソート)を使うと復元が一致しなかったことが指摘されており、等しい要素の扱い(安定性)が正否を分けます。
誤りやすいポイント
- 配列の添字が1始まりである点を見落とし、0始まりで実装してしまう(オフバイワンによる誤り)。表2に「配列の添字は1から始まる」とあることを確認する。
- 「EncodeArray[k]の末尾の1文字」を取り出す箇所で先頭文字を使ってしまうなど、末尾/先頭の取り違えをする。
- 巡回シフトで生成される行は必ず一意だと誤解すること。周期性のある文字列では重複行が生じるため、重複時の扱い(安定ソートまたは添字の保持)を考慮しないとencode/decodeが噛み合わない。
- sort1(1次元配列のソート)とsort2(2次元配列をキーでソートする)の役割を混同し、どちらに安定性が必要かを誤る。復元処理ではsort2の安定性が特に重要である。
FAQ
Q: InputStringが "aaaa" のように全て同じ文字のとき、EncodeArray[k]がInputStringと同一 の判定はどうなるのですか?
A: 文字列比較自体は複数行で真になります。どの行をLineに選ぶかはソート後に等しい要素間の並び順に依存します。したがって実装ではsort1を安定ソートにするか、回転時に元の添字を保持してソート時に添字を第二キーにする必要があります。安定性が保証されれば元の行順が保たれ、復元は正しく行えます。
A: 文字列比較自体は複数行で真になります。どの行をLineに選ぶかはソート後に等しい要素間の並び順に依存します。したがって実装ではsort1を安定ソートにするか、回転時に元の添字を保持してソート時に添字を第二キーにする必要があります。安定性が保証されれば元の行順が保たれ、復元は正しく行えます。
Q: 図4のdecodeでsort2にクイックソート(不安定)を使うと復元が失敗した理由は何ですか?
A: decode は最初に DecodeArray[2][i] ← i として元の添字を保持し、次に文字でソートしてから添字をたどることで復元します。等しい文字が複数ある場合、ソートで等キー間の相対順序が変わると添字の並びが変わり、以後の添字たどり(手順3)が崩れて正しい順序で復元できなくなります。したがって sort2 も安定ソートであるか、ソート時に添字を第二キーに使う実装が必要です。
A: decode は最初に DecodeArray[2][i] ← i として元の添字を保持し、次に文字でソートしてから添字をたどることで復元します。等しい文字が複数ある場合、ソートで等キー間の相対順序が変わると添字の並びが変わり、以後の添字たどり(手順3)が崩れて正しい順序で復元できなくなります。したがって sort2 も安定ソートであるか、ソート時に添字を第二キーに使う実装が必要です。
Q: 安定ソートを用意できない環境でも正しく動作させる方法はありますか?
A: はい。各回転文字列に元の添字を付けた二要素(文字列, 元添字)を保持し、ソート時に第一キーを文字列、第二キーを元添字として比較する実装にすれば、ソートアルゴリズムが不安定でも等しい文字列間の順序を制御できます。これにより復元の整合性が保たれます。
A: はい。各回転文字列に元の添字を付けた二要素(文字列, 元添字)を保持し、ソート時に第一キーを文字列、第二キーを元添字として比較する実装にすれば、ソートアルゴリズムが不安定でも等しい文字列間の順序を制御できます。これにより復元の整合性が保たれます。
関連キーワード: 巡回シフト、辞書式順ソート、安定ソート、添字付け、Burrows-Wheeler変換
設問3:〔復元処理関数decode〕について、(1)、(2)に答えよ。
問題文を見る模範解答
エ:DecodeArray[1][Line]
オ:DecodeArray[2][Line]
カ:OutputStringの長さがBlockSortStringの長さより小さい
解説
解答の論理構成
-
表1の手順3は、まず行番号で指示された位置から1文字を取り出し、次にその添字をたどる操作を繰り返します。原文は
「変換結果の行番号 “4” から、ソート後の文字列 “a(4),a(5),a(6),p(2),p(3),y(1)” の4番目の要素 “p(2)” を取り出して並べる。」
と記述しており、この “4番目の要素” がDecodeArrayの行Lineに相当します。したがって、最初に追加する1文字は
DecodeArray[1][Line] です。 -
同じく手順3には
「“p(2)” の添字が2であることから、2番目の要素 … を取り出して並べる。」
とあるため、次に参照すべき行番号は行Lineに格納されている添字、すなわちDecodeArray[2][Line] となります。 -
ループをいつ止めるかについて表1は
「並べた要素の個数が変換結果の文字列の長さと同じになるまで … を繰り返す。」
と述べています。プログラムでは “個数” をOutputStringの長さで、 “変換結果の文字列の長さ” をBlockSortStringの長さで表現するため、条件は
OutputStringの長さがBlockSortStringの長さより小さい です。
以上より、図4中の空所は
エ:DecodeArray[1][Line]
オ:DecodeArray[2][Line]
カ:OutputStringの長さがBlockSortStringの長さより小さい
エ:DecodeArray[1][Line]
オ:DecodeArray[2][Line]
カ:OutputStringの長さがBlockSortStringの長さより小さい
誤りやすいポイント
- 行番号Lineを “添字” と取り違え、DecodeArray[2][Line] ではなくDecodeArray[2][n] を初期値に入れてしまう。
- ループ終了条件を “以下” と書いてしまい、1文字足りない/多い出力になるoff-by-oneエラー。
- sort2を不安定ソートで実装し、同じ文字の順序が崩れて復元不能になる。設問本文の「(β)ソートアルゴリズム、ソートキーのいずれかを見直す必要がある」はこの典型例。
FAQ
Q: Lineは0始まりですか1始まりですか?
A: 問題文の「配列の添字は1から始まる。」という注記に従い、Lineも1始まりです。
A: 問題文の「配列の添字は1から始まる。」という注記に従い、Lineも1始まりです。
Q: sort2が安定ソートでなければならない理由は?
A: 表1手順2の「同じ文字の場合は添字の順に並べる。」を守るには安定ソートが必要です。不安定ソートでは添字順が保存されず、復元が破綻します。
A: 表1手順2の「同じ文字の場合は添字の順に並べる。」を守るには安定ソートが必要です。不安定ソートでは添字順が保存されず、復元が破綻します。
Q: OutputStringとBlockSortStringの長さが等しい時にループを抜けるのはなぜ?
A: 表1手順3にある「並べた要素の個数が変換結果の文字列の長さと同じになるまで」処理を続けるためです。
A: 表1手順3にある「並べた要素の個数が変換結果の文字列の長さと同じになるまで」処理を続けるためです。
関連キーワード: Block-sorting, Burrows–Wheeler変換, 安定ソート, 復元アルゴリズム, 巡回シフト
設問3:〔復元処理関数decode〕について、(1)、(2)に答えよ。
問題文を見る(2)BlockSortStringの長さがpのとき、図4中の下線(α)の処理の実行回数を答えよ。
模範解答
p−1
解説
解答の論理構成
- 復元処理decodeは、まずOutputStringに1文字だけ追加します。
引用:「OutputStringの末尾に エ に格納されている1文字を追加する」 - その後、whileループ内の下線部 (α) で1回の繰返しにつき1文字ずつ追加します。
引用:「OutputString の末尾に DecodeArray[1][n] に格納されている 1 文字を追加する ← (α)」 - ループの継続条件は カ で示されており、表1の手順3に対応します。
引用:「並べた要素の個数が変換結果の文字列の長さと同じになるまで…繰り返す。」 - 問題文で「BlockSortStringの長さがp」と与えられていますから、最終的にOutputStringにはp文字が入るまで繰返します。
- すでに1文字はループ外で追加済みなので、残りはp-1文字。
- 従って、下線部 (α) が実行される回数はp-1回となります。
誤りやすいポイント
- ループ外で1文字追加していることを見落とし、p回と答えてしまう。
- 表1の手順3は「要素を取り出して並べる」処理全体を指すと誤解し、(α) の部分的なカウントを間違える。
- カ の条件を「DecodeArrayが空になるまで」などと曲解し、実際の停止タイミングを読み違える。
FAQ
Q: カ の具体的な条件は何ですか?
A: 一般的には「OutputStringの長さ < BlockSortStringの長さ」のように、復元対象の長さに達するまでループする条件になります。
A: 一般的には「OutputStringの長さ < BlockSortStringの長さ」のように、復元対象の長さに達するまでループする条件になります。
Q: もしBlockSortStringが長さ1のときでも同じ式で良いのですか?
A: はい。長さ1の場合、最初に1文字追加した時点でOutputStringは長さ1となり、while条件が偽になるため (α) は0回実行されます。式p-1は1-1=0となり整合します。
A: はい。長さ1の場合、最初に1文字追加した時点でOutputStringは長さ1となり、while条件が偽になるため (α) は0回実行されます。式p-1は1-1=0となり整合します。
Q: (α) の中で n ← DecodeArray[2][n] と更新していますが、これは回数に影響しますか?
A: 回数自体には影響しません。nの更新は取り出す次の文字位置を決めるだけで、ループの終了判定はあくまで カ で行われます。
A: 回数自体には影響しません。nの更新は取り出す次の文字位置を決めるだけで、ループの終了判定はあくまで カ で行われます。
関連キーワード: Block-sorting, 巡回シフト, 辞書式順ソート, 可逆変換, 安定ソート
設問4:
問題文を見る本文中の下線(β)について、ソートアルゴリズムを見直す場合とソートキーを見直す場合のそれぞれについて、どのように見直せばよいかを30字以内で述べよ。
模範解答
ソートアルゴリズム:同じ文字の場合に元の順序を保持するソートを使用する。
ソートキー:2番目のソートキーにArray[2]の要素を加える。
解説
解答の論理構成
- 表1手順2には「“同じ文字の場合は添字の順に並べる。”」と明記されています。
これはソートの結果が安定(元の並びを保持)していることを要求しています。 - ところが問題文は「Array[ ][1]の要素をキーにしてクイックソート(不安定なソート)を使用した場合には復元処理の結果が入力文字列と一致しなかった。」と述べています。
不安定ソートでは同じ文字の相対順が崩れ、添字に従うという手順2の条件を満たせず、復元が失敗します。 - よって(β)の見直し案①
「同じ文字の場合に元の順序を保持するソートを使用する」=安定ソートに切替える、が正解となります。 - 見直し案②はソートキーの追加です。手順2の条件をキーで強制的に保証するため、一次キーに文字、二次キーに添字を設定すれば、不安定ソートでも結果は正しくなります。
そこで「2番目のソートキーにArray[2]の要素を加える」と記述します。
誤りやすいポイント
- クイックソートが常に誤りになると決めつける。安定ソートに改良したクイックソート(例えば安定版実装)なら問題ありません。
- 「添字で並べる」処理をループで別途行えばよいと考え、ソート自体の安定性を無視する。
- ソートキー追加案で一次キーを添字、二次キーを文字と誤って設定し、辞書式順を壊してしまう。
FAQ
Q: なぜ添字を二次キーにするだけで復元が成功するのですか?
A: 文字が同じ場合に「添字の順」となる条件をソートキーで直接表現できるためです。二次キーが添字なら、不安定ソートでも結果は安定ソートと同じ並びになります。
A: 文字が同じ場合に「添字の順」となる条件をソートキーで直接表現できるためです。二次キーが添字なら、不安定ソートでも結果は安定ソートと同じ並びになります。
Q: 安定ソートならどのアルゴリズムがお勧めですか?
A: 配列サイズが比較的小さければ挿入ソート、一般にはマージソートやTimsortが高速で安定です。
A: 配列サイズが比較的小さければ挿入ソート、一般にはマージソートやTimsortが高速で安定です。
Q: 不安定ソートを使い続けたい場合の注意点は?
A: 必ず「文字+添字」の複合キーにし、添字を数値として比較してください。文字列連結キーにすると桁数の違いで誤動作します。
A: 必ず「文字+添字」の複合キーにし、添字を数値として比較してください。文字列連結キーにすると桁数の違いで誤動作します。
関連キーワード: 安定ソート, 二次キー, クイックソート, 辞書式順, 復元処理

